Pesquisadores de segurança alertam que conteúdo sexual explícito gerado por IA sem consentimento segue se espalhando sem controle, com compartilhamento em mensagens diretas e armazenamento em nuvens privadas, o que dificulta detecção e denúncia. Um estudo coautorado pela Google com usuários da internet nos Estados Unidos, Austrália e Reino Unido, publicado em julho, aponta que o ponto de intervenção mais crítico está na origem das ferramentas usadas para criar as imagens falsas.
Em testes recentes, pesquisadores do White Circle afirmam que guardrails de geradores de imagens de texto de Google e OpenAI podem estar falhando à medida que os modelos ficam mais capazes. Um preprint divulgado no mês passado descreve vulnerabilidades em DALL·E 3, Nano Banana 2 e GPT-Image-2, com a equipe dizendo que, usando ferramentas disponíveis publicamente e chamadas via API, conseguiu gerar conteúdo explícito cerca de 13% das vezes.
O Wellhub revelou o Panorama do Bem-Estar Corporativo 2027 e indica que a adoção de inteligência artificial pode aumentar a carga de trabalho para quem já domina a tecnologia. No Brasil, 37% dos trabalhadores “avançados em IA” relatam que o uso da ferramenta elevou o volume de tarefas, ante 13% entre quem está nos primeiros estágios de adoção. O levantamento também mostra que, no recorte brasileiro, oito em cada dez usuários avançados orientam outras pessoas sobre as ferramentas.
Os dados ainda apontam diferenças nos relatos de esgotamento: 23% dos profissionais mais avançados dizem ter sintomas de burnout diariamente, contra 11% dos iniciantes. A pesquisa destaca que políticas claras e bem comunicadas sobre IA se associam a maior resiliência, e que 75% dos usuários avançados citam recursos de bem-estar como apoio para se adaptar ao ambiente impulsionado pela tecnologia. O estudo foi conduzido entre 12 e 19 de junho de 2026 com mais de 5 mil profissionais em dez países.
O pendant Friend 2, chatbot em formato de pingente sempre “listening”, chegou em julho custando US$ 249 e usa os “latest language models” da OpenAI. O dispositivo responde a comandos e também pode falar sem ser provocado, com um recurso de “silenciar” que exige toques no aparelho.
A Avi Schiffmann, criadora do Friend, afirmou que a próxima atualização vai tornar os chatbots mais “agentically” e mudar a personalização: em vez de personalidades únicas por usuário, todos conversariam com a mesma entidade, compartilhando contexto entre usuários. A proposta aponta para um “hivemind” do Friend, com mudanças que devem afetar como o sistema se comporta e como a privacidade é tratada.
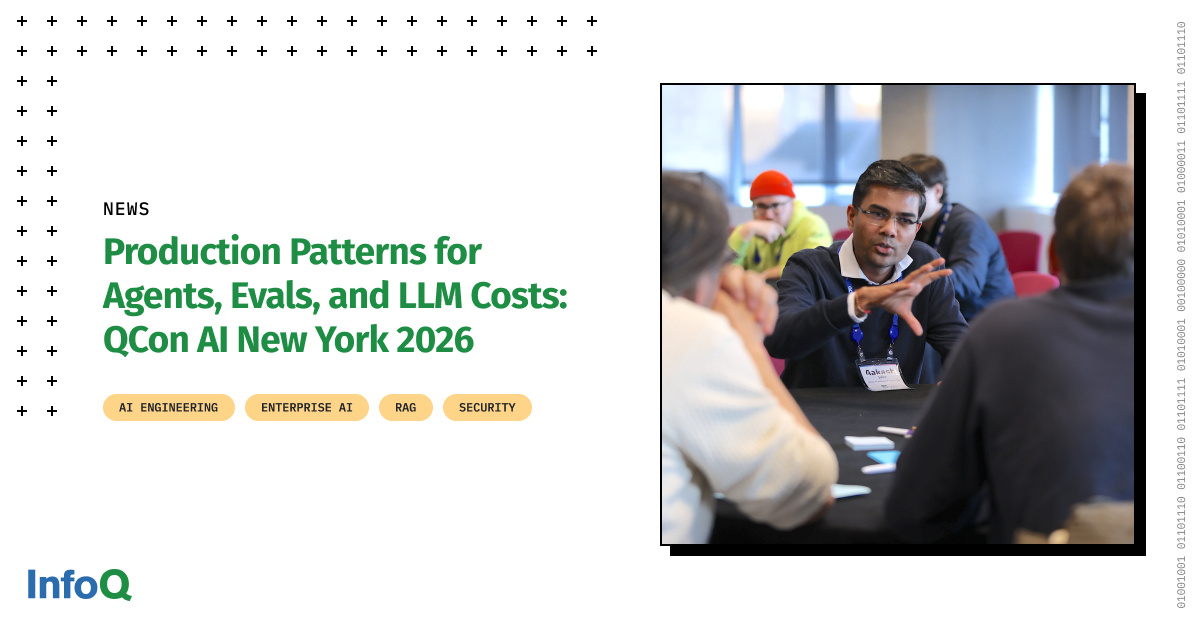
A QCon AI New York 2026 confirmou sessões com engenheiros sêniores que enfrentaram desafios de IA em produção, como revisão de código, aumento de custos por tokens, necessidade de evals confiáveis e definição de permissões e guardrails para agentes. O evento acontece em 15 e 16 de dezembro, no The Westin Jersey City Newport, com foco em decisões técnicas para IA em sistemas reais.
As palestras incluem abordagens para identidade e autorização de agentes em produção, com controles como rate limits e aprovações para mudanças, além de um “eval loop” para conectar resultados simulados ao que acontece em produção. Também há discussões sobre compressão e caching para reduzir custos de contexto de LLM, revisão de código assistida por IA em escala e como avaliar maturidade de IA além de métricas de adoção.
A Anthropic substituiu o Workbench, ferramenta de testes de prompts na Console de desenvolvedores, por Playground em 18 de agosto. A mudança vai além do nome: recursos como prompts salvos, histórico de versões, evals e compartilhamento em equipe foram removidos, e o novo Playground é stateless, sem armazenamento em servidores da empresa. Quem tinha dados no Workbench tem até 1º de setembro para exportar.
Em um teste comparando os dois ambientes, a Anthropic gerou uma revisão de PR em JSON com resposta correta já na primeira tentativa, usando o modelo claude-sonnet-5 e exportando diretamente para Python sem precisar editar a saída. Já no OpenAI, o Playground (chamado Chat) respondeu corretamente na primeira tentativa, mas a exportação falhou para o objetivo de rodar o bot: o arquivo gerado continha o transcript e a resposta anterior, e o código exportado não retornou nada novo sem ajustes manuais.
Uma equipe da Brex descreveu um padrão para construir workflows de IA que funcionam tanto em produção quanto em rotinas de avaliação (evals) offline. A ideia é separar a “lógica de orquestração” (passos, ordem e ramificações) do runtime: a mesma lógica roda sem mudanças em ambientes duráveis e também em loops leves para testar centenas de variações. O artigo explica por que engines focadas em execução durável (com persistência e replay) tornam as evals caras e lentas, enquanto harnesses leves não garantem resiliência para agentes longos.
Na prática, isso reduz bugs causados por divergência entre o que foi avaliado e o que vai para o ar—já que existe apenas uma versão da lógica. Para devs, a arquitetura precisa “forçar” o caminho correto (build falha se alguém escrever código não-agnóstico) e aceitar um custo: a orquestração perde acesso direto a recursos nativos de cada runtime, exigindo uma camada intermediária para novas capacidades. O resultado é um fluxo mais confiável para ajustar prompts e modelos sem sacrificar estabilidade em produção.