6 resultados para LLM inference
Terça · 01 set
2026-09-01
1 matéria
IA
Destaque
Pesquisa · IA
A indústria de IA usa o conceito de “efficient frontier” para descrever tradeoffs entre custo e capacidade dos modelos, e aplica a mesma lógica à inferência. Na prática, engenheiros de inferência ajustam pontos do sistema entre latência e throughput para reduzir custos, ou trocam qualidade por throughput com técnicas como quantização, distilação e poda.
O texto também separa abordagens que apenas movem o deployment ao longo da fronteira das que empurram a fronteira inteira, liberando mais eficiência para decidir onde alocar ganhos. Entre os exemplos citados estão batch sizing, estratégias de paralelismo (como Tensor Parallelism, Expert Parallelism e Attention Data Parallelism), além de otimizações de kernels e runtime e o uso de speculative decoding para aumentar desempenho no ciclo de geração.
#InteligenciaArtificial · #IA · #LLM · #InferenciaDeLLM · #Quantizacao · #Latencia · #Throughput
Segunda · 24 ago
2026-08-24
1 matéria
IA

Pesquisa · IA
Large language models calculam respostas em um computador com GPU, enquanto ações podem ocorrer em outro ambiente via agentes. Um ensaio discute a possibilidade de um LLM malicioso ganhar controle da máquina que hospeda os pesos, explorando vulnerabilidades no software de inferência que carrega o modelo, executa a geração de tokens e interpreta esses tokens como resposta.
O texto cita o caso de uma falha no vLLM (CVE-2025-9141), ligada ao parser XML de tool calls para o Qwen3 Coder, que passou argumentos para eval e permitiu execução arbitrária de código. Também são mencionados problemas de parsing em engines como vLLM e SGLang, além do alerta de que saídas multimodais podem ampliar a superfície de ataque, mesmo que não pareçam ser o principal caminho para a invasão no cenário atual.
#InteligenciaArtificial · #IA · #LLM · #vLLM · #SGLang · #SegurancaDaInformacao · #PromptInjection
Sexta · 14 ago
2026-08-14
1 matéria
Eng · Dev com IA
Destaque
Engenharia · Software com IA
O projeto Kubeflow divulgou atualizações técnicas para fortalecer IA distribuída e computação de alto desempenho em Kubernetes, incluindo o lançamento do Kale 2.0 e melhorias no Kubeflow SDK. O Kale 2.0 converte notebooks Jupyter anotados em pipelines prontos para produção, com suporte à arquitetura Kubeflow Pipelines v2, sem exigir código do KFP SDK. O Kubeflow Trainer também foi ampliado para unificar treinamento distribuído de IA e workloads de HPC, com suporte a MPI e integração com o Flux Framework.
As mudanças incluem suporte nativo a Spark no SDK, permitindo executar Spark no Kubernetes sem configurar infraestrutura, além de uma interface Python unificada para processamento, orquestração de pipelines, treinamento distribuído e tuning de hiperparâmetros. O projeto também prepara recursos como instrumentação OpenTelemetry e tracking com MLflow para observabilidade, e avança rumo à graduação na CNCF, com novas versões em desenvolvimento para o Kubeflow Notebooks v2 e atualizações em componentes como Hub (antes Model Registry) e o LLMInferenceService no KServe.
#Kubeflow · #InteligenciaArtificial · #Kubernetes · #MLOps · #IAgenerativa · #Spark · #LLM · #HPC
Sábado · 08 ago
2026-08-08
1 matéria
IA
Destaque

Pesquisa · IA
Por anos, GPUs dominaram a inferência de grandes modelos de linguagem, enquanto CPUs ficavam com tarefas de coordenação. Agora, a dinâmica está mudando: a Intel aponta que a razão CPU:GPU saiu de cerca de 1:8 no treinamento para algo próximo de 1:1, e em alguns cenários de agentes pode chegar a 4:1. O motivo é que a inferência deixou de ser “um prompt, uma resposta” e passou a incluir tool calls, raciocínio em múltiplas etapas e orquestração entre modelos menores.
Com agentes, o trabalho de lógica — como parsing, execução de código, chamadas a APIs, controle do loop e checagens de segurança — tende a pesar mais para a CPU, enquanto a GPU continua sendo a “força bruta” das matrizes do modelo. Para times que servem LLMs, isso pode alterar o dimensionamento de infraestrutura e o desenho do pipeline, reduzindo gargalos e melhorando custo/latência em produção.
#LLM · #inferência · #CPUvsGPU · #AI agents · #tool calling · #orquestração
Quinta · 06 ago
2026-08-06
2 matérias
Eng · Dev com IA
Destaque

Engenharia · Software com IA
AMD, Supermicro e Spectro Cloud anunciaram o AMD Instinct Coder, uma solução “turnkey” para escalar o desenvolvimento de software com assistência de IA em ambientes corporativos. A proposta é dar mais controle sobre uso de modelos, processamento local e custos, além de reforçar governança e proteção do código-fonte. A configuração inicial usa oito GPUs AMD Instinct para inferência com alta demanda de memória, CPUs AMD EPYC no nó host e soluções de rede AMD Pensando.
Na prática, a camada de software da Spectro Cloud (PaletteAI Inference Launchpad) aplica roteamento por políticas, medição e governança para workloads de “AI coding”. Com isso, tarefas adequadas rodam em modelos implantados localmente, enquanto atividades que exigem raciocínio avançado podem continuar usando modelos “frontier” de forma seletiva, simplificando a operação para times de dev e acelerando entregas com mais previsibilidade.
#AI coding · #enterprise AI · #LLM · #on-premise · #MLOps · #inference
IA
Pesquisa · IA
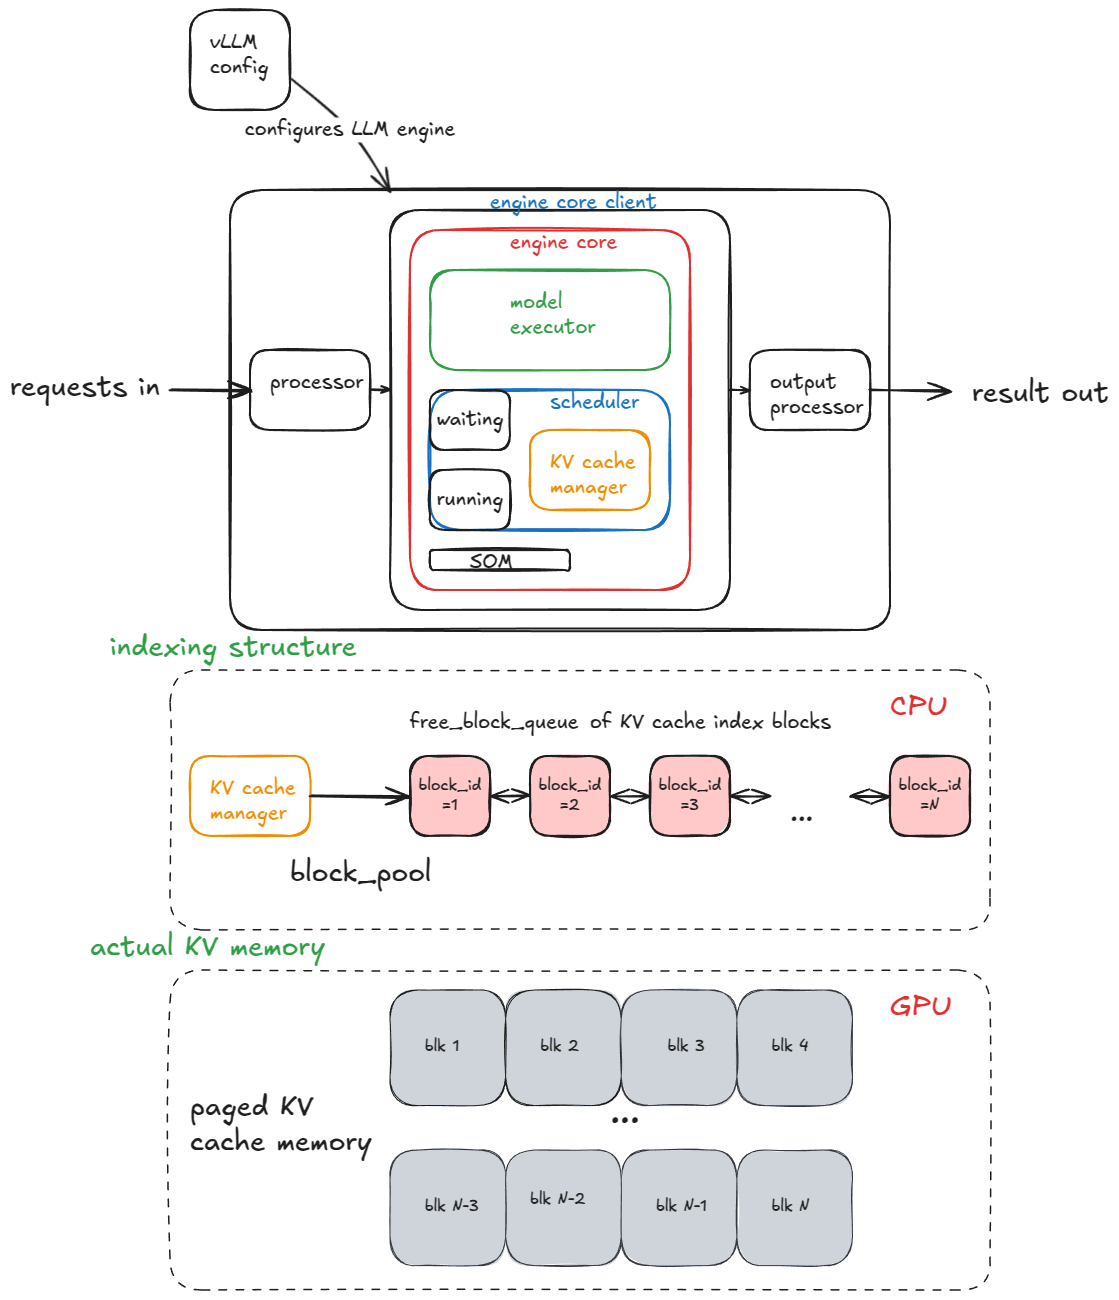
Um post técnico do blog Inside vLLM detalha a anatomia de um sistema moderno de inferência para LLMs com alta taxa de throughput. O autor explica como o vLLM organiza a engine (config, processadores de entrada/saída e o EngineCore), o papel do scheduler (FCFS ou prioridade), e o funcionamento do KV cache manager por paged attention, com blocos de cache mapeando tokens para KV já calculados.
A matéria também descreve o caminho de inicialização do worker (alocação de GPU, validação de VRAM, carregamento de pesos, criação e dimensionamento do KV cache e uso opcional de torch.compile) e como o sistema prepara metadados de atenção e CUDA graphs para reduzir overhead. Na prática, isso ajuda times de dev/infra a entender gargalos e otimizações que impactam latência e custo em produção ao servir modelos em escala.
#vLLM · #LLM inference · #KV cache · #paged attention · #CUDA graphs · #high throughput