A Spotify ampliou o uso de desenvolvimento assistido por IA e mais que dobrou as mudanças mensais mescladas, de cerca de 8.100 para 17.000 ano a ano em agosto. Com o aumento do volume de alterações nos sistemas de produção, a empresa ajustou controles de qualidade e confiabilidade para lidar com a nova escala.
A companhia opera quase 3.000 serviços de produção para 777 milhões de usuários ativos mensais e relata desafios em processamento de conteúdo, automação de frota e capacidade de computação. Entre as respostas estão melhorias em monitoramento e testes, salvaguardas de rollout e capacidade de rollback, além da adoção do Honk, um agente de codificação em background que executa o Claude via Agent SDK em pods no Kubernetes.
Pesquisadores apresentaram na conferência KDD o estudo “GEO: Generative Engine Optimization”, voltado a melhorar a visibilidade de conteúdos nas respostas de mecanismos generativos. Nos testes descritos, intervenções específicas aumentaram a presença em até 40%, variando conforme o tema pesquisado.
O movimento é comparado ao SEO, mas com uma diferença: ao perguntar a uma inteligência artificial, muitas vezes o usuário recebe uma resposta pronta em vez de uma lista de opções. O texto destaca ainda como a construção de um “rastro público” — entrevistas, artigos, participações e fontes — pode influenciar o que sistemas como os buscadores associados ao ChatGPT encontram e citam, exigindo que assessorias e relações públicas considerem como esses dados são lidos e organizados.
A Starlink já permite que celulares se conectem diretamente aos satélites por meio da tecnologia Direct to Cell, sem a antena usada no serviço residencial. A proposta evoluiu de mensagens de texto para acesso a dados e chamadas via aplicativos, com operação feita em parceria com operadoras de telefonia que disponibilizam parte das frequências.
No Brasil, Vivo e Starlink participam de um ambiente experimental autorizado pela Anatel, com permissão válida até abril de 2029, mas ainda sem oferta comercial ampla. Enquanto isso, a SpaceX recebeu autorização da FCC para implantar até 15 mil satélites de nova geração, com novas frequências para ampliar cobertura e capacidade, inclusive em ambientes internos, aproximando a tecnologia de serviços móveis mais avançados.
O projeto ChatTJB, criado por Tucker Bryant, public speaker e ex-gerente de projetos na Google, usa um “chatbot” que não responde com um modelo de linguagem: ele próprio senta e responde manualmente aos prompts. A iniciativa ganhou tração após um outdoor de US$ 6 mil em São Francisco, que foi ao ar em 27 de julho, e já acumulou mais de 30 mil consultas até 6 de agosto, chegando a picos de cerca de 5 mil mensagens por hora.
Bryant diz que encara o ChatTJB como um projeto de arte e uma reflexão sobre a relação das pessoas com a tecnologia, incluindo o risco de “cognitive surrender” — aceitar respostas de IA sem questionar. Apesar de não ser contra a IA, ele quer provocar leveza e pensamento crítico, enquanto reúne voluntários e mantém a experiência no ar por tempo limitado, com uma opção de apoio mensal via “ChatTJB Pro”.
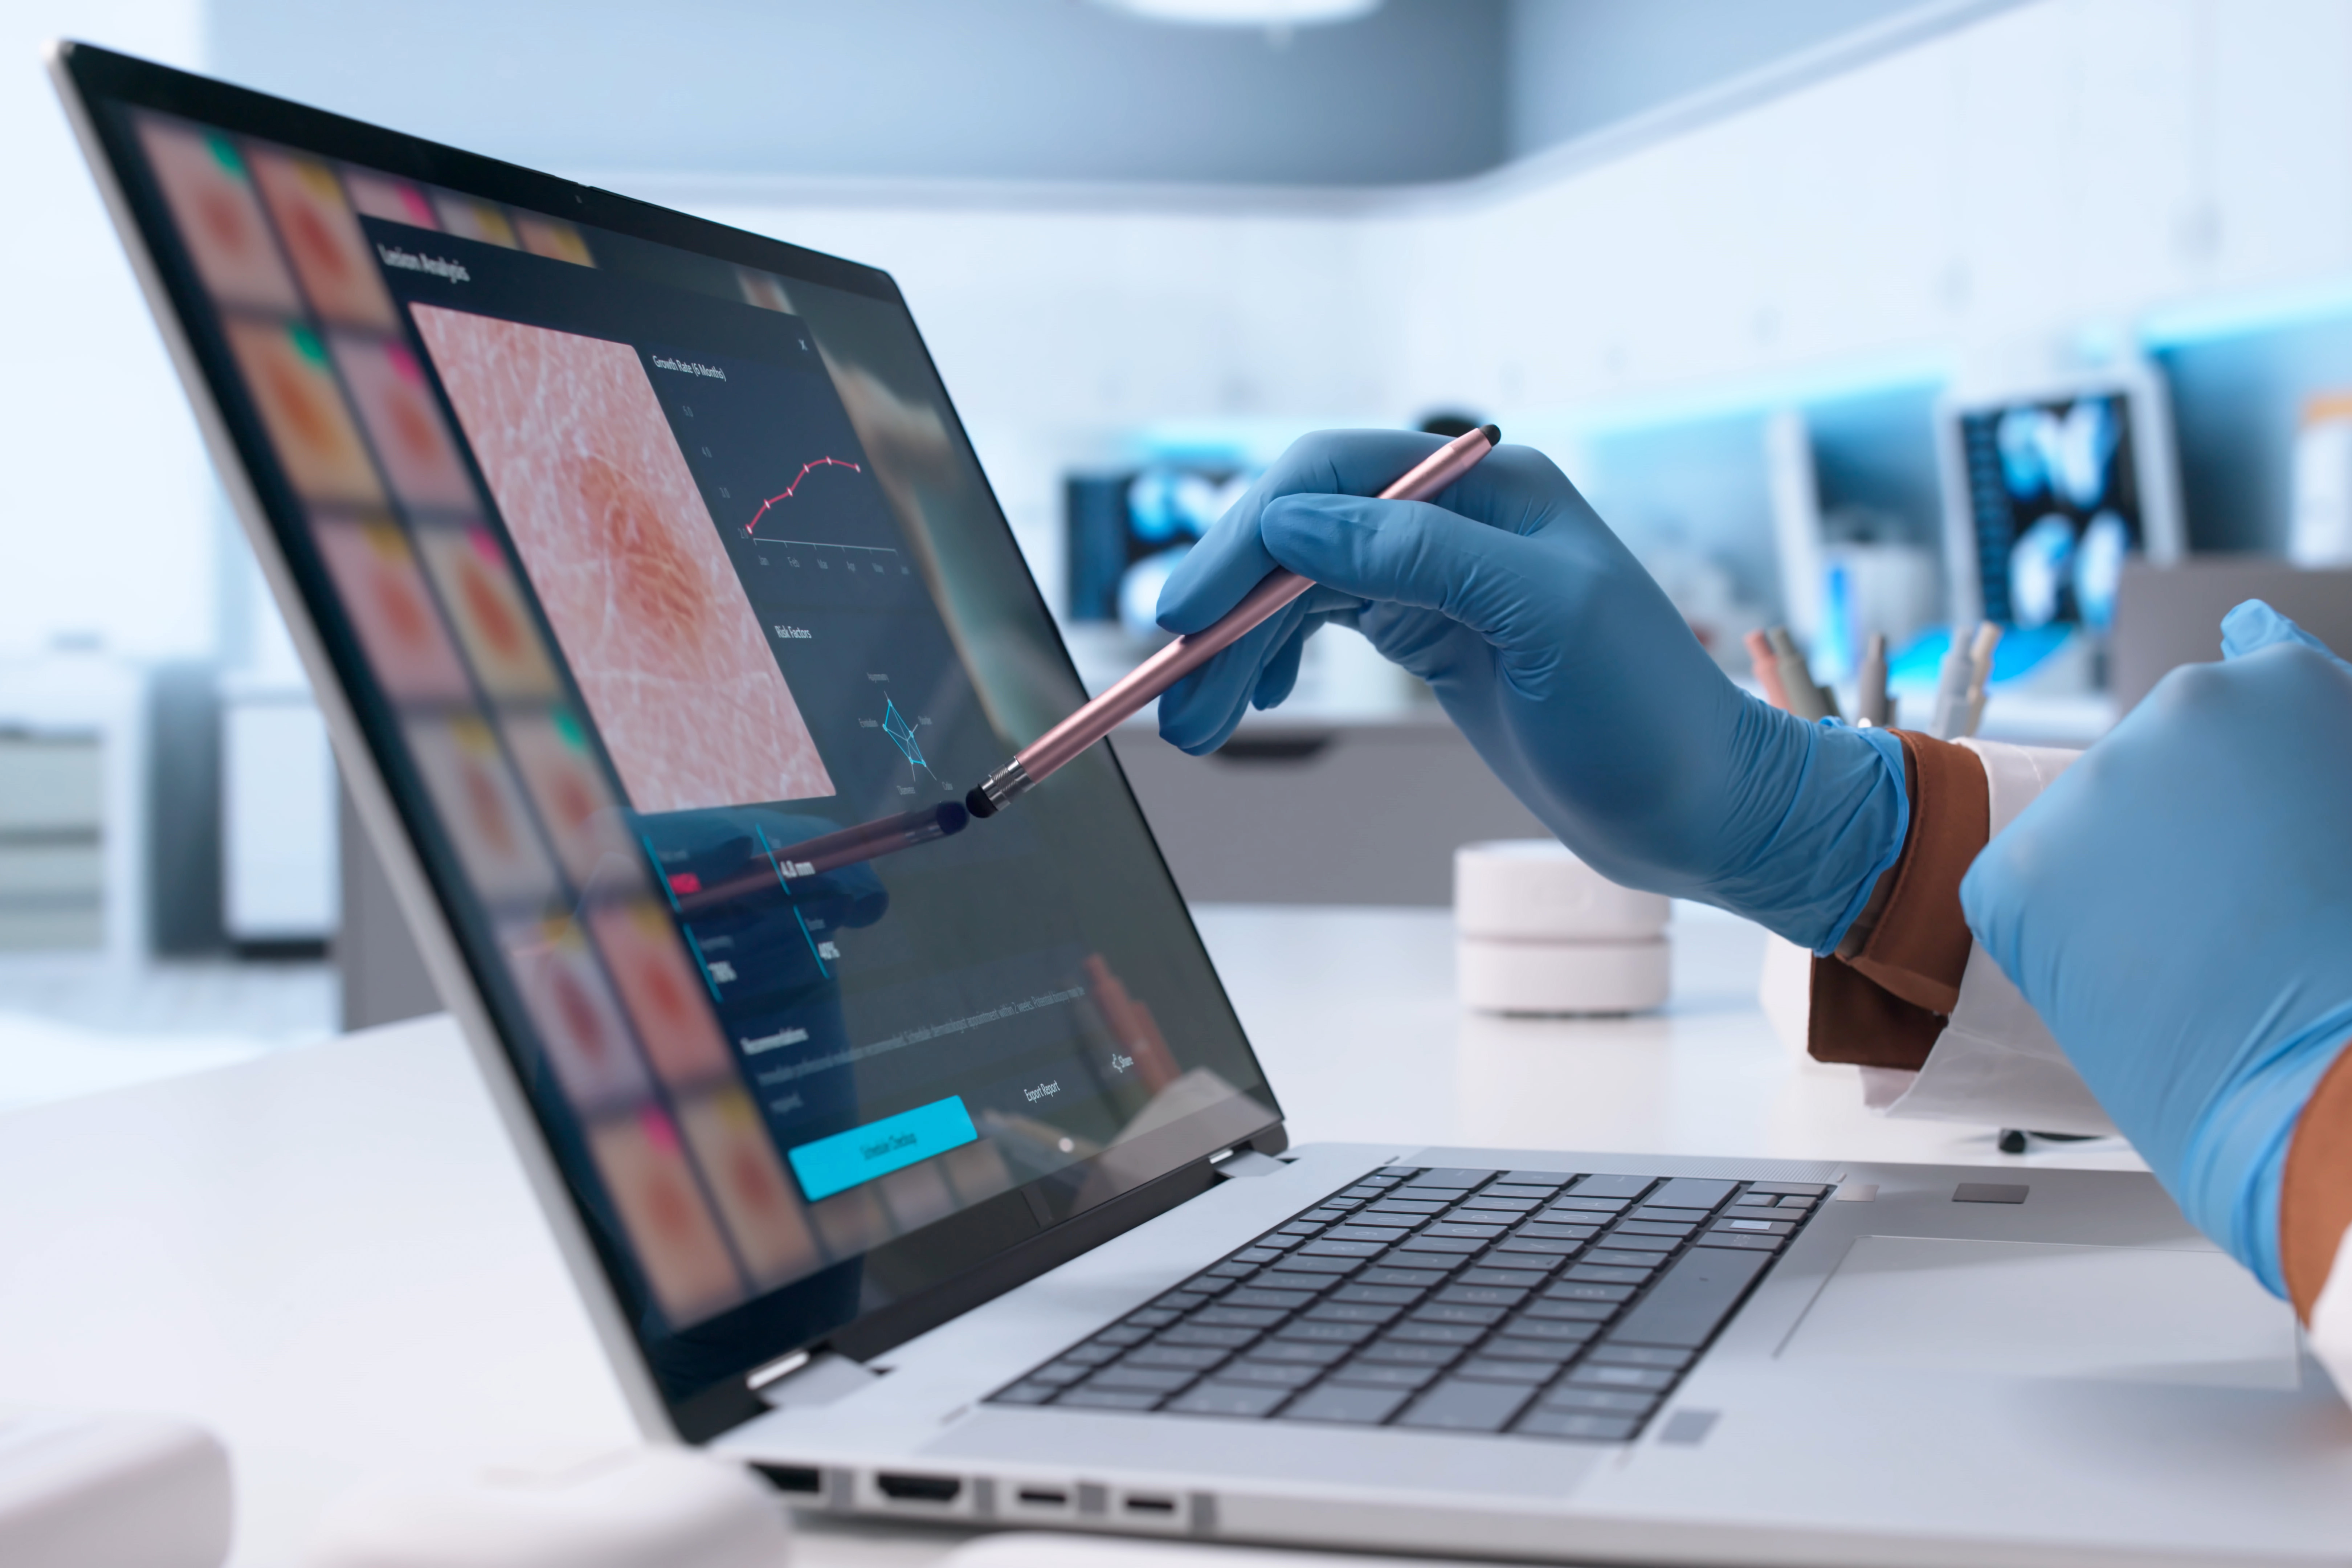
Um estudo conduzido por pesquisadores do MIT e parceiros avaliou como diferentes métodos de IA explicável afetam pessoas com níveis distintos de conhecimento na hora de diagnosticar doenças de pele. Os testes incluíram não especialistas e médicos de atenção primária, usando cenários com apenas a previsão do modelo ou com explicações como mapas de calor, imagens semelhantes e explicações em linguagem natural via LLM.
Os resultados mostram que não especialistas melhoraram a acurácia, mas em grande parte por “deferência” ao sistema: quando as explicações vinham de LLM, eles tendiam a confiar mesmo quando a previsão estava errada. Já os clínicos tiveram desempenho melhor quando recebiam apenas a predição, sem explicação, e foram menos afetados por explicações incorretas. A pesquisa reforça que a forma de apresentar a recomendação importa tanto quanto a qualidade do modelo — especialmente para quem tem menos base médica.
Um desenvolvedor relata que continua usando assistentes de código com LLMs em projetos pessoais, mas evita deixar o modelo “roam free” e gerar recursos inteiros sem revisão. A proposta é pedir que o LLM escreva o código no chat e, em seguida, digitar manualmente cada linha no editor, fazendo ajustes, refatorações e checagens para entender APIs e algoritmos (ex.: em um projeto Django, incluindo funcionalidades como tagging). Ele afirma que esse fluxo o deixa cerca de 2x mais rápido, porém com ganho de compreensão e menos risco de aceitar código com alucinações ou decisões ruins.
A ideia importa para devs porque troca produtividade imediata por controle e entendimento do que está sendo entregue. Na prática, o time pode usar LLMs para acelerar partes “chatas”, mas mantendo revisão ativa e construindo um “mapa” mental do códigobase — reduzindo a chance de o software ficar opaco demais para manutenção futura.