Modelos menores de inteligência artificial podem estar a poucos meses de conseguir se replicar em dispositivos conectados à internet sem ajuda humana, segundo alerta da Anthropic. A empresa testou essa capacidade em aparelhos como televisores com Android e eletrodomésticos inteligentes.
O avanço chama atenção para os riscos de disseminação automática de IA em ambientes do dia a dia, fora do controle direto de usuários. Com a replicação em dispositivos domésticos, cresce a necessidade de avaliar segurança e limites para esse tipo de tecnologia em produtos conectados.
A Meta anunciou a série de modelos de inteligência artificial Muse Wonder, com versões Muse Wonder e Muse Wonder Full, voltadas a executar tarefas complexas com mais autonomia. Os agentes contam com memória entre conversas e conseguem manter um objetivo mesmo diante de erros, com aplicações que vão de organização de finanças pessoais à análise de contratos e ao desenvolvimento de softwares.
O Muse Wonder já está disponível para desenvolvedores e criadores via Meta Model API e Muse Code, enquanto o Muse Wonder Full é exclusivo para assinantes do Muse Code. A Meta diz que os modelos usam Active Memory para recuperar informações relevantes de interações anteriores e Active Focus para perseguir objetivos, testar abordagens, corrigir erros e solicitar confirmação do usuário antes de ações importantes, além de reforçar segurança e proteção de dados.
Um engenheiro da OpenAI é acusado de esconder um dispositivo de gravação de áudio em um pedaço de papel higiênico e instalá-lo atrás de um monitor em uma sala de reuniões executivas em um escritório em São Francisco. Segundo uma queixa criminal tornada pública, Abdulrahman Alfozan teria passado semanas consultando um “productivity agent” e um chatbot de IA para planejar a operação, incluindo o uso de uma ferramenta interna para checar reuniões no local.
A acusação também afirma que ele teria usado uma conta de chatbot ligada à esposa para tirar dúvidas técnicas sobre a instalação do equipamento. Após uma varredura de contravigilância em 30 de setembro, a equipe de segurança da OpenAI encontrou o dispositivo e acionou o FBI, além de desativar gradualmente o acesso de Alfozan aos sistemas da empresa durante a investigação.
Um desenvolvedor retomou o reverse-engineering do driver do Apple Neural Engine (ANE) no chip M1 após três anos, dizendo que antes havia concluído que o bloco não era tão útil. Ele afirma que a arquitetura do ANE é “opinionada” demais para virar uma plataforma genérica e que um driver Linux não ampliaria a variedade de cargas de trabalho. Mesmo no macOS, o ANE é usado com frequência apenas para gerar prévias com upsampling no Finder.
Com a chegada do M5 (2025) e a proposta de “performance de LLM”, o autor aponta que as cores do ANE foram incorporadas às do GPU, sinalizando o fim do NPU standalone. Agora, o objetivo passa a ser mapear a arquitetura interna do ANE no M1 — incluindo compute, datapath, scheduler, memória e modelo de execução — para entender quais suposições sobre workloads de ML a Apple colocou em silício desde o A11 Bionic (2017) e como isso se conecta à mudança de NPUs focadas em CNN para GPUs executando transformers.
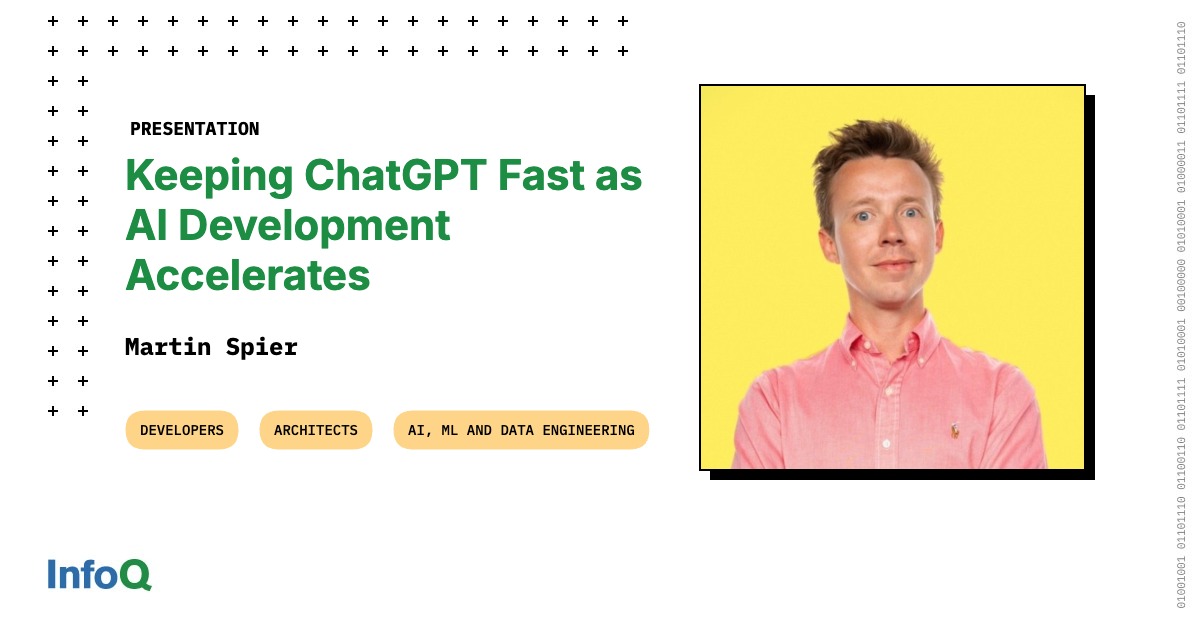
Martin Spier, líder do time de performance do ChatGPT na OpenAI, explicou no InfoQ como duas acelerações estão acontecendo ao mesmo tempo: crescimento explosivo de usuários e mudanças nas rotinas de desenvolvimento com “agentic coding”. Ele citou que empresas chegam a milhões de usuários mais rápido do que antes e que o volume de código/funcionalidades entregues aumenta com agentes, exigindo evolução das práticas de engenharia. Spier também trouxe números do ChatGPT: em fevereiro, a plataforma chegou a 900 milhões de usuários semanais ativos, e em um pico de geração de imagens, mais de 700 milhões de imagens foram criadas em apenas 7 dias por 130 milhões de usuários.
Com mais delegação de tarefas aos agentes, a equipe perde parte do controle detalhado sobre o que vai ser lançado — e isso pressiona a infraestrutura e a engenharia de performance. Na prática, o desafio passa a ser manter baixa latência, confiabilidade e eficiência mesmo com picos de demanda e mais “lógica” rodando no fluxo, adaptando práticas de performance engineering para acompanhar o ritmo de entrega.