A Spotify ampliou o uso de desenvolvimento assistido por IA e mais que dobrou as mudanças mensais mescladas, de cerca de 8.100 para 17.000 ano a ano em agosto. Com o aumento do volume de alterações nos sistemas de produção, a empresa ajustou controles de qualidade e confiabilidade para lidar com a nova escala.
A companhia opera quase 3.000 serviços de produção para 777 milhões de usuários ativos mensais e relata desafios em processamento de conteúdo, automação de frota e capacidade de computação. Entre as respostas estão melhorias em monitoramento e testes, salvaguardas de rollout e capacidade de rollback, além da adoção do Honk, um agente de codificação em background que executa o Claude via Agent SDK em pods no Kubernetes.
Pesquisadores apresentaram na conferência KDD o estudo “GEO: Generative Engine Optimization”, voltado a melhorar a visibilidade de conteúdos nas respostas de mecanismos generativos. Nos testes descritos, intervenções específicas aumentaram a presença em até 40%, variando conforme o tema pesquisado.
O movimento é comparado ao SEO, mas com uma diferença: ao perguntar a uma inteligência artificial, muitas vezes o usuário recebe uma resposta pronta em vez de uma lista de opções. O texto destaca ainda como a construção de um “rastro público” — entrevistas, artigos, participações e fontes — pode influenciar o que sistemas como os buscadores associados ao ChatGPT encontram e citam, exigindo que assessorias e relações públicas considerem como esses dados são lidos e organizados.
A Starlink já permite que celulares se conectem diretamente aos satélites por meio da tecnologia Direct to Cell, sem a antena usada no serviço residencial. A proposta evoluiu de mensagens de texto para acesso a dados e chamadas via aplicativos, com operação feita em parceria com operadoras de telefonia que disponibilizam parte das frequências.
No Brasil, Vivo e Starlink participam de um ambiente experimental autorizado pela Anatel, com permissão válida até abril de 2029, mas ainda sem oferta comercial ampla. Enquanto isso, a SpaceX recebeu autorização da FCC para implantar até 15 mil satélites de nova geração, com novas frequências para ampliar cobertura e capacidade, inclusive em ambientes internos, aproximando a tecnologia de serviços móveis mais avançados.
Um líder de engenharia aprovou um plano para contratar cinco engenheiros, investir em uma plataforma interna de IA e reorganizar duas equipes para acelerar a entrega de software. Seis meses depois, os desenvolvedores passaram a produzir mais código, mas a velocidade de entrega não aumentou: revisões de pull requests demoraram mais, filas de CI cresceram e a segurança precisou verificar mais mudanças.
O problema, segundo o texto, não é necessariamente falha no plano original, e sim o fato de a estratégia ter sido construída sobre um modelo de entrega que a IA alterou. A orientação é revisar “apostas longas” com frequência, alinhar métricas com evidências e criar sinais para detectar quando as condições que sustentavam a decisão deixam de valer.
A InfoQ vai realizar duas turmas de certificação online de cinco semanas em outubro de 2026: AI Security & Privacy Engineering, com início em 26 de outubro, e AI-Assisted Engineering, começando em 19 de outubro. O primeiro grupo foca em proteger dados sensíveis e testar controles de segurança em produtos de IA, usando threat modeling e red teaming. Já o segundo prepara verificações para coding agents que alteram um código existente, com criação de contexto, limitação de permissões e testes antes de levar as checagens para o CI.
As turmas incluem capstones em que os participantes avaliam uma arquitetura de produto de IA e explicam riscos, controles e como seriam testados, além de apresentarem um harness para validar mudanças feitas por agentes. A metodologia também prevê comparação de resultados registrados ao longo das cinco semanas com previsões iniciais, com grupos de pares para discutir decisões e a eficácia das checagens no fluxo de engenharia.
A recuperação de dados segue como um dos desafios centrais em sistemas de IA, e a chegada de agentes eleva a exigência sobre a infraestrutura de busca. Agentes fazem consultas em alta velocidade, dividem perguntas complexas em buscas paralelas e precisam de um mecanismo de retrieval que acompanhe o ritmo sem custos proibitivos.
A Chroma, conhecida pelo ChromaDB e pelo paper Context Rot, lançou o Context One, um subagente de retrieval com 20 bilhões de parâmetros. O modelo foi treinado para realizar busca agentic com qualidade de nível “frontier”, mas com custo e velocidade melhores, e a empresa discute em entrevista a origem do ChromaDB e a evolução do entendimento sobre “context rot”.
Ferramentas de IA permitem que a criação de um site, a automação de tarefas ou o desenvolvimento de aplicativos comece com uma descrição do que se quer construir, sem exigir que a pessoa escreva todo o código. Nesse contexto, transformar uma ideia em instruções claras passa a pesar mais no processo. Em 2025, o movimento ganhou o nome de vibe coding, popularizado por Andrej Karpathy, cofundador da OpenAI, ao descrever a prática de criar software conversando com uma IA.
Na abordagem, a pessoa acompanha menos detalhes da programação e foca em explicar o objetivo, testar o resultado e pedir mudanças, mas a qualidade final depende da orientação. Instruções abertas, como “faça um aplicativo de controle financeiro”, geram ambiguidades sobre dados, telas, acesso e tratamento de erros, enquanto comandos mais detalhados ajudam a reduzir incertezas. A divisão do trabalho muda: humanos definem o problema e os critérios de sucesso, e a IA executa parte da implementação, mantendo a necessidade de revisão e julgamento em projetos com dados sensíveis ou grande escala.
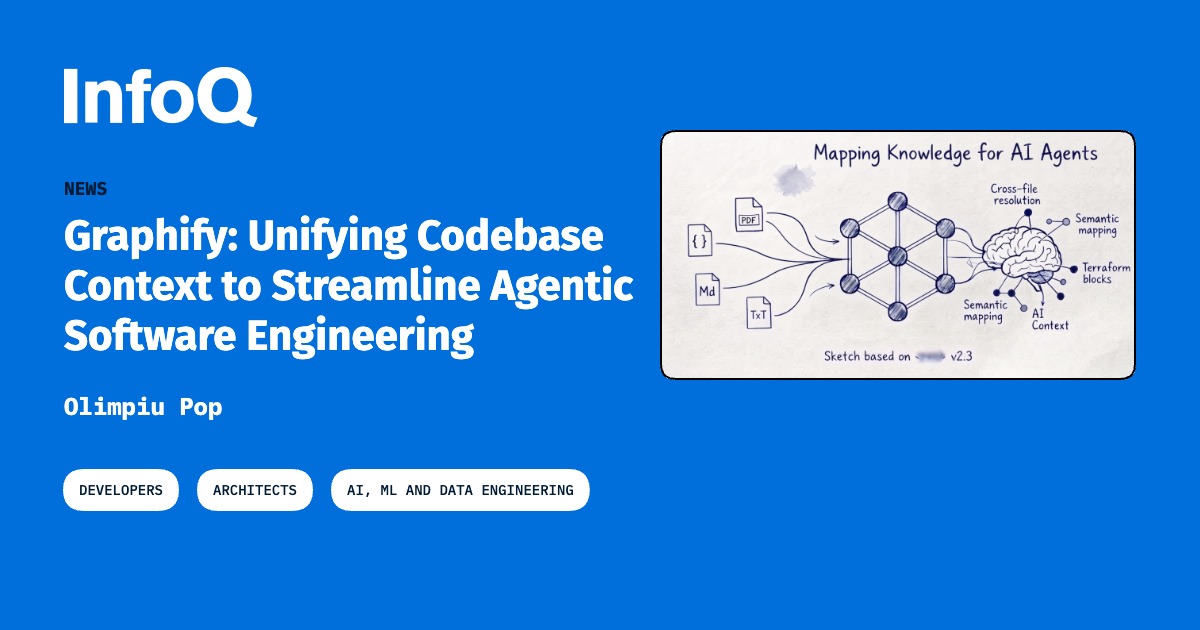
O Graphify, ferramenta open source lançada em abril de 2026, transforma codebases, documentos e dados não estruturados em knowledge graphs multimodais consultáveis para otimizar fluxos de engenharia com IA. O projeto, licenciado sob MIT e Apache-2.0, segue um ritmo acelerado de atualizações semanais e já ganhou milhares de estrelas no GitHub nos primeiros 10 dias.
A ferramenta ataca limitações de contexto e memória de agentes de coding ao extrair elementos estruturais via AST com tree-sitter e combinar sinais semânticos de documentação para construir um grafo unificado. As melhorias recentes incluem preservação avançada de atributos de blocos do Terraform e resolução de métodos entre arquivos, além de integração com assistentes via servidores MCP para reduzir tokens em comparação à leitura ingênua de arquivos.
Lauren Tan, engenheira do time Grok na SpaceXAI, compartilhou o workflow do seu agente pessoal, o pstack, que permite enviar 2.000 pull requests por mês para produção com alta confiança. Com isso, um único engenheiro chega a quase 100 PRs por dia útil, e as mudanças de fato chegam ao ambiente final, não ficam apenas no código.
No centro do processo está a verificação: um “skill” que checa o próprio trabalho e mantém o agente trabalhando até a tarefa estar concluída. Para isso, o agente precisa de um runtime rico que ele possa iniciar, inspecionar e obter respostas estruturadas; em sistemas distribuídos, a verificação exige ambientes que suportem muitos testes em paralelo sem interferência entre mudanças.
Um engenheiro do LinkedIn descreveu como a empresa usa “context engineering” para criar uma camada de contexto organizacional que ajuda agentes de IA a depurar incidentes em serviços críticos. No exemplo, um alerta de aumento de latência é enviado a um coding agent como o GitHub Copilot, que busca instruções, analisa logs, métricas e mudanças recentes e identifica a causa em um serviço downstream com muitos erros.
O agente também gera um resumo detalhado com a raiz do problema e os próximos passos, atualiza o sistema de incidentes e cria uma PR para mitigar a falha. Segundo o relato, o fluxo ocorre em poucos minutos e substitui tarefas que levariam horas, apoiado por “Contextual Agent Playbooks and Tools” e por centenas de workflows automatizados.
Uma apresentação sobre complexidade e criatividade na engenharia de software usa exemplos como o “J Incunabulum”, um interpretador completo escrito em C em 1989, e linguagens como APL e expressões regulares para discutir o conceito de “write-only code”. A fala cita que esse tipo de código é tão denso e arcano que dificilmente pode ser compreendido ou modificado por outras pessoas (ou até pelo próprio autor). O palestrante também relaciona a ideia à era de IA, argumentando que, nesse contexto, o código tende a funcionar como “write-only”.
A apresentação destaca dois princípios para lidar com essa complexidade: os testes passam a definir o comportamento e funcionam como documentação, mostrando pares de entrada e saída; e o código pode ser tratado como descartável, já que depurar trechos muito densos pode ser mais difícil do que reescrevê-los. Com isso, a manutenção e a evolução do software ficam mais dependentes de cobertura de testes e de ciclos de reimplementação quando necessário.
O InfoQ Engineering Culture Podcast reuniu Shane Hastie com Elisabeth Hendrickson e Joel Tosi para discutir systems thinking como lente para a entrega de software. O episódio aborda como líderes e times podem atuar com “levers” culturais, incluindo mudanças de política definidas pela liderança e “feeding” cultural influenciado por comportamentos do dia a dia.
Os convidados destacam que mudanças reais começam ao observar como o trabalho acontece na prática, e não como ele aparece em dashboards. Também ressaltam que, em sistemas adaptativos, o contexto muda continuamente — então ações que funcionam hoje podem falhar amanhã — e que construir organizações sustentáveis exige cuidado constante e ajustes de rota.
A Vercel apresentou o eve, um framework open source e cloud-native para rodar agentes de IA com mais confiabilidade em escala. Em vez do modelo tradicional de uma única sessão por usuário, o eve foi desenhado para lidar com milhares de requisições simultâneas, mantendo sessões isoladas, duráveis e recuperáveis.
No eve, o agente é definido de forma declarativa por arquivos de configuração, que são compilados em infraestrutura como código para provisionar apenas o que o agente realmente usa. A iniciativa também foi discutida em um episódio com Andrew Barba e Shar Dara, reforçando a visão de que “construir empresas” está se aproximando de “construir agentes”.
Bancos de dados, antes focados em armazenar dados e devolver resultados exatos, estão sendo pressionados a lidar com a forma como a IA consulta informação. Com aplicações que combinam dados estruturados e não estruturados, o modelo passa a se aproximar de busca, em que relevância e ranking ganham peso e os resultados nem sempre são estritamente exatos.
A conversa também destaca o avanço de agentes que escrevem consultas e até propõem schemas, o que intensifica debates sobre como dados devem ser estruturados, governados e considerados confiáveis. Sailesh Krishnamurthy, VP de Engenharia da Google, discute a evolução dos bancos de dados ao longo de décadas e para onde o setor caminha com a IA reorganizando consulta, estrutura e confiança.
Repetir a mesma pergunta em um LLM pode gerar cobranças a cada resposta, mesmo quando nada mudou. A proposta é criar uma chave de cache por “fingerprint” dos insumos e dependências (request, contexto, configurações do modelo e dados subjacentes) e reutilizar a resposta quando ela continuar válida e segura.
O texto descreve uma estratégia em três níveis: cache exato com normalização e hash SHA-256 em um store como Redis; cache semântico com embeddings e busca por similaridade (com limiar de cosseno entre 0,90 e 0,95, ajustável); e um modelo híbrido que tenta o exato primeiro e só faz a busca semântica em caso de “miss”. Em ambos os casos, a chave precisa considerar contexto, versão de fontes e escopo de acesso para evitar reutilização incorreta entre usuários e documentos diferentes.
O gasto com inteligência artificial no setor de tecnologia saltou de cerca de US$ 1.500 para US$ 44.000 no intervalo de 12 meses, um aumento de quase 28 vezes, segundo o DX’s State of AI Impact in Engineering Report. Apesar do salto nos investimentos, a parcela do trabalho de engenharia dedicada a novas features permaneceu em torno de 58%, indicando que a capacidade extra gerada por IA não está virando inovação.
O levantamento também aponta que apenas 6% dos executivos conseguem identificar o ROI de IA, enquanto 90% das organizações já pagam por modelos de IA, com uso que sai da experimentação. A recomendação é acompanhar o “innovation ratio” e reinvestir a capacidade liberada em descoberta, experimentação, redução de dívida técnica e novos produtos, evitando que o ganho seja absorvido por gargalos e overhead do processo.
A NVIDIA aparece em destaque em um episódio do Software Engineering Daily ao tratar de uma aquisição reportada de US$ 12,9 bilhões da Hugging Face. O programa também comenta negócios como o acordo de quase US$ 1 bilhão da Dynatrace para a plataforma de observabilidade de IA Arize e uma possível rodada de captação da Temporal em uma avaliação de US$ 12 bilhões.
O episódio ainda explora a economia de “transfer station” na China, que oferece acesso barato a modelos de fronteira oficialmente banidos no país, incluindo táticas como “one fish, three meals” (credit farming) e troca silenciosa de modelos. A conversa conecta esse fluxo de saídas capturadas e rastros humanos ao aumento de modelos open weight de alta qualidade, além de mencionar a mudança da Meta após pausar o Llama e direcionar esforços à família Muse.
A Meta tentou reduzir equipes de engenharia com a adoção de “AI pods” — grupos menores de 3 a 5 pessoas apoiados por ferramentas e agentes de IA. Em um dos resultados divulgados, as mudanças de código nas plataformas internas teriam subido 220% ano a ano, mas o avanço em recursos entregues aos usuários cresceu apenas 36%. Ao mesmo tempo, incidentes técnicos e de segurança aumentaram 40%, e o tempo gasto pelos funcionários apagando “incêndios” subiu 70%.
Em uma análise com mais de 500 organizações, a taxa de pull requests teria aumentado 37% ao longo de quatro trimestres, enquanto o Developer Experience Index caiu de 67 para 65. A conclusão é que produzir mais código não garante mais valor, já que revisões, testes, deploy e operação podem virar gargalos. A recomendação é que o “right-sizing” de equipes (em geral, de 5 a 8 pessoas) seja feito por último, com experimentos incrementais de baixo risco para identificar tarefas que podem ser delegadas a agentes de IA.
Adam Wachtel, CTO da Click Boarding, defendeu que a contratação de engenheiros deve priorizar personalidade e mentalidade de resolução de problemas, e não apenas o “skillset” técnico. Ele também destacou que dar autonomia para que os engenheiros decidam como resolver um problema, dentro de parâmetros e do stack definido, ajuda a manter o time engajado no longo prazo.
Wachtel afirmou ainda que a forma como as equipes são montadas pode reduzir o impacto de reestruturações durante crescimento ou aquisições, ao “cross-pollinar” engenheiros por diferentes partes do stack. No podcast, ele mencionou que a IA está mudando tamanho e composição das equipes, sem necessariamente eliminar o modelo SaaS.
A Shopify apresentou o Gisting, uma técnica para comprimir prompts longos de LLM em um conjunto menor de tokens “gist” aprendidos, com foco em aumentar o throughput e reduzir o custo de inferência. A empresa afirma que, durante o uso, a substituição do texto extenso por gist tokens reduz a latência ponta a ponta e melhora a taxa de processamento sem alterar os pesos centrais do modelo.
No Sidekick, o sistema prompt caiu de cerca de 6.000 tokens para 1.500 gist tokens, mantendo a qualidade das previsões. Com 350 requests por minuto, o tempo para o primeiro token (TTFT) passou de 438 ms para 354 ms, a latência end-to-end caiu de 6,8 s para 4,2 s e o throughput subiu de 20,2 para 23,4 QPS, permitindo reduzir a alocação de GPUs.
A Pinecone desenvolveu o Nexus, um knowledge engine que trata o contexto como um ativo pré-computado, em vez de montá-lo sob demanda durante o uso de modelos. A proposta mira limitações do RAG tradicional, como buscas em bases vetoriais que podem trazer trechos pouco relevantes, repetição do trabalho de recuperação a cada consulta e respostas inconsistentes para a mesma pergunta.
O Nexus organiza o contexto como um artefato versionado, com schema, metadados, permissões e linhagem, inspirado no conceito de materialized view. Em conversa com o podcast Software Engineering Daily, Jörg Schad, VP de Engenharia da Pinecone, detalhou como esse contexto pré-compilado é curado e versionado, e como camadas de metadados e semântica ajudam agentes a selecionar as informações mais adequadas.
O GitHub Podcast reuniu Marlene Mhangami, GPS e o time do GitHub para destrinchar termos de IA que estão entrando no desenvolvimento de software, como loop engineering, Ralph loops, squads, harness engineering e hill climbing. A conversa também abordou conceitos como forward deployed engineer e as diferenças entre closed models, open weights e open source models.
Loop engineering, por exemplo, propõe criar sistemas repetíveis para agentes em vez de prompts pontuais, com validação e escalonamento quando algo “trava”. Já squads e fleets descrevem fluxos com múltiplos agentes em papéis diferentes ou em paralelo, enquanto harnesses são o conjunto de ferramentas, permissões, memória e orquestração que colocam o modelo para funcionar; hill climbing entra como a prática de melhorar agentes e harnesses com feedback e evals.
Redis está usando engenharia de contexto para viabilizar aplicações com LLM em cenários com restrições reais de tempo. Em uma apresentação, Ricardo Ferreira contou como desenvolveu o Agent Memory Server (AMS), um projeto open source para criar camadas de memória de curto e longo prazo sobre Redis, com foco em permitir conversas mais naturais.
Para testar o AMS, ele criou a skill “My Jarvis” para Alexa, com respostas limitadas por um timeout fixo de 8 segundos. A arquitetura inclui uma função Lambda no backend, o SDK da Alexa e o LangChain4j (Java), que orquestra o acesso a um LLM via OpenAI, enquanto o desenvolvimento enfrenta problemas como context poisoning, distração por excesso de dados, confusão e “context rots”.
A verificação de idade está mudando o acesso à internet ao exigir, em alguns casos, documentos de identidade, estimativa facial da idade ou inferência baseada em comportamento antes de entrar em espaços digitais. Leis em expansão têm puxado plataformas como Discord, lojas de aplicativos, redes sociais e até chatbots de IA para essas exigências, geralmente justificadas como proteção a crianças.
Por trás do objetivo declarado, surgem debates sobre privacidade, anonimato, segurança e limites entre o que uma plataforma decide e o que o governo pode compelir. O episódio destaca ainda riscos de vazamentos e de vigilância associados a essas exigências, além do que engenheiros e empresas devem considerar ao construir sistemas de verificação.
Um “gap” entre o que empresas gastam com inteligência artificial e o valor duradouro que conseguem capturar está no centro do debate do setor. Apesar da adoção entusiasmada de assistentes de código e chatbots por funcionários, os ganhos ainda não se traduzem em transformação no nível organizacional.
Emily Xue, Head de Enterprise AI na Scale AI, participa de um episódio do Software Engineering Daily para explicar por que a IA pode estar “travando” em empresas e quais fatores separam as poucas organizações que obtêm resultados das que não conseguem. Ela aborda camadas em que a adoção falha, limitações de benchmarks de modelos de fronteira e o problema da base de dados, além de como empresas combinam expertise interna com especialistas externos.
A Anthropic substituiu o Workbench, ferramenta de testes de prompts na Console de desenvolvedores, por Playground em 18 de agosto. A mudança vai além do nome: recursos como prompts salvos, histórico de versões, evals e compartilhamento em equipe foram removidos, e o novo Playground é stateless, sem armazenamento em servidores da empresa. Quem tinha dados no Workbench tem até 1º de setembro para exportar.
Em um teste comparando os dois ambientes, a Anthropic gerou uma revisão de PR em JSON com resposta correta já na primeira tentativa, usando o modelo claude-sonnet-5 e exportando diretamente para Python sem precisar editar a saída. Já no OpenAI, o Playground (chamado Chat) respondeu corretamente na primeira tentativa, mas a exportação falhou para o objetivo de rodar o bot: o arquivo gerado continha o transcript e a resposta anterior, e o código exportado não retornou nada novo sem ajustes manuais.
A Roblox apresentou o esforço “Prompt to Prod” para levar o desenvolvimento de software a um fluxo mais autônomo, indo de um prompt até a produção sem intervenção humana. A empresa diz que já avançou na geração de código, mas ainda enfrenta a “lacuna de confiança”, que aumenta a pressão sobre engenheiros e pode elevar o risco de incidentes (SEVs) durante depuração.
Nos últimos seis meses, a transição citada vai de recursos mais avançados de autocomplete para agentes capazes de rodar tarefas maiores, como reestruturar partes do código e entregar funcionalidades de ponta a ponta. O caminho envolve criar guardrails e infraestrutura de confiança, com foco em alinhamento, segurança e acesso para permitir que agentes executem fluxos reais sem comprometer a empresa.
Desenvolvedores da SpareBank 1 Utvikling, empresa que cria soluções digitais para 12 bancos, detalharam em podcast como evoluíram as práticas de engenharia após experiências com deployment contínuo e pair engineering. O foco do time é colocar tudo em produção várias vezes por hora, usando TDD e mob programming em tarefas como documentação e análise, sem trabalho isolado.
A conversa também abordou a adoção de Claude Code: o LLM é visto como bom para análise, visualização de telemetria e para iniciar tarefas, mas não para codar em ambientes complexos “brownfield”, onde falta contexto tácito. Para manter qualidade e coerência do sistema, o time reforça colaboração constante, com política de “sem pull requests externos”, e direciona o objetivo para “código fácil de mudar”, conectando o fluxo a princípios como alta coesão, baixo acoplamento e TDD.
A InfoQ abriu inscrições para o InfoQ Certified AI-Assisted Engineering Program, uma certificação online com foco em engenharia assistida por agentes de IA. O primeiro grupo acontece de 18 de setembro a 16 de outubro de 2026, às sextas-feiras às 9:00 AM PDT, por US$ 1.470, e o segundo vai de 19 de outubro a 16 de novembro de 2026, às segundas-feiras no mesmo horário.
O curso é voltado a engenheiros e arquitetos seniores que já executam um coding agent em código de produção diariamente, trabalhando em codebases com anos de histórico. A formação aborda o que um agente pode fazer, como identificar falhas e como comprovar para a organização que o código gerado é válido, escalável e sustentável, com sessões ao vivo que não são gravadas e certificação baseada em presença e entrega final.
Sistemas de seleção baseados em LLM estão sendo discutidos como uma forma de automatizar tarefas de procurement, como escolher o centro de custos responsável pelos custos. O fluxo tradicional com dados estruturados usava um dataset, treinamento e uma camada final de decisão; com LLMs, o desafio passa a ser transformar texto em IDs de banco de dados e integrar a saída do modelo aos sinais do sistema.
A apresentação também destaca limitações como janela de contexto restrita, risco de comportamento incorreto quando há histórico grande e necessidade de mitigar prompt injections, além de dificuldades de rastrear chamadas internas. Para reduzir variação, foi citado o uso de temperatura 0 e a criação de uma “regra 0” para remover randomness, enquanto o código e partes do material foram gerados com apoio de IA durante o desenvolvimento.
Um demo com Claude Code mostrou que colocar “tudo o que existe” em um arquivo como CLAUDE.md pode estourar o contexto e levar a falhas no comportamento do agente. No exemplo, ao adicionar tratamento de erro em um endpoint, o teste esperava 404 para um pedido ausente, mas retornou 500, com um AssertionError.
A conversa destacou que o problema não é só o modelo: o agente envia toda a sessão (chat, prompts e conteúdo anexado) para o LLM a cada interação, o que pode “encher” a janela de contexto. Para contornar isso, os palestrantes defendem substituir o prompt “engordado” por context engineering com skills, carregando documentos apenas quando gatilhos específicos indicam que aquele contexto é necessário.
Um relatório da DX, o “State of AI Impact in Engineering”, analisou organizações de engenharia em velocidade, efetividade, qualidade e impacto e encontrou um descompasso: apesar do investimento em IA ter crescido 28 vezes na maioria das empresas, métricas de velocidade (velocity) ficaram estagnadas e até caíram, especialmente em times com mais de 99 engenheiros. O deputy CTO da DX, Justin Reock, afirma que o custo subiu de forma exponencial, mas o ritmo de entrega não acompanhou.
O estudo também destaca tensões no Developer Experience Index (DXI), com manutenção de código melhorando, enquanto a “change confidence” piora — os times passam a confiar menos no que liberam em produção. Além disso, o tamanho médio das PRs (pull requests) aumentou de 42 linhas em julho de 2025 para 72 linhas um ano depois, e a entrega incremental foi o indicador que mais sofreu, sugerindo impacto na qualidade e na estabilidade das mudanças.
Organizações de engenharia estão vendo métricas de “adoção” dispararem — como ativações de assentos e gasto com tokens — mas, ao observar reuniões e rotinas, quase nada muda no processo de desenvolvimento. O texto critica que indicadores de uso (tokens, commits, “% de código gerado por IA”) medem atividade, não melhoria real do trabalho. Também destaca que “adoção” pode significar desde uso pontual até mudanças permanentes de workflow, sendo que só a última tende a sobreviver a prazos e troca de pessoas.
A implicação para times dev é direta: dashboards podem virar incentivo para “jogar o jogo” da métrica, sem garantir qualidade, entrega ou aprendizado. Em vez de focar em licenças e volume de uso, a recomendação é avaliar o que quebra se a ferramenta sumir, e tratar prompts e fluxos como artefatos versionados e revisados no repositório — além de definir com clareza o que pode ser delegado a agentes com checagem leve e o que exige revisão mais cuidadosa.