Por que seu LLM local parece “mais burro”: diferenças de inferência
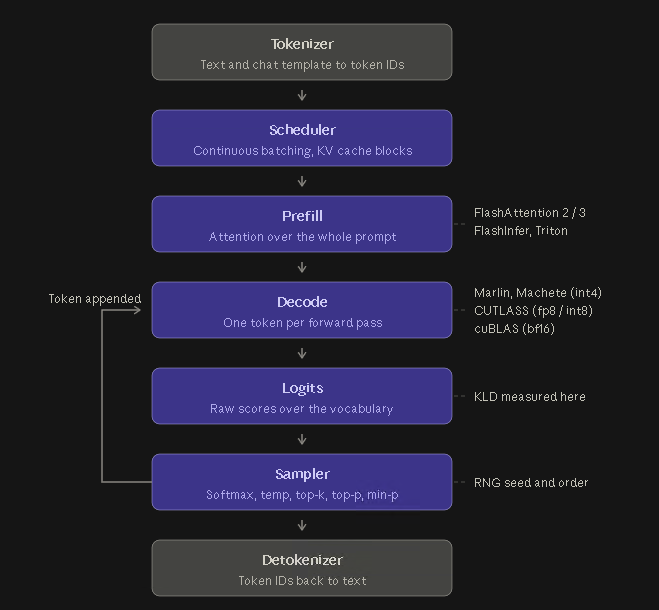
Usuários que baixam modelos locais, inclusive versões quantizadas, podem ter a impressão de que o LLM “fica pior” do que o esperado. O texto explica que cada combinação de hardware e software executa a inferência de forma diferente, alterando como as probabilidades do próximo token são calculadas e convertidas em texto durante o decode.
A recomendação é medir o desempenho com benchmarks que representem o uso real, evitando testes curtos e zero-shot com poucos prompts. Também é destacada a cautela com alegações de baixa KLD em cards de modelos quantizados, já que interpretar esses números depende de detalhes como ambiente de execução, checkpoints de referência e metodologia completa.
Hacker News
O texto acima é um resumo reescrito. A apuração, o texto integral e os créditos são da fonte — abra o original para ler na íntegra.
Ler matéria original ↗Resumo gerado por IA a partir da matéria original e revisto pelo método descrito em como funciona a curadoria. Em caso de divergência, vale o texto da fonte. Achou um erro? Fale com a gente.