A Spotify ampliou o uso de desenvolvimento assistido por IA e mais que dobrou as mudanças mensais mescladas, de cerca de 8.100 para 17.000 ano a ano em agosto. Com o aumento do volume de alterações nos sistemas de produção, a empresa ajustou controles de qualidade e confiabilidade para lidar com a nova escala.
A companhia opera quase 3.000 serviços de produção para 777 milhões de usuários ativos mensais e relata desafios em processamento de conteúdo, automação de frota e capacidade de computação. Entre as respostas estão melhorias em monitoramento e testes, salvaguardas de rollout e capacidade de rollback, além da adoção do Honk, um agente de codificação em background que executa o Claude via Agent SDK em pods no Kubernetes.
Pesquisadores apresentaram na conferência KDD o estudo “GEO: Generative Engine Optimization”, voltado a melhorar a visibilidade de conteúdos nas respostas de mecanismos generativos. Nos testes descritos, intervenções específicas aumentaram a presença em até 40%, variando conforme o tema pesquisado.
O movimento é comparado ao SEO, mas com uma diferença: ao perguntar a uma inteligência artificial, muitas vezes o usuário recebe uma resposta pronta em vez de uma lista de opções. O texto destaca ainda como a construção de um “rastro público” — entrevistas, artigos, participações e fontes — pode influenciar o que sistemas como os buscadores associados ao ChatGPT encontram e citam, exigindo que assessorias e relações públicas considerem como esses dados são lidos e organizados.
A Starlink já permite que celulares se conectem diretamente aos satélites por meio da tecnologia Direct to Cell, sem a antena usada no serviço residencial. A proposta evoluiu de mensagens de texto para acesso a dados e chamadas via aplicativos, com operação feita em parceria com operadoras de telefonia que disponibilizam parte das frequências.
No Brasil, Vivo e Starlink participam de um ambiente experimental autorizado pela Anatel, com permissão válida até abril de 2029, mas ainda sem oferta comercial ampla. Enquanto isso, a SpaceX recebeu autorização da FCC para implantar até 15 mil satélites de nova geração, com novas frequências para ampliar cobertura e capacidade, inclusive em ambientes internos, aproximando a tecnologia de serviços móveis mais avançados.
StemDeck é uma ferramenta de separação de áudio que permite importar arquivos como MP3, WAV, FLAC, OGG/Opus, MP4 e M4A — ou colar uma URL do YouTube — para dividir a faixa em até seis stems (vocais, bateria, baixo, guitarra, piano e outros). O processamento roda localmente no seu computador e não armazena, faz cache nem redistribui o conteúdo baixado.
A separação usa o modelo Demucs htdemucs_6s e detecta automaticamente o melhor dispositivo Torch (CUDA em NVIDIA, MPS em Apple Silicon ou fallback para CPU). O app traz um editor estilo DAW com mixer multitrack, waveform com zoom e loop, exportação de stems e análise musical com BPM, tom/escala e loudness (LUFS), além de permitir cancelar jobs no meio do pipeline.
A Nvidia anunciou memorandos de entendimento com seis grandes gestoras de ativos para mobilizar mais de US$ 500 bilhões em capital de terceiros voltado à construção de infraestrutura de inteligência artificial (IA). Os parceiros são Apollo, BlackRock, Blackstone, Brookfield, Goldman Sachs e KKR, e a empresa afirmou que o valor não envolve capital próprio da Nvidia.
Os acordos ainda não estão totalmente fechados e funcionam como etapa inicial antes da estruturação definitiva. O financiamento deve usar a capacidade computacional da Nvidia como garantia, com operações via ofertas privadas e títulos de entidades de propósito específico, enquanto a companhia não detalhou como os recursos serão divididos nem o papel exato da Nvidia em cada operação.
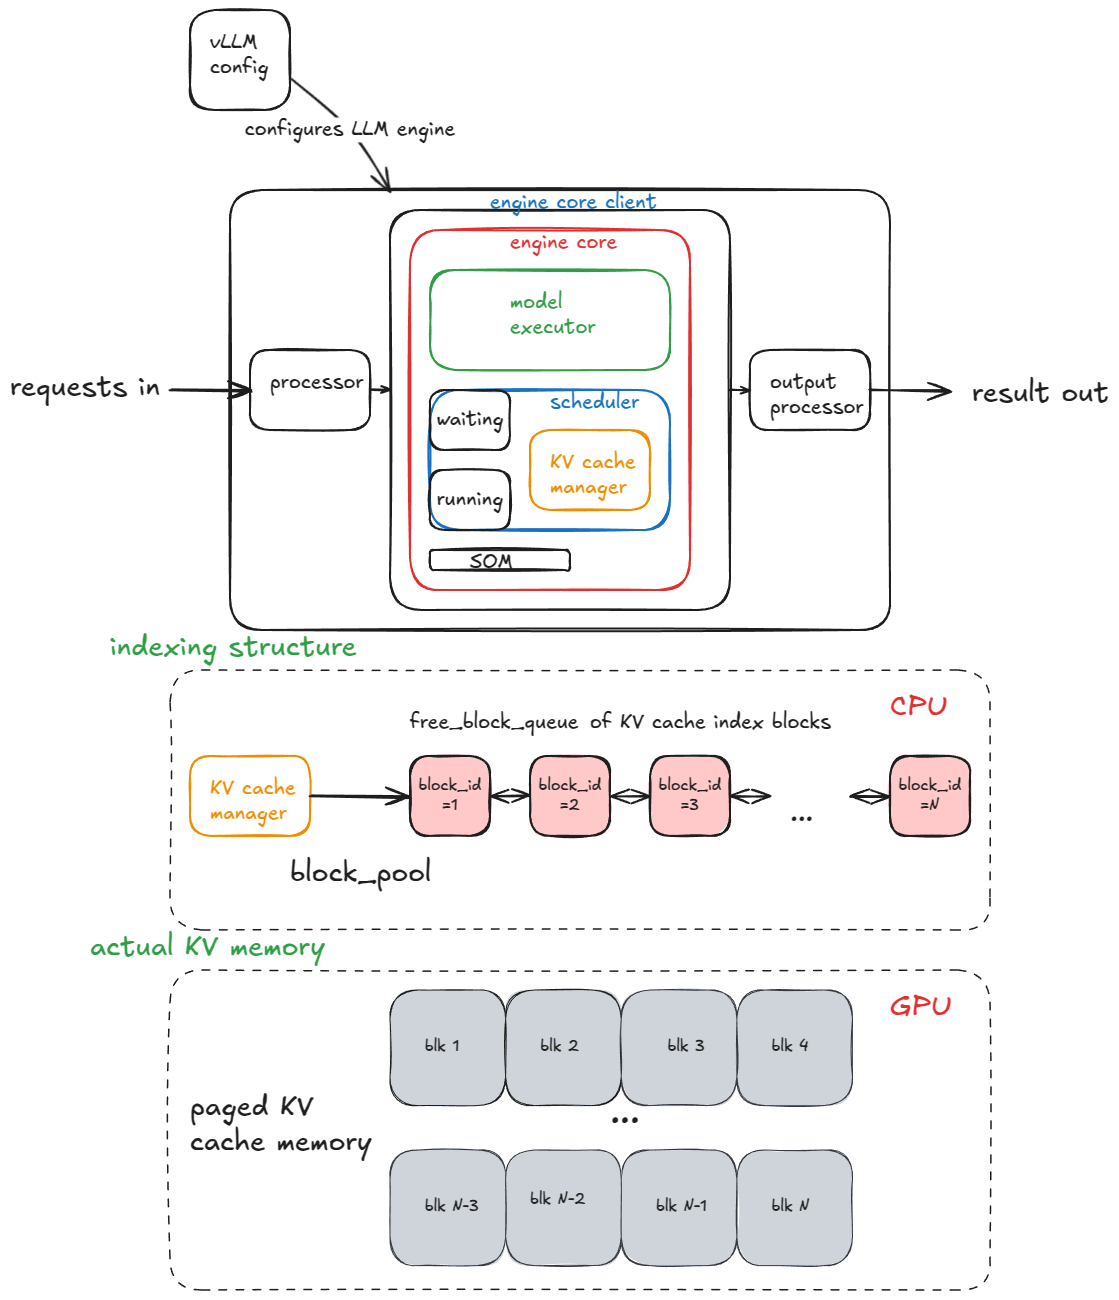
Um post técnico do blog Inside vLLM detalha a anatomia de um sistema moderno de inferência para LLMs com alta taxa de throughput. O autor explica como o vLLM organiza a engine (config, processadores de entrada/saída e o EngineCore), o papel do scheduler (FCFS ou prioridade), e o funcionamento do KV cache manager por paged attention, com blocos de cache mapeando tokens para KV já calculados.
A matéria também descreve o caminho de inicialização do worker (alocação de GPU, validação de VRAM, carregamento de pesos, criação e dimensionamento do KV cache e uso opcional de torch.compile) e como o sistema prepara metadados de atenção e CUDA graphs para reduzir overhead. Na prática, isso ajuda times de dev/infra a entender gargalos e otimizações que impactam latência e custo em produção ao servir modelos em escala.