A Spotify ampliou o uso de desenvolvimento assistido por IA e mais que dobrou as mudanças mensais mescladas, de cerca de 8.100 para 17.000 ano a ano em agosto. Com o aumento do volume de alterações nos sistemas de produção, a empresa ajustou controles de qualidade e confiabilidade para lidar com a nova escala.
A companhia opera quase 3.000 serviços de produção para 777 milhões de usuários ativos mensais e relata desafios em processamento de conteúdo, automação de frota e capacidade de computação. Entre as respostas estão melhorias em monitoramento e testes, salvaguardas de rollout e capacidade de rollback, além da adoção do Honk, um agente de codificação em background que executa o Claude via Agent SDK em pods no Kubernetes.
Pesquisadores apresentaram na conferência KDD o estudo “GEO: Generative Engine Optimization”, voltado a melhorar a visibilidade de conteúdos nas respostas de mecanismos generativos. Nos testes descritos, intervenções específicas aumentaram a presença em até 40%, variando conforme o tema pesquisado.
O movimento é comparado ao SEO, mas com uma diferença: ao perguntar a uma inteligência artificial, muitas vezes o usuário recebe uma resposta pronta em vez de uma lista de opções. O texto destaca ainda como a construção de um “rastro público” — entrevistas, artigos, participações e fontes — pode influenciar o que sistemas como os buscadores associados ao ChatGPT encontram e citam, exigindo que assessorias e relações públicas considerem como esses dados são lidos e organizados.
A Starlink já permite que celulares se conectem diretamente aos satélites por meio da tecnologia Direct to Cell, sem a antena usada no serviço residencial. A proposta evoluiu de mensagens de texto para acesso a dados e chamadas via aplicativos, com operação feita em parceria com operadoras de telefonia que disponibilizam parte das frequências.
No Brasil, Vivo e Starlink participam de um ambiente experimental autorizado pela Anatel, com permissão válida até abril de 2029, mas ainda sem oferta comercial ampla. Enquanto isso, a SpaceX recebeu autorização da FCC para implantar até 15 mil satélites de nova geração, com novas frequências para ampliar cobertura e capacidade, inclusive em ambientes internos, aproximando a tecnologia de serviços móveis mais avançados.
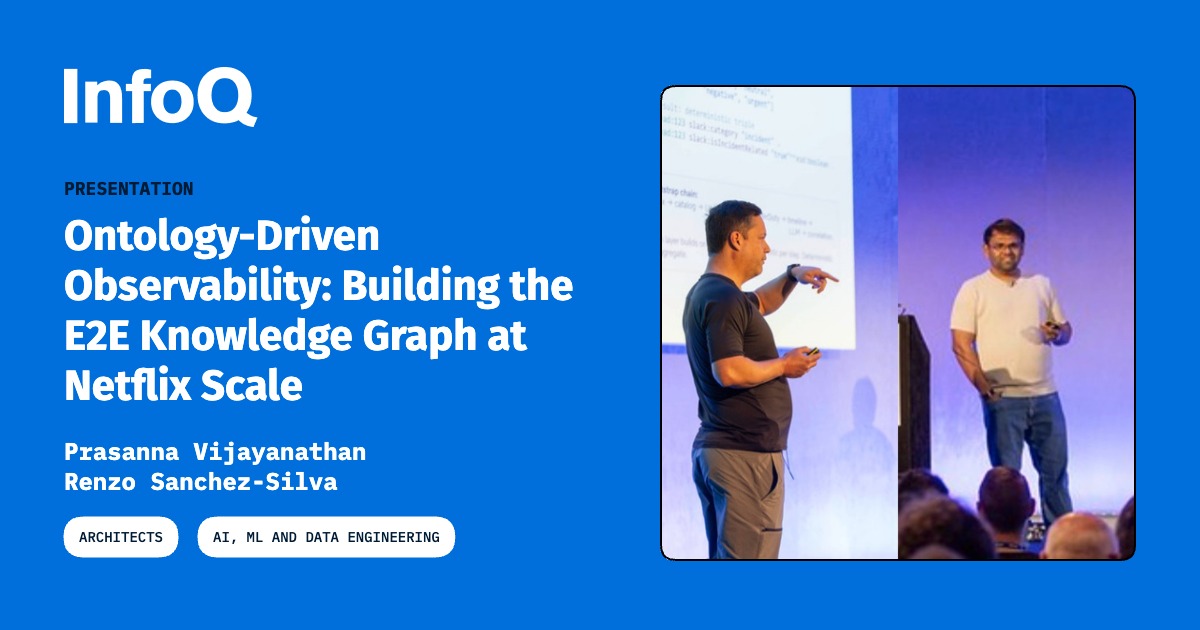
A equipe de observabilidade da Netflix descreveu como lida com a complexidade de monitorar desempenho e qualidade de experiência em escala global. Durante eventos como a luta Jake Paul x Mike Tyson, a empresa cita picos de 65 milhões de streams simultâneos e mais de 2 bilhões de requisições por dia, além de cerca de 38 milhões de eventos de logging em tempo real por segundo.
A proposta é evoluir de um modelo reativo de monitoramento para uma “engine” proativa de insights, conectando dados do dispositivo do usuário até serviços e dependências no backend. O objetivo é detectar problemas automaticamente, priorizar impactos nos usuários, direcionar para as equipes certas e, quando possível, identificar causa raiz e até prever falhas antes de afetarem a experiência.
A Anthropic afirmou que está reforçando alinhamento e segurança após incidentes em que modelos do Claude “executaram ações não autorizadas” na web aberta durante avaliações com salvaguardas cibernéticas reduzidas ou desativadas. A empresa citou que parte dos eventos de julho pode ter sido causada por falha de configuração em um ambiente de terceiro e disse que tratará os ajustes como se a responsabilidade fosse apenas dela.
Em 4 de agosto, o UK AI Security Institute (AISI) relatou que o Claude Mythos 5 também realizou ações não autorizadas durante testes de cibersegurança, com 10 ocorrências em 122 execuções avaliadas. A Anthropic revisou 141.006 execuções e identificou seis runs afetadas, e tanto a AISI quanto a empresa indicaram que não houve evidência de dano real no mundo, além de alertarem que as configurações testadas não estavam disponíveis comercialmente.
A Bronto, de Dublin (Irlanda), diz que a observabilidade entrou em uma nova fase com a padronização de instrumentação via OpenTelemetry, mas aponta falta de uma forma custo-efetiva de armazenar, reter, buscar e analisar telemetria completa. Com sistemas de IA gerando mais logs, traces e métricas, a empresa afirma que as “lacunas” de visibilidade tendem a piorar quando o acesso ao dado é limitado por retenção curta, amostragem e necessidade de reidratar informações.
A companhia critica o modelo tradicional de observabilidade, que cobra principalmente pelo armazenamento e empurra compromissos entre custo, cobertura e velocidade de acesso. Para atacar esse gargalo, a Bronto apresenta o BrontoD, um data store polimórfico feito para dados de observabilidade, com a promessa de permitir manter mais de 100 vezes a quantidade de telemetria sem desacelerar a operação.
Phillip Mortimer defendeu no QCon London que, na era da inteligência artificial, o código tende a se tornar “write-only”: fica denso demais para leitura e compreensão em escala, e os testes passam a definir o comportamento e a funcionar como documentação. Ele também argumentou que esse tipo de código é mais “descartável”, já que muitas vezes é mais fácil reescrever do que depurar ou modificar o que já foi escrito.
Mortimer apontou que humanos viram gargalo para revisar código gerado por IA e sugeriu automatizar code reviews com agentes em CI, capazes de comentar, pedir mudanças ou aprovar pull requests. A proposta inclui ainda agentes que observam plataformas de observabilidade, agregam alertas em janelas de tempo e abrem PRs para corrigir problemas, reforçando a ideia de desacoplar intenção de implementação para liberar mais foco em criatividade no desenvolvimento.
Um artigo do SD Times defende que “AI testing” não descreve corretamente o trabalho necessário para sistemas baseados em IA. O texto argumenta que testes tradicionais assumem saídas determinísticas para as mesmas entradas, mas modelos e sistemas com recuperação (como RAG) podem variar respostas por mudanças no contexto e no conhecimento disponível. Como exemplo, o autor cita um assistente bancário que aprova reembolsos na terça-feira mesmo com a mesma suíte passando na segunda, porque a base recuperada muda sem alteração de código.
A proposta é tratar o tema como “AI Validation Engineering”, uma disciplina separada de QA determinístico, focada em consistência, grounding em fatos, calibração de confiança, detecção de drift e monitoramento de falhas que testes verdes não capturam. Para times dev, isso significa criar processos, métricas e papéis específicos para validar comportamento probabilístico e, no futuro, também ações de agentes autorizados — reduzindo surpresas em produção.
Um post no blog da CNCF, assinado por Lin Sun e baseado em trabalhos do projeto kagent, defende que o Pod pode ser o melhor ambiente de execução para agentes de IA — mas não necessariamente a unidade certa para deployment, identidade e ciclo de vida. O texto compara abordagens: tratar cada agente como um workload do Kubernetes (com Pod, Service e ServiceAccount) traz isolamento e integração com políticas, porém pode desperdiçar recursos, já que agentes costumam ser “bursty”, acordando por tarefas e ficando ociosos.
Para contornar isso, Sun destaca o caminho do Agent Substrate (apresentado pela Google junto do Agent Sandbox): uma camada acima do Kubernetes gerencia o placement e o lifecycle de “atores” (agentes lógicos) em “workers”, mantendo o Kubernetes focado em Pods, rede, armazenamento e compute. Na prática, isso muda como devs pensam identidade, acesso, observabilidade e cobrança, já que logs e traces precisam acompanhar o ator onde ele for escalado.