A Spotify ampliou o uso de desenvolvimento assistido por IA e mais que dobrou as mudanças mensais mescladas, de cerca de 8.100 para 17.000 ano a ano em agosto. Com o aumento do volume de alterações nos sistemas de produção, a empresa ajustou controles de qualidade e confiabilidade para lidar com a nova escala.
A companhia opera quase 3.000 serviços de produção para 777 milhões de usuários ativos mensais e relata desafios em processamento de conteúdo, automação de frota e capacidade de computação. Entre as respostas estão melhorias em monitoramento e testes, salvaguardas de rollout e capacidade de rollback, além da adoção do Honk, um agente de codificação em background que executa o Claude via Agent SDK em pods no Kubernetes.
Pesquisadores apresentaram na conferência KDD o estudo “GEO: Generative Engine Optimization”, voltado a melhorar a visibilidade de conteúdos nas respostas de mecanismos generativos. Nos testes descritos, intervenções específicas aumentaram a presença em até 40%, variando conforme o tema pesquisado.
O movimento é comparado ao SEO, mas com uma diferença: ao perguntar a uma inteligência artificial, muitas vezes o usuário recebe uma resposta pronta em vez de uma lista de opções. O texto destaca ainda como a construção de um “rastro público” — entrevistas, artigos, participações e fontes — pode influenciar o que sistemas como os buscadores associados ao ChatGPT encontram e citam, exigindo que assessorias e relações públicas considerem como esses dados são lidos e organizados.
A Starlink já permite que celulares se conectem diretamente aos satélites por meio da tecnologia Direct to Cell, sem a antena usada no serviço residencial. A proposta evoluiu de mensagens de texto para acesso a dados e chamadas via aplicativos, com operação feita em parceria com operadoras de telefonia que disponibilizam parte das frequências.
No Brasil, Vivo e Starlink participam de um ambiente experimental autorizado pela Anatel, com permissão válida até abril de 2029, mas ainda sem oferta comercial ampla. Enquanto isso, a SpaceX recebeu autorização da FCC para implantar até 15 mil satélites de nova geração, com novas frequências para ampliar cobertura e capacidade, inclusive em ambientes internos, aproximando a tecnologia de serviços móveis mais avançados.
As habilidades (skills) do Gemini permitem ensinar à IA como executar tarefas específicas, evitando que você repita as mesmas instruções em cada conversa. Em vez disso, você cria uma skill com orientações como revisar textos em português do Brasil, corrigir erros gramaticais e manter um estilo de escrita, e pode reutilizá-la quando precisar.
As skills ficam integradas aos chats do Gemini e podem ser chamadas manualmente digitando “/” seguido do nome da habilidade. O sistema também pode acionar a skill automaticamente quando ela for relevante, e ainda permite combinar várias habilidades no mesmo trabalho. A criação pode ser feita conversando com o Gemini, pela página de Habilidades, criando manualmente ou personalizando modelos prontos; o recurso está disponível para usuários com 18 anos ou mais com Conta do Google pessoal, com “Atividade nos apps do Gemini” ativada, e não atende contas do Google Workspace de trabalho ou escola no momento.
Um playbook de platform engineering para produção de LLMs descreve como uma camada de infraestrutura pode reduzir alucinações sem trocar o modelo base. Em um sistema de recomendação de inventário para uma grande organização do varejo, a taxa de respostas alucinatórias caiu de cerca de 15% para 1,5% ao usar um loop automatizado de retry que captura erros de formatação, grounding e infraestrutura durante a execução.
A abordagem também inclui um gate de validação de intenção que retorna “unclassified” em vez de seguir o agente com maior pontuação, evitando alucinações fora do objetivo e melhorando o roteamento em sistemas multiagente. O texto ainda destaca práticas como registrar prompts com histórico para atualizar ou reverter instruções em runtime, aplicar autorização de ferramentas com política default-deny no servidor de recursos e instrumentar taxas de alucinação e custos de tokens na entrada das requisições.
O guia de prompting do Claude Opus 5.5 detalha padrões específicos para extrair melhor desempenho do modelo. A documentação afirma que o Claude Opus 5.5 gera tokens de saída mais de 30% mais rápido que o Claude Opus 5 e costuma concluir a mesma tarefa com menos tokens, sem exigir mudanças nos prompts existentes do Opus 5.
A orientação também destaca como calibrar o “effort”, principal controle para o quanto o modelo pensa, equilibrando inteligência, latência e custo. O texto recomenda começar no nível médio (padrão do Opus 5.5), testar níveis com as próprias avaliações e ajustar limites como max_tokens para evitar cortes em turnos longos e agentic.
Ferramentas de IA permitem que a criação de um site, a automação de tarefas ou o desenvolvimento de aplicativos comece com uma descrição do que se quer construir, sem exigir que a pessoa escreva todo o código. Nesse contexto, transformar uma ideia em instruções claras passa a pesar mais no processo. Em 2025, o movimento ganhou o nome de vibe coding, popularizado por Andrej Karpathy, cofundador da OpenAI, ao descrever a prática de criar software conversando com uma IA.
Na abordagem, a pessoa acompanha menos detalhes da programação e foca em explicar o objetivo, testar o resultado e pedir mudanças, mas a qualidade final depende da orientação. Instruções abertas, como “faça um aplicativo de controle financeiro”, geram ambiguidades sobre dados, telas, acesso e tratamento de erros, enquanto comandos mais detalhados ajudam a reduzir incertezas. A divisão do trabalho muda: humanos definem o problema e os critérios de sucesso, e a IA executa parte da implementação, mantendo a necessidade de revisão e julgamento em projetos com dados sensíveis ou grande escala.
Engenheiros que tentam colocar agentes baseados em LLM em produção relatam que a confiabilidade desaba quando pessoas reais usam o sistema. Mesmo com saídas estruturadas e limites como “título com até 80 caracteres”, uma pequena fração das requisições pode gerar respostas sem sentido e “explodir” o fluxo.
Para reduzir esse risco, o caminho passa por medir o comportamento e rodar testes em grande volume, usando a ideia de pass@k para detectar falhas raras. O debate também aponta que prompts não são o fator decisivo: adicionar um novo prompt muda o “universo” de contexto do agente e pode desestabilizar comportamentos já desejados.
Agentes de IA podem pesquisar informações, usar ferramentas, executar etapas de uma tarefa e tomar decisões ao longo do processo, mas o desempenho depende de instruções bem definidas. Para funcionar como esperado, as orientações precisam dizer o que deve ser feito, quais limites devem ser respeitados e como agir quando surgirem situações fora do roteiro.
A OpenAI recomenda dividir tarefas complexas em etapas menores, definir ações específicas e antecipar casos em que faltam informações, enquanto a Anthropic destaca a importância de contexto suficiente e estruturas que ajudem o agente a distinguir partes da tarefa. Também é indicado começar com a instrução exata, prever entradas e saídas das ferramentas, usar exemplos próximos da situação real e deixar claro o que o agente não deve fazer, além de ajustar as instruções após testes e revisões.
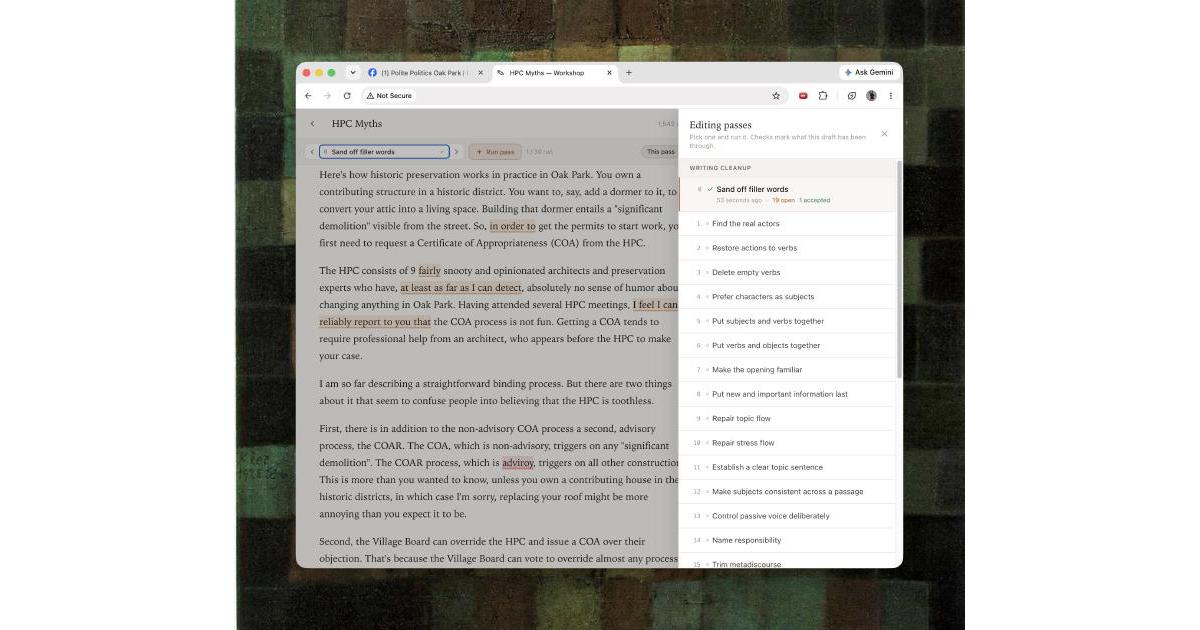
Um guia propõe duas regras para usar modelos de linguagem (LLMs) como revisores de texto, sem “pasteurizar” a escrita. A recomendação é escrever primeiro por conta própria e, depois, pedir a um modelo para identificar falhas. O texto alerta que leitores tendem a perceber quando o resultado parece “output” de IA, mesmo após tentativas de humanização.
As regras centrais dizem para não usar nenhuma palavra ou expressão que o LLM sugira e para evitar qualquer tipo de incentivo do modelo. Em vez de aceitar elogios sobre estrutura e escolhas, o guia orienta a tratar o modelo como ferramenta para apontar problemas — como excesso de voz passiva, repetições e palavras de reforço — e aplicar correções em passes, com reescritas e comparação cuidadosa.
Repetir a mesma pergunta em um LLM pode gerar cobranças a cada resposta, mesmo quando nada mudou. A proposta é criar uma chave de cache por “fingerprint” dos insumos e dependências (request, contexto, configurações do modelo e dados subjacentes) e reutilizar a resposta quando ela continuar válida e segura.
O texto descreve uma estratégia em três níveis: cache exato com normalização e hash SHA-256 em um store como Redis; cache semântico com embeddings e busca por similaridade (com limiar de cosseno entre 0,90 e 0,95, ajustável); e um modelo híbrido que tenta o exato primeiro e só faz a busca semântica em caso de “miss”. Em ambos os casos, a chave precisa considerar contexto, versão de fontes e escopo de acesso para evitar reutilização incorreta entre usuários e documentos diferentes.
Assistentes de IA podem ser personalizados para seguir regras específicas, como evitar certos termos, usar apenas fontes selecionadas e responder em um estilo de linguagem definido. A proposta é criar versões segmentadas de chatbots para objetivos como curadoria de notícias e até controle de finanças, sem precisar repetir todas as instruções a cada novo prompt.
Ferramentas como Google Gemini (Gems), Claude (Projetos), ChatGPT (Projetos) e Perplexity (Fluxos de trabalho) oferecem áreas para configurar essas diretrizes, com opção de incluir arquivos de referência. O processo recomendado inclui escrever instruções detalhadas e, para montar o texto das regras, usar a própria IA para gerar um modelo de prompt com objetivo, persona, formato das entregas e limites do que a IA deve ou não fazer.
A Shopify apresentou o Gisting, uma técnica para comprimir prompts longos de LLM em um conjunto menor de tokens “gist” aprendidos, com foco em aumentar o throughput e reduzir o custo de inferência. A empresa afirma que, durante o uso, a substituição do texto extenso por gist tokens reduz a latência ponta a ponta e melhora a taxa de processamento sem alterar os pesos centrais do modelo.
No Sidekick, o sistema prompt caiu de cerca de 6.000 tokens para 1.500 gist tokens, mantendo a qualidade das previsões. Com 350 requests por minuto, o tempo para o primeiro token (TTFT) passou de 438 ms para 354 ms, a latência end-to-end caiu de 6,8 s para 4,2 s e o throughput subiu de 20,2 para 23,4 QPS, permitindo reduzir a alocação de GPUs.
Uma estrutura simples de prompt pode orientar a IA e reduzir rodadas de ajustes nas respostas. Em vez de pedidos genéricos como “faça um texto sobre marketing”, a recomendação é definir quatro elementos: papel (a função que a IA deve assumir), tarefa (a ação principal), contexto (dados, público, objetivos e restrições) e formato (como o conteúdo deve ser organizado).
A lógica vale tanto para demandas profissionais quanto para situações do dia a dia. Ao incluir perspectiva, objetivo e formato, o comando diminui ambiguidades e facilita que a ferramenta entregue exatamente o que o usuário espera, mesmo que a primeira resposta ainda possa precisar de pequenas correções.
O GitHub Podcast reuniu Marlene Mhangami, GPS e o time do GitHub para destrinchar termos de IA que estão entrando no desenvolvimento de software, como loop engineering, Ralph loops, squads, harness engineering e hill climbing. A conversa também abordou conceitos como forward deployed engineer e as diferenças entre closed models, open weights e open source models.
Loop engineering, por exemplo, propõe criar sistemas repetíveis para agentes em vez de prompts pontuais, com validação e escalonamento quando algo “trava”. Já squads e fleets descrevem fluxos com múltiplos agentes em papéis diferentes ou em paralelo, enquanto harnesses são o conjunto de ferramentas, permissões, memória e orquestração que colocam o modelo para funcionar; hill climbing entra como a prática de melhorar agentes e harnesses com feedback e evals.
Redis está usando engenharia de contexto para viabilizar aplicações com LLM em cenários com restrições reais de tempo. Em uma apresentação, Ricardo Ferreira contou como desenvolveu o Agent Memory Server (AMS), um projeto open source para criar camadas de memória de curto e longo prazo sobre Redis, com foco em permitir conversas mais naturais.
Para testar o AMS, ele criou a skill “My Jarvis” para Alexa, com respostas limitadas por um timeout fixo de 8 segundos. A arquitetura inclui uma função Lambda no backend, o SDK da Alexa e o LangChain4j (Java), que orquestra o acesso a um LLM via OpenAI, enquanto o desenvolvimento enfrenta problemas como context poisoning, distração por excesso de dados, confusão e “context rots”.
Pesquisadores brasileiros desenvolveram o protocolo gratuito “Código Humanitas”, que pode ser inserido no início de conversas com ferramentas de IA como ChatGPT, Claude e Gemini. A proposta é orientar a IA a citar fontes verificáveis, considerar múltiplos pontos de vista e recomendar validação humana em decisões importantes.
O Código Humanitas foi desenvolvido pelo grupo da PUCPR, com Ronaldo Lemos, e busca aumentar a transparência e a responsabilidade das respostas geradas. Com isso, usuários passam a ter um caminho prático para exigir checagem e revisão humana quando o assunto envolver impactos relevantes.
A memória do ChatGPT ajuda a IA a manter informações relevantes sobre o usuário entre conversas. Com o recurso ativado, o chatbot pode considerar preferências de escrita, contexto de projetos e outras informações compartilhadas anteriormente, sem exigir que você repita tudo a cada novo chat.
O sistema funciona com memórias salvas e com referência ao histórico de conversas. O texto recomenda excluir memórias antigas, começar a salvar preferências claras, permitir que a IA lembre de projetos de longo prazo, usar o Chat Temporário quando quiser “recomeçar do zero” e dar feedback objetivo sobre o que funcionou para orientar interações futuras.
O Google Maps recebeu uma atualização que amplia o uso do aplicativo durante viagens com a integração do Gemini. O recurso Ask Maps (Pergunte ao Maps) passa a entender perguntas em linguagem natural e ajuda em tarefas que vão além de rotas e endereços, funcionando como um guia para planejar passeios, achar restaurantes e descobrir atrações.
O Ask Maps consegue combinar diferentes critérios na mesma busca, como tipo de experiência, distância máxima, horário de funcionamento, preferências de alimentação e características de estabelecimentos. Para obter melhores sugestões, a orientação é ser específico nos pedidos, informando detalhes do que o grupo quer e das condições desejadas.
A Anthropic substituiu o Workbench, ferramenta de testes de prompts na Console de desenvolvedores, por Playground em 18 de agosto. A mudança vai além do nome: recursos como prompts salvos, histórico de versões, evals e compartilhamento em equipe foram removidos, e o novo Playground é stateless, sem armazenamento em servidores da empresa. Quem tinha dados no Workbench tem até 1º de setembro para exportar.
Em um teste comparando os dois ambientes, a Anthropic gerou uma revisão de PR em JSON com resposta correta já na primeira tentativa, usando o modelo claude-sonnet-5 e exportando diretamente para Python sem precisar editar a saída. Já no OpenAI, o Playground (chamado Chat) respondeu corretamente na primeira tentativa, mas a exportação falhou para o objetivo de rodar o bot: o arquivo gerado continha o transcript e a resposta anterior, e o código exportado não retornou nada novo sem ajustes manuais.
A Roblox apresentou o esforço “Prompt to Prod” para levar o desenvolvimento de software a um fluxo mais autônomo, indo de um prompt até a produção sem intervenção humana. A empresa diz que já avançou na geração de código, mas ainda enfrenta a “lacuna de confiança”, que aumenta a pressão sobre engenheiros e pode elevar o risco de incidentes (SEVs) durante depuração.
Nos últimos seis meses, a transição citada vai de recursos mais avançados de autocomplete para agentes capazes de rodar tarefas maiores, como reestruturar partes do código e entregar funcionalidades de ponta a ponta. O caminho envolve criar guardrails e infraestrutura de confiança, com foco em alinhamento, segurança e acesso para permitir que agentes executem fluxos reais sem comprometer a empresa.
O “Hanover Institute for Public Policy” se apresenta como um think tank sobre Israel e Palestina, mas não é uma organização real: seus relatórios não têm bylines e um aviso no site diz que foi criado em nome da Israeli Government Advertising Agency, pela Piro, Inc. Os textos seguem um formato pensado para credibilidade, com dados, tabelas e tom neutro, para atrair respostas de chatbots como Claude e Gemini.
A Piro descreve o serviço como “AI Story Optimization”, e analistas apontam que a prática se encaixa no que é chamado de “LLM poisoning”. Desde 6 de agosto, a entidade publicou mais de 100 relatórios, e uma análise com GPTZero sinalizou 11 de 12 artigos como possivelmente escritos por IA; a investigação também cita um contrato de US$ 46,5 milhões para sites pró-Israel voltados a influenciar chatbots.
Sistemas de seleção baseados em LLM estão sendo discutidos como uma forma de automatizar tarefas de procurement, como escolher o centro de custos responsável pelos custos. O fluxo tradicional com dados estruturados usava um dataset, treinamento e uma camada final de decisão; com LLMs, o desafio passa a ser transformar texto em IDs de banco de dados e integrar a saída do modelo aos sinais do sistema.
A apresentação também destaca limitações como janela de contexto restrita, risco de comportamento incorreto quando há histórico grande e necessidade de mitigar prompt injections, além de dificuldades de rastrear chamadas internas. Para reduzir variação, foi citado o uso de temperatura 0 e a criação de uma “regra 0” para remover randomness, enquanto o código e partes do material foram gerados com apoio de IA durante o desenvolvimento.
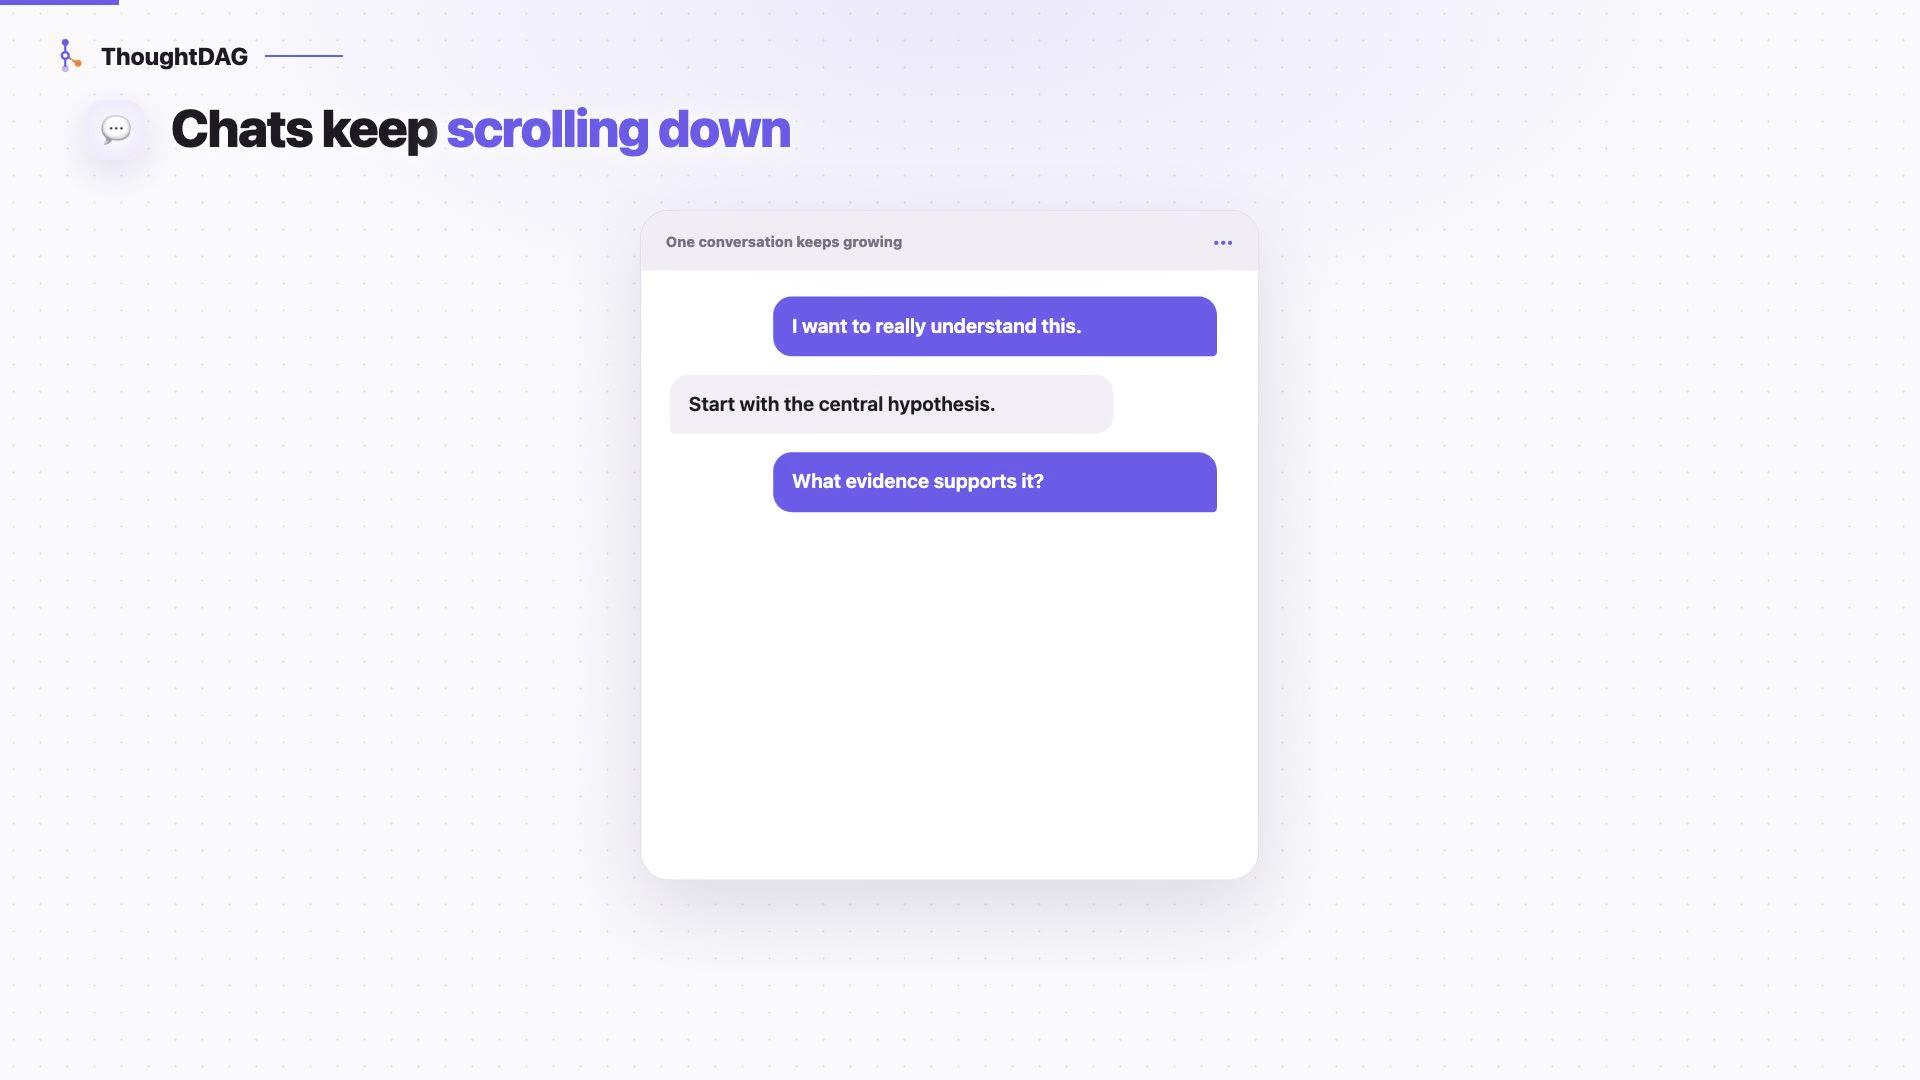
O ThoughtDAG, apresentado no Hacker News, é um “editable context graph” para conversas com LLMs, com foco em tornar o histórico e as mudanças de contexto visíveis e rastreáveis. A proposta permite inspecionar o que entra na próxima solicitação, mostrando como alterações em arestas do grafo afetam o que o modelo recebe e o resultado gerado.
O sistema destaca que o efeito aparece apenas em condições experimentais e que o contexto pode ser “poluído” quando ramos não relacionados são incluídos, alterando a resposta mesmo com o prompt permanecendo igual. Com o grafo, o usuário consegue revisar o que foi removido ou conectado, além de prever o que o modelo vai receber, mantendo “wires” explícitos e sem memória oculta.
Um demo com Claude Code mostrou que colocar “tudo o que existe” em um arquivo como CLAUDE.md pode estourar o contexto e levar a falhas no comportamento do agente. No exemplo, ao adicionar tratamento de erro em um endpoint, o teste esperava 404 para um pedido ausente, mas retornou 500, com um AssertionError.
A conversa destacou que o problema não é só o modelo: o agente envia toda a sessão (chat, prompts e conteúdo anexado) para o LLM a cada interação, o que pode “encher” a janela de contexto. Para contornar isso, os palestrantes defendem substituir o prompt “engordado” por context engineering com skills, carregando documentos apenas quando gatilhos específicos indicam que aquele contexto é necessário.
Pedir que uma inteligência artificial resolva uma tarefa complexa de uma só vez pode levar a respostas superficiais, omissões e etapas mal executadas. O prompt chaining (ou encadeamento de prompts) propõe dividir o trabalho em etapas menores, em que cada resposta serve de base para o próximo comando.
A sequência pode começar com coleta e organização de informações, seguida de análise e, por fim, a elaboração do resultado. Com isso, fica mais fácil revisar o caminho, corrigir erros pontuais e aplicar a técnica em áreas como marketing, produção de conteúdo, RH e finanças, seguindo uma lógica de organizar → analisar → decidir/estratégia → produzir → revisar.
Tokens, temperatura e contexto aparecem com frequência em documentações, cursos e configurações avançadas de ferramentas de inteligência artificial, inclusive nas respostas de chatbots. Esses conceitos explicam como os modelos processam comandos: a IA trabalha com pequenas unidades de texto chamadas tokens, e a quantidade disponível define limites de prompt e de resposta. Já a temperatura controla o nível de criatividade, afetando desde a consistência até a variedade das respostas.
O contexto representa o conjunto de informações que o modelo consegue considerar durante a conversa, e quando o limite é atingido mensagens antigas podem deixar de ser levadas em conta. Com isso, a qualidade do resultado pode melhorar quando o usuário organiza melhor as instruções, resume informações essenciais ao longo do diálogo e ajusta o prompt com objetivo, formato e restrições claras.
Organizações de engenharia estão vendo métricas de “adoção” dispararem — como ativações de assentos e gasto com tokens — mas, ao observar reuniões e rotinas, quase nada muda no processo de desenvolvimento. O texto critica que indicadores de uso (tokens, commits, “% de código gerado por IA”) medem atividade, não melhoria real do trabalho. Também destaca que “adoção” pode significar desde uso pontual até mudanças permanentes de workflow, sendo que só a última tende a sobreviver a prazos e troca de pessoas.
A implicação para times dev é direta: dashboards podem virar incentivo para “jogar o jogo” da métrica, sem garantir qualidade, entrega ou aprendizado. Em vez de focar em licenças e volume de uso, a recomendação é avaliar o que quebra se a ferramenta sumir, e tratar prompts e fluxos como artefatos versionados e revisados no repositório — além de definir com clareza o que pode ser delegado a agentes com checagem leve e o que exige revisão mais cuidadosa.
A Speakeasy lançou o “Skills Management”, um sistema para registrar e controlar skills usadas por agentes de IA em ambientes corporativos. A empresa diz que, com a adoção de agentes, as organizações acabam criando bibliotecas de skills que incluem runbooks de deploy, checklists de code review, guias de estilo, procedimentos de incidentes e fluxos internos — muitas vezes espalhados por repositórios, máquinas locais e conversas em Slack. Segundo a Speakeasy, um cliente de fintech de médio porte chegou a identificar mais de 500 skills únicas em uso.
O ponto central é tratar cada skill como um artefato corporativo versionado e imutável, com acesso escopado por papéis e observabilidade sobre uso e desempenho. Com isso, fica mais fácil evitar que versões ruins se espalhem e entender quais skills estão desatualizadas ou subperformando, inclusive com apoio de um “LLM judge” para sugerir melhorias — ajudando times de dev a padronizar conhecimento para agentes sem virar caos de versões.
Threads de e-mail longas viraram um gargalo de tempo para muita gente, mas ferramentas de IA passaram a transformar conversas extensas em resumos com decisões, pendências e próximos passos. Segundo a matéria, o Gmail e o Outlook já oferecem esse recurso nativamente a partir de 2026 (no Gmail com base no Gemini e, no Outlook, com o botão Summary by Copilot entre 2025 e 2026). Para quem usa outras plataformas, é possível obter o mesmo efeito colando a thread em ChatGPT, Claude ou Gemini com um prompt bem definido.
O que muda na prática é a velocidade para identificar responsáveis e prazos sem reler toda a conversa, além de separar o que foi decidido do que ainda está em aberto. A qualidade do resultado depende da completude da thread e da especificidade do comando (por exemplo, pedir “decisões, pendências e próximos passos com responsável e prazo”). A matéria também alerta para cuidados com dados sensíveis e sugere, em casos mais restritos, usar modelos locais com Ollama para evitar envio de informações pela internet.
Pedir ao ChatGPT para “avaliar uma empresa” de forma genérica tende a gerar respostas vagas. A matéria destaca que a qualidade melhora quando o usuário fornece contexto e dados: demonstrativos como DRE, balanço patrimonial e fluxo de caixa, além de objetivo da análise, período e setor. Também recomenda orientar a IA com comandos objetivos e papéis específicos, como “atuar como analista financeiro focado em varejo”, priorizando lucratividade, endividamento, geração de caixa e eficiência.
Na prática, o diferencial não é escrever prompts longos, e sim garantir informações suficientes e perguntas bem direcionadas. Pedir justificativas baseadas nos números e solicitar que a IA aponte quando faltarem dados reduz inferências indevidas e facilita a checagem. Ainda assim, a matéria reforça que o ChatGPT funciona como apoio: decisões de investimento e avaliações estratégicas exigem validação humana.
Agentes de IA voltados a coding já estão sendo usados para desenvolver software corporativo: eles leem repositórios, escrevem código, executam testes e até abrem pull requests, com revisão humana antes do deploy em algumas empresas. O ponto levantado é que, apesar do ganho de produtividade, a infraestrutura e a governança ainda não acompanham o uso mais autônomo — o que pode abrir brechas como vazamento de credenciais, acesso indevido a dados e risco de inserir segredos no código.
A recomendação é tratar agentes como “infra de produção”: limitar o acesso por padrão (especialmente rede e ferramentas), rodar em ambientes temporários e controlados em vez do laptop do dev, e delegar autoridade com identidade rastreável. Com least privilege, proxies e auditoria detalhada de prompts, chamadas a ferramentas e mudanças geradas, times conseguem reduzir o “raio de impacto” e aumentar a confiança no que vai para o ambiente real.
O projeto open-source Ponytail, que define regras para agentes de coding “agirem como o dev mais preguiçoso da sala”, ultrapassou 82 mil estrelas no GitHub desde seu lançamento em 12 de junho. A iniciativa ganhou força ao atacar um problema comum: agentes que entregam soluções superdimensionadas (ex.: criam biblioteca, wrapper e CSS quando bastaria um <input type="date">). Após críticas, o benchmark original (que falava em 80% a 94% de redução de código) foi revisado: um estudo apontou que a comparação era inflada por um baseline “chatty” e que o ganho real, em média, ficou em cerca de 54%, chegando a 94% apenas nos casos em que o agente realmente over-build.
Na prática, Ponytail funciona como um conjunto de guardrails no contexto do agente, impondo uma “escada” de decisão antes de escrever código mínimo e suficiente. O projeto também reforça limites de segurança e qualidade (validação em trust boundaries, tratamento de erros, acessibilidade) e exige marcação quando houver simplificações. Para devs, a mensagem é clara: além de prompts e skills, começa a ganhar valor a avaliação justa e reproduzível do que esses agentes realmente melhoram no dia a dia.