A Spotify ampliou o uso de desenvolvimento assistido por IA e mais que dobrou as mudanças mensais mescladas, de cerca de 8.100 para 17.000 ano a ano em agosto. Com o aumento do volume de alterações nos sistemas de produção, a empresa ajustou controles de qualidade e confiabilidade para lidar com a nova escala.
A companhia opera quase 3.000 serviços de produção para 777 milhões de usuários ativos mensais e relata desafios em processamento de conteúdo, automação de frota e capacidade de computação. Entre as respostas estão melhorias em monitoramento e testes, salvaguardas de rollout e capacidade de rollback, além da adoção do Honk, um agente de codificação em background que executa o Claude via Agent SDK em pods no Kubernetes.
Pesquisadores apresentaram na conferência KDD o estudo “GEO: Generative Engine Optimization”, voltado a melhorar a visibilidade de conteúdos nas respostas de mecanismos generativos. Nos testes descritos, intervenções específicas aumentaram a presença em até 40%, variando conforme o tema pesquisado.
O movimento é comparado ao SEO, mas com uma diferença: ao perguntar a uma inteligência artificial, muitas vezes o usuário recebe uma resposta pronta em vez de uma lista de opções. O texto destaca ainda como a construção de um “rastro público” — entrevistas, artigos, participações e fontes — pode influenciar o que sistemas como os buscadores associados ao ChatGPT encontram e citam, exigindo que assessorias e relações públicas considerem como esses dados são lidos e organizados.
A Starlink já permite que celulares se conectem diretamente aos satélites por meio da tecnologia Direct to Cell, sem a antena usada no serviço residencial. A proposta evoluiu de mensagens de texto para acesso a dados e chamadas via aplicativos, com operação feita em parceria com operadoras de telefonia que disponibilizam parte das frequências.
No Brasil, Vivo e Starlink participam de um ambiente experimental autorizado pela Anatel, com permissão válida até abril de 2029, mas ainda sem oferta comercial ampla. Enquanto isso, a SpaceX recebeu autorização da FCC para implantar até 15 mil satélites de nova geração, com novas frequências para ampliar cobertura e capacidade, inclusive em ambientes internos, aproximando a tecnologia de serviços móveis mais avançados.
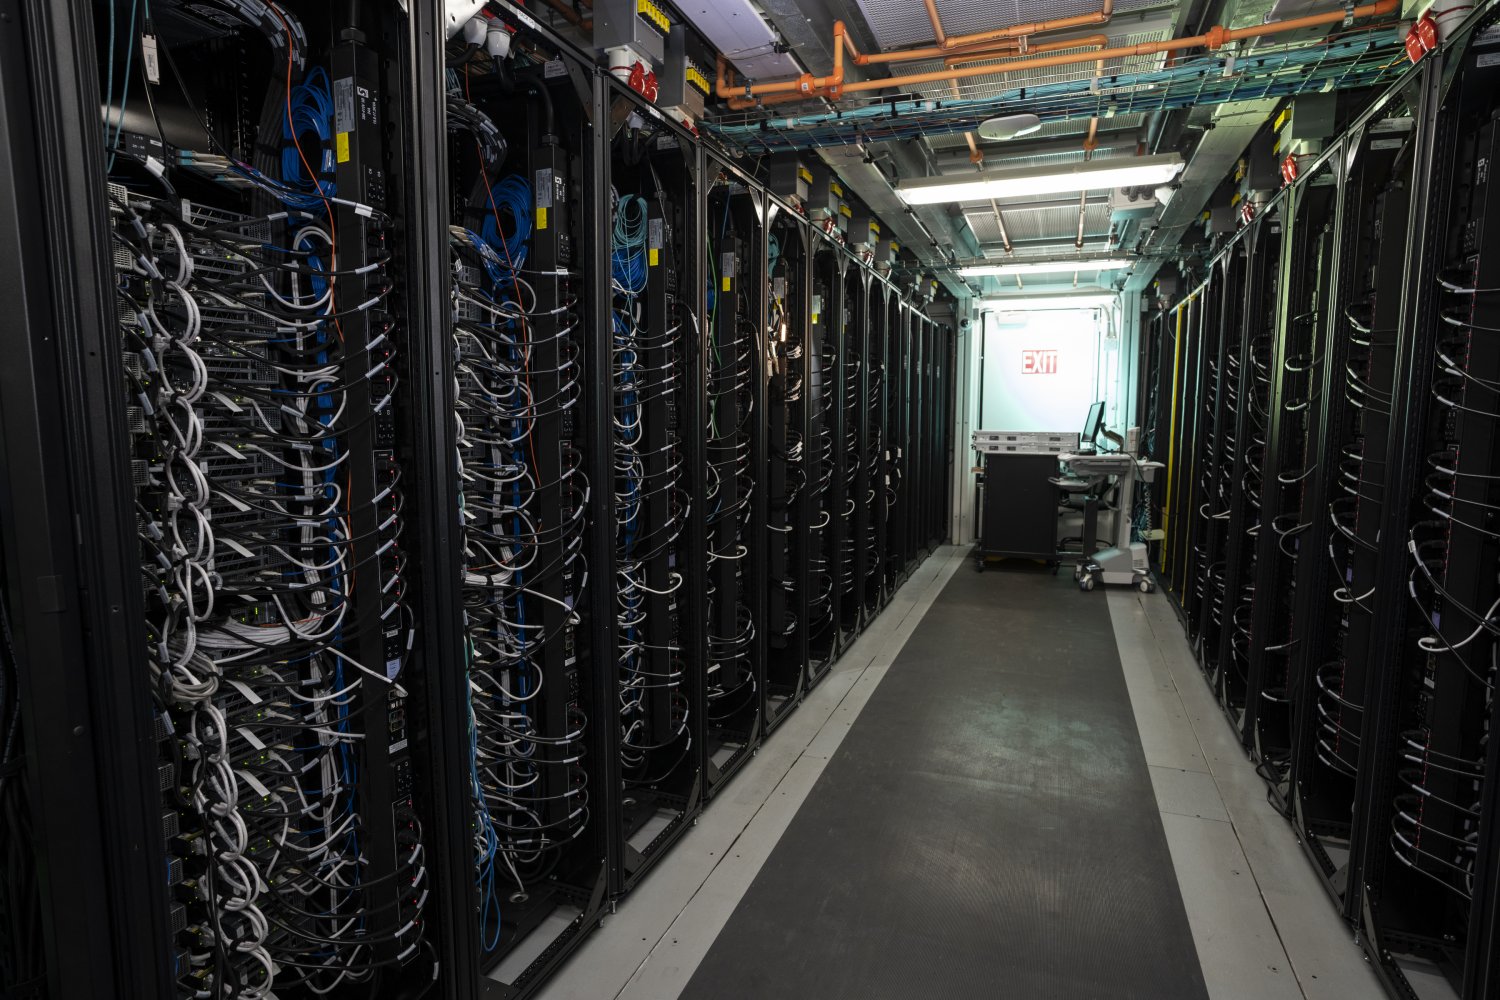
O Lincoln AI Computing Survey (LAICS), conduzido pelo Lincoln Laboratory Supercomputing Center (LLSC), continua a mapear aceleradores de IA do mercado e a comparar desempenho e consumo de energia. Desde 2018, a equipe publicou seis artigos e, no levantamento mais recente, analisou mais de 120 aceleradores, usando dados públicos e métricas como pico de performance e pico de potência.
Além de GPUs, a pesquisa inclui diferentes formatos de aceleradores, como CPUs, ASICs e FPGAs, destacando que cada tipo tem capacidades e níveis de eficiência distintos. O LAICS também investiga fatores que elevam desempenho, como transistores menores e uso de menor precisão numérica, e avalia escolhas arquiteturais que podem alterar o comportamento do sistema, com a intenção de seguir atualizando o panorama com novos lançamentos.
Um acelerador de IA open-source chamado openTPU foi apresentado como um projeto que usa “auto-arch-tournament” para testar até onde agentes de IA conseguem ir no design de hardware e se podem construir o chip que executa a própria inferência. O projeto reúne, em um monorepo, desde o hardware em SystemVerilog até a linguagem de kernel, o compilador e o software host que controla uma placa real via PCIe.
O openTPU roda dez modelos com pesos reais em uma placa Inspur YPCB-00338 (Xilinx Kintex-7 xc7k480t, com dois canais DDR3) e afirma produzir os mesmos tokens do simulador, bit a bit. Medidas em diferentes datas de 2026-09-29 a 2026-10-01 indicam ganhos de desempenho em “decode” e “prefill”, além de rotas para lidar com modelos maiores via streaming de especialistas pela memória do host.
Uma pesquisa apresenta um framework formal para operadores de atenção em Large Language Models usando Persistent State Machines (PSMs), com provas matemáticas para limites de erro de quantização e uma construção discreta do Softmax sob hipótese de logits limitados. A proposta também é validada com implementação em FPGA: um array de 1024 células em Zynq-7000 (xc7z020) e uma integração em SoC com PCIe no UltraScale+ (xcvu9p), incluindo interconexões AMBA AXI4 e ponte PCIe Gen3 via XDMA. Nos testes, a lógica fechou timing a 62,5 MHz (WNS +1,854 ns) e a simulação com mais de mil vetores aleatórios bateu bit a bit com uma referência em software fix-point.
O que muda na prática é a tentativa de tornar a atenção mais “hardware-friendly”, usando transições locais determinísticas em células estacionárias e gating para reduzir comutação ativa. Para devs/tech, isso sinaliza caminhos para acelerar e baratear inferência de LLM em dispositivos programáveis, com foco em eficiência energética e escalabilidade — embora os números de energia sejam estimativas de ferramenta, não medições em placa.