A Spotify ampliou o uso de desenvolvimento assistido por IA e mais que dobrou as mudanças mensais mescladas, de cerca de 8.100 para 17.000 ano a ano em agosto. Com o aumento do volume de alterações nos sistemas de produção, a empresa ajustou controles de qualidade e confiabilidade para lidar com a nova escala.
A companhia opera quase 3.000 serviços de produção para 777 milhões de usuários ativos mensais e relata desafios em processamento de conteúdo, automação de frota e capacidade de computação. Entre as respostas estão melhorias em monitoramento e testes, salvaguardas de rollout e capacidade de rollback, além da adoção do Honk, um agente de codificação em background que executa o Claude via Agent SDK em pods no Kubernetes.
Pesquisadores apresentaram na conferência KDD o estudo “GEO: Generative Engine Optimization”, voltado a melhorar a visibilidade de conteúdos nas respostas de mecanismos generativos. Nos testes descritos, intervenções específicas aumentaram a presença em até 40%, variando conforme o tema pesquisado.
O movimento é comparado ao SEO, mas com uma diferença: ao perguntar a uma inteligência artificial, muitas vezes o usuário recebe uma resposta pronta em vez de uma lista de opções. O texto destaca ainda como a construção de um “rastro público” — entrevistas, artigos, participações e fontes — pode influenciar o que sistemas como os buscadores associados ao ChatGPT encontram e citam, exigindo que assessorias e relações públicas considerem como esses dados são lidos e organizados.
A Starlink já permite que celulares se conectem diretamente aos satélites por meio da tecnologia Direct to Cell, sem a antena usada no serviço residencial. A proposta evoluiu de mensagens de texto para acesso a dados e chamadas via aplicativos, com operação feita em parceria com operadoras de telefonia que disponibilizam parte das frequências.
No Brasil, Vivo e Starlink participam de um ambiente experimental autorizado pela Anatel, com permissão válida até abril de 2029, mas ainda sem oferta comercial ampla. Enquanto isso, a SpaceX recebeu autorização da FCC para implantar até 15 mil satélites de nova geração, com novas frequências para ampliar cobertura e capacidade, inclusive em ambientes internos, aproximando a tecnologia de serviços móveis mais avançados.
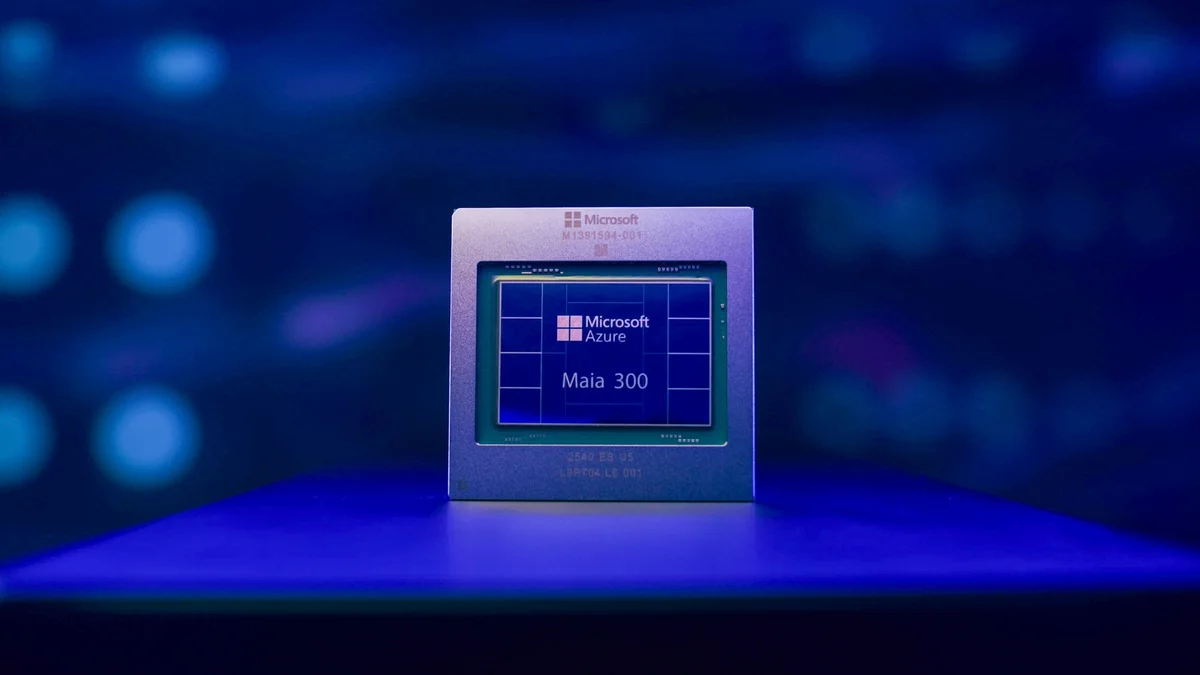
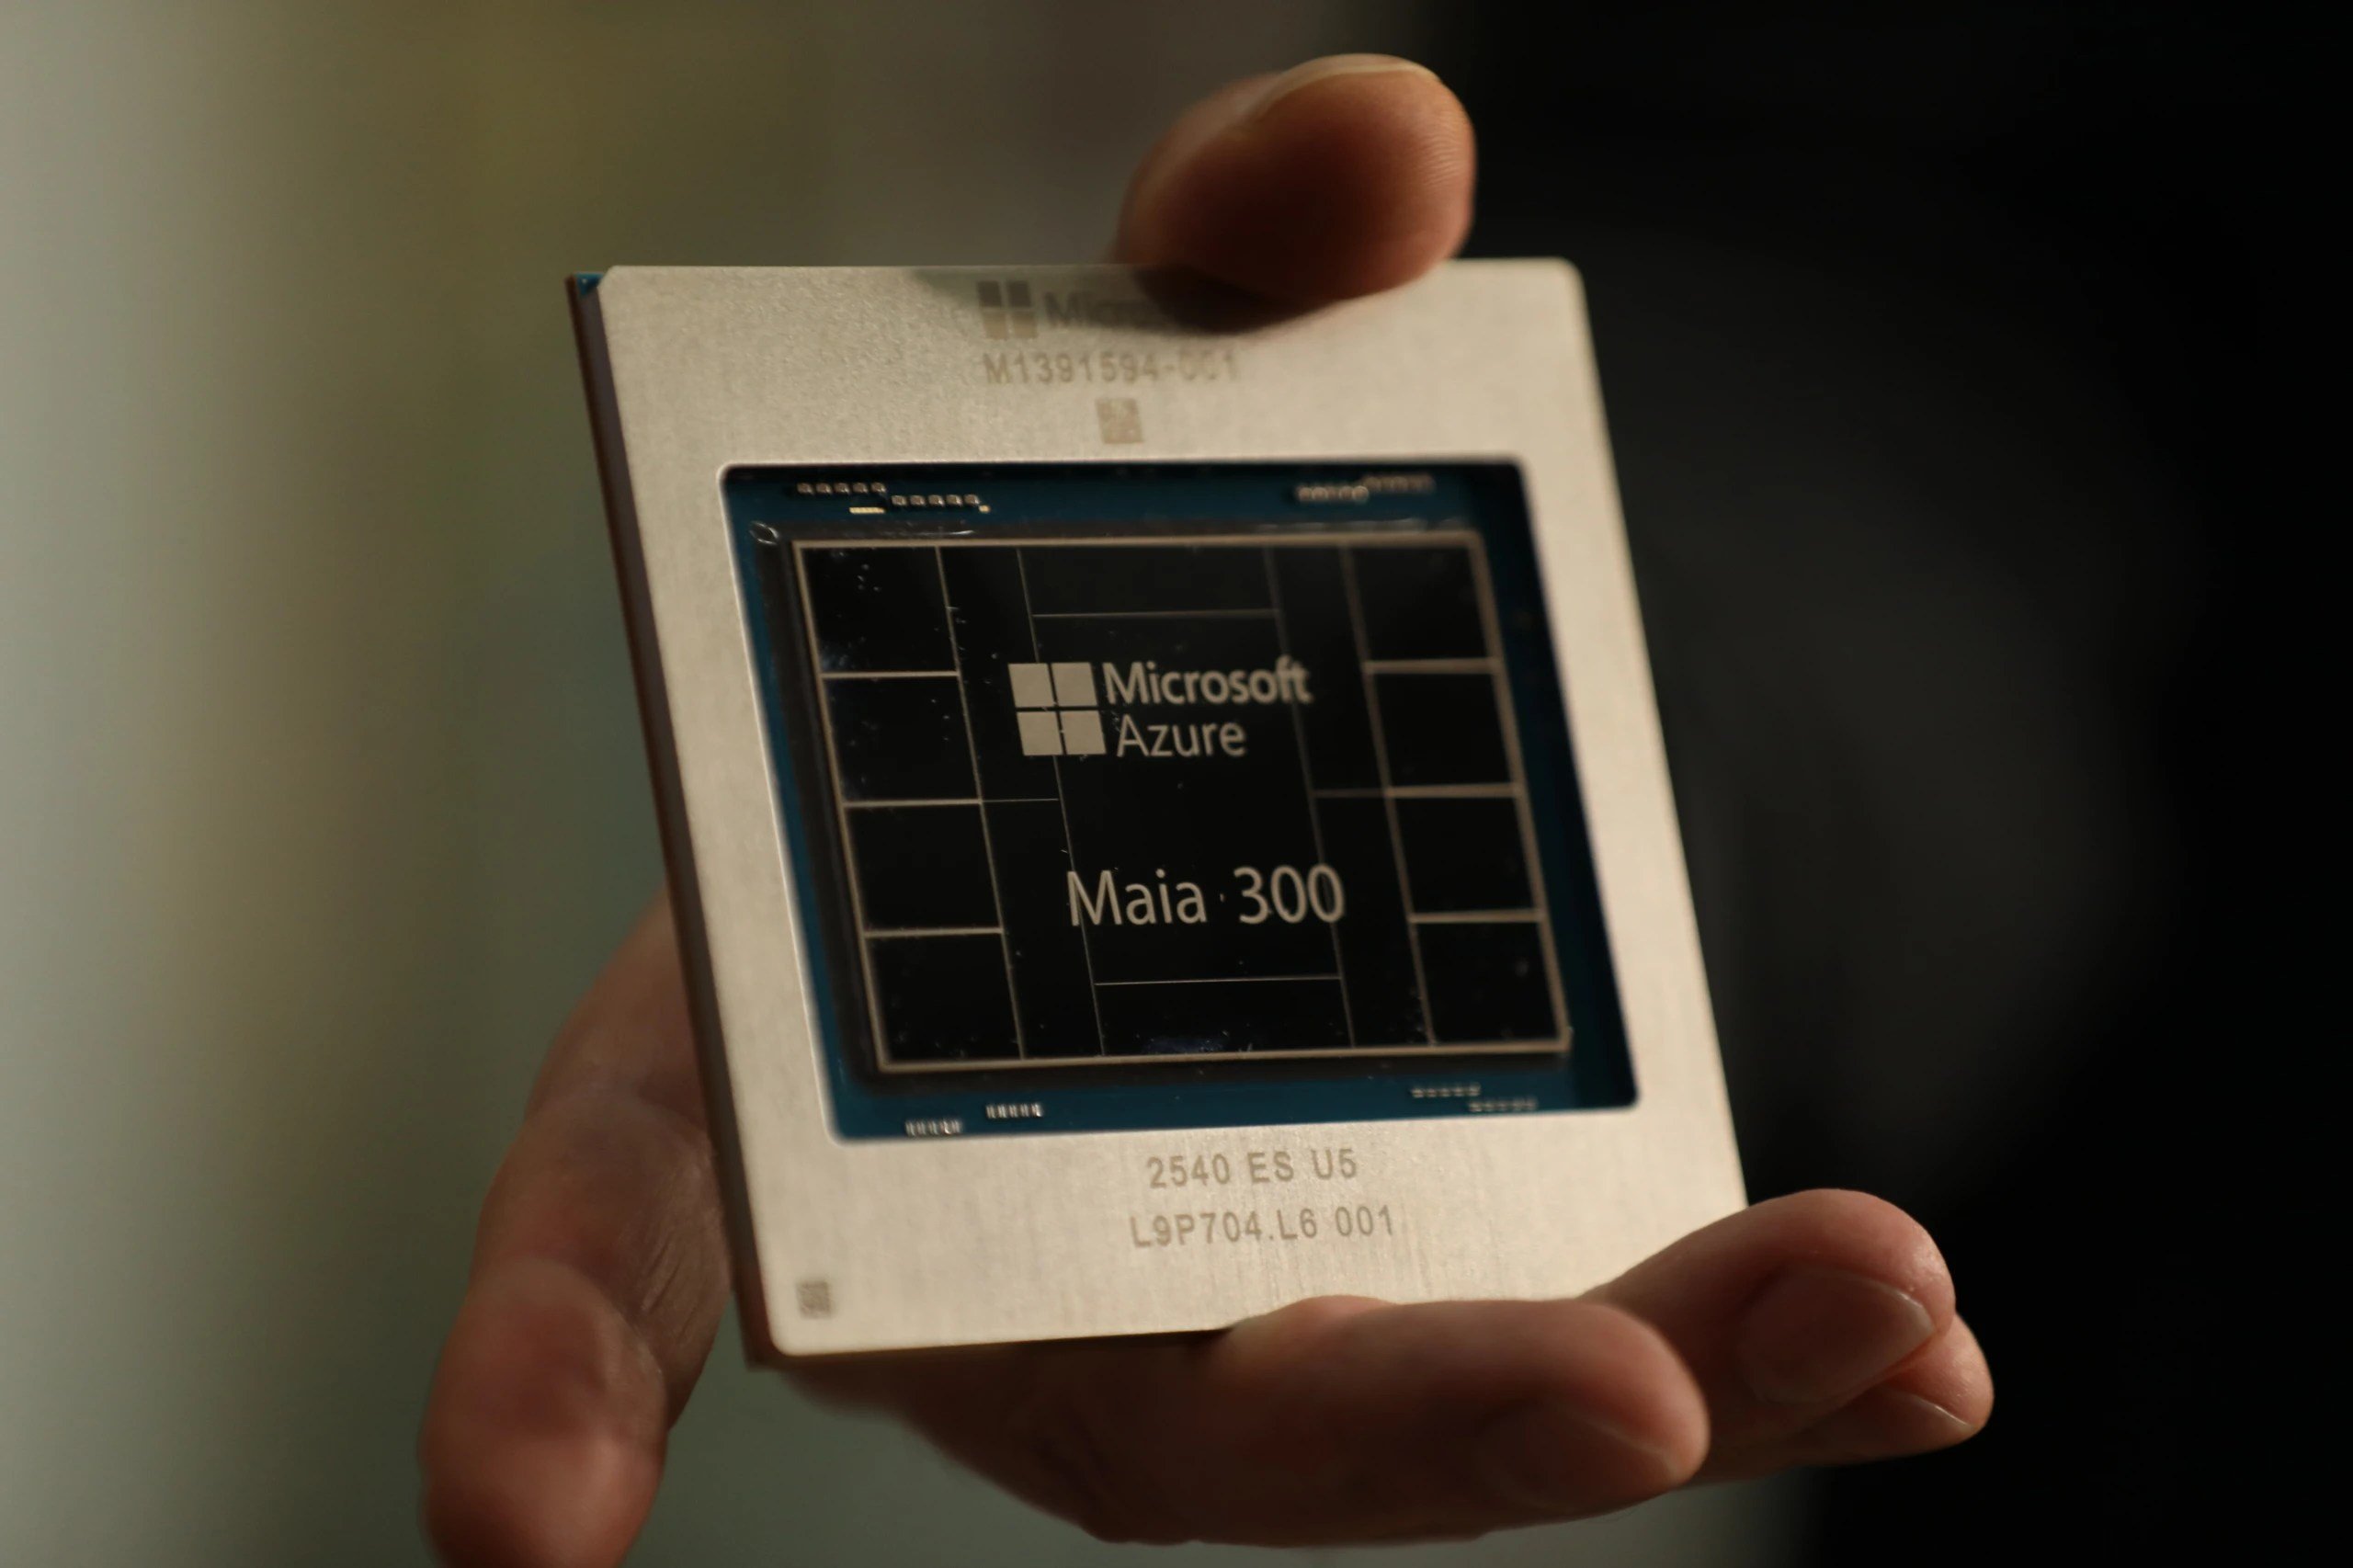
A Microsoft anunciou a terceira geração do chip de IA Maia, o Maia 300, com foco em atuar como “principal sistema de inferência” para produtos e serviços da empresa. O chip foi projetado para melhorar custo e eficiência na nuvem e para lidar melhor com modelos de raciocínio e tarefas agentic (orientadas por objetivos).
O Maia 300 começa a ser distribuído para cargas de trabalho de produção em 2027. A Microsoft espera entregar 40% mais tokens por megawatt do que sistemas líderes baseados em GPUs e, em uma configuração com 96 aceleradores, até 7x mais throughput em nível de rack do que o Maia 200, que já roda em produção em serviços como Microsoft Copilot e GitHub Copilot.
A Microsoft revelou o Maia 300, novo chip de IA para servidores, com foco em aumentar a eficiência energética no processamento de inferência. O componente promete processar 40% mais tokens por megawatt do que infraestruturas baseadas em GPUs, permitindo atender mais demandas de IA com a mesma capacidade elétrica.
O Maia 300 dá sequência ao Maia 200 e é voltado para conversas extensas, tarefas que exigem raciocínio e agentes capazes de executar várias ações em sequência. A arquitetura usa chiplets fabricados no processo N2P da TSMC, organiza componentes para manter dados próximos do uso e traz 288 GB de memória HBM4 por acelerador, além de uma configuração completa com 96 aceleradores e promessa de até sete vezes mais tokens que um rack Maia 200; a implantação está prevista para começar em 2027.
A evolução da inteligência artificial nas empresas está levando do modelo reativo de perguntas e respostas para a era da IA agêntica, com sistemas formados por múltiplos agentes digitais que raciocinam, consultam bancos de dados, chamam APIs externas e coordenam tarefas em segundo plano. Com isso, a infraestrutura deixa de atender apenas ao funcionamento do modelo e passa a precisar de camadas de orquestração, segurança, gerenciamento de memória, bancos de dados vetoriais, middleware e APIs.
A mudança de paradigma também altera a forma de dimensionar recursos: em vez de uma proporção histórica de 1 CPU para 4 ou 8 GPUs focadas em inferência, cenários de alta concorrência podem fazer a demanda por CPU superar a do acelerador gráfico. A avaliação de capacidade passa a considerar throughput por rack sob restrições reais de energia, conectividade de baixa latência e densidade de núcleos para evitar gargalos de latência e custos operacionais elevados.
A Microsoft anunciou o Azure Maia 300, nova geração de seu chip próprio de inteligência artificial, que deve virar a principal plataforma de processamento de IA dos produtos e sistemas da companhia a partir de 2027. A empresa posiciona o Maia 300 como um sistema completo para executar tarefas de agentes, indo além das respostas típicas de um chatbot.
O chip promete mais de 40% de ganho em tokens por megawatt na comparação com sistemas líderes baseados em GPUs, medindo eficiência entre conteúdo processado e energia consumida. A estratégia combina chip, software, redes e data centers para otimizar inferência e lidar com contextos extensos e tarefas que exigem muita memória, com foco em agentes que raciocinam, agem e colaboram em várias etapas.
Em 30 de julho, a IBM e a Universidade de Chicago anunciaram vantagem quântica com um cálculo usando 70 qubits lógicos, concluído em cerca de 15 minutos, com resultado considerado além do alcance prático dos computadores clássicos. Duas semanas depois, pesquisadores publicaram um artigo dizendo que reproduziram o feito em 37 minutos com 256 GPUs H100, e o próprio rastreador de vantagem quântica da IBM não lista nenhum caso como confirmado.
A computação quântica avança principalmente em correção de erros e em simulações de química, biologia e materiais — e não há evidência convincente de que ela vá acelerar a inteligência artificial com dados reais. O texto aponta que, no horizonte de 2026, governos e empresas devem tratar a migração para a criptografia pós-quântica como prioridade, enquanto a combinação mais provável para aplicações envolve GPUs, CPUs e processadores quânticos.
O Lincoln AI Computing Survey (LAICS), conduzido pelo Lincoln Laboratory Supercomputing Center (LLSC), continua a mapear aceleradores de IA do mercado e a comparar desempenho e consumo de energia. Desde 2018, a equipe publicou seis artigos e, no levantamento mais recente, analisou mais de 120 aceleradores, usando dados públicos e métricas como pico de performance e pico de potência.
Além de GPUs, a pesquisa inclui diferentes formatos de aceleradores, como CPUs, ASICs e FPGAs, destacando que cada tipo tem capacidades e níveis de eficiência distintos. O LAICS também investiga fatores que elevam desempenho, como transistores menores e uso de menor precisão numérica, e avalia escolhas arquiteturais que podem alterar o comportamento do sistema, com a intenção de seguir atualizando o panorama com novos lançamentos.
A DoorDash criou a equipe “GenAI Platform” para viabilizar projetos com inteligência artificial generativa e compartilhou, em uma apresentação, como estruturou a plataforma desde 2023. O time relata que começou após o “momento ChatGPT” (nov/22), decidiu usar OpenAI e focou em princípios como ser “customer obsessed”, priorizar APIs/SDKs e construir fluxos ponta a ponta, e não apenas notebooks ou acesso a GPUs.
A estratégia também evitou apostar em chatbots e direcionou o trabalho para impacto no negócio, com casos ligados a automação, recomendações e personalização. A plataforma já tem mais de 5.000 usuários internos e registra 45 novos cadastros por dia, com cerca de 40% do público formado por não engenheiros usando APIs, o que levou o time a reforçar governança e accountability na adoção.
As ações da Nvidia bateram recorde nesta sexta-feira (2), com alta de 2,9%, algo que não acontecia desde maio. Com o movimento, o valor de mercado da companhia se aproxima de US$ 6 trilhões (cerca de R$ 31,4 trilhões). O avanço ocorre em meio ao otimismo do mercado com o Muse AI, novo agente de inteligência artificial da Meta, que executa ações em nome dos usuários.
A valorização também reflete a demanda por data centers e componentes usados no desenvolvimento de IA, já que a Nvidia fabrica chips para treinar modelos como os que alimentam serviços de IA. A empresa é apontada como líder no mercado de chips de inteligência artificial de ponta, com produtos como as GPUs H100 e A100 e a geração Blackwell (B100), além de ter lucro de US$ 58,3 bilhões no primeiro trimestre fiscal de 2026, encerrado em 26 de abril.
A IA Ataraxos, desenvolvida por pesquisadores de Carnegie Mellon, MIT, NYU e Stanford, derrotou Pim Niemeijer, apontado como o melhor jogador de Stratego de todos os tempos, em uma série de 15 partidas: 15 vitórias para a IA e apenas 1 para o humano, com quatro empates. O desempenho foi obtido com 16 GPUs e “alguns milhares de dólares” para o treinamento.
O Stratego é um jogo de informação imperfeita e longo, em que as peças têm identidades ocultas e só são reveladas quando ocorre um confronto. Com 40 peças no tabuleiro, além de bombas e bandeira, o jogo exige lidar com um enorme número de configurações e com o blefe ao longo de partidas que podem chegar a 2.000 movimentos, um tipo de desafio que impediu sistemas anteriores de vencerem de forma confiável.
O virtio-nvgpu permite acesso “near-native” a GPUs NVIDIA dentro de uma VM KVM, fazendo o guest renderizar em até 2% do desempenho do bare metal e com custo de CPU semelhante. O sistema encaminha ioctls do driver NVIDIA no nível de ABI, mantendo os drivers e bibliotecas em modo de usuário do próprio NVIDIA sem modificações, para que Vulkan e NVENC comuniquem com a mesma placa.
O foco é streaming headless: um compositor roda dentro da VM, compõe e codifica quadros na GPU e envia apenas o bitstream comprimido para o cliente remoto, sem monitor físico na VM. Em testes com RTX 3060 e driver 595.99.02, foram observadas 618 frames decodificadas pelo ffmpeg sem erro, além de desempenho praticamente estável mesmo com múltiplas VMs compartilhando a mesma GPU.
Jensen Huang, cofundador e CEO da Nvidia, nasceu em 17 de fevereiro de 1963, em Taipé (Taiwan), e se formou em engenharia elétrica nos EUA. Antes de lançar a Nvidia no fim dos anos 1990, ele acumulou experiência em projetos de hardware e chips, incluindo passagens por empresas como AMD e LSI Logic.
Sob sua liderança, a Nvidia mudou o foco de GPUs para computação acelerada e passou a sustentar a infraestrutura usada para treinar inteligências artificiais e rodar grandes modelos de linguagem. A empresa também construiu ecossistemas de hardware e softwares proprietários, e a fortuna de Huang é estimada em US$ 190 bilhões, segundo a Forbes em setembro de 2026.
Enquanto Washington discute novas formas de regulamentar a inteligência artificial, Donald Trump tem se aproximado de Jensen Huang, CEO da Nvidia. No All-In Summit, em Los Angeles, Huang convidou Trump para falar por telefone, e o presidente afirmou que “os robôs não vão dominar o mundo” e classificou como “farsa” as preocupações com IA e data centers.
A Nvidia está no centro do boom de IA por fornecer GPUs usadas por empresas como OpenAI e Anthropic para treinar modelos e rodar grandes cargas de trabalho. A receita da companhia saltou para US$ 215 bilhões no último ano fiscal, e a relação entre Huang e Trump também deve aparecer em um jantar de Estado com Xi Jinping na próxima semana, enquanto líderes do setor pressionam por mais regras e supervisão.
A Samsung investiu na startup holandesa de chips de IA Euclyd, que busca criar uma alternativa às GPUs da Nvidia. A empresa levantou US$ 231 milhões (R$ 1,2 bilhão) na rodada Série A, de 200 milhões de euros, liderada pela própria Samsung e por investidores como Somerset Capital Partners, Scaleup Europe Fund (EQT) e Innovation Industries.
Fundada em 2024, a Euclyd desenvolve chips para inferência de IA, usando modelos já treinados para executar tarefas. A arquitetura proposta difere das GPUs por envolver processador e arquitetura de memória, com a promessa de reduzir energia e custos de data centers; a startup ainda não comprovou uso comercial em larga escala, mas pretende distribuir sistemas físicos a partir de 2028 e atender milhares de clientes corporativos até 2030.
Um desenvolvedor retomou o reverse-engineering do driver do Apple Neural Engine (ANE) no chip M1 após três anos, dizendo que antes havia concluído que o bloco não era tão útil. Ele afirma que a arquitetura do ANE é “opinionada” demais para virar uma plataforma genérica e que um driver Linux não ampliaria a variedade de cargas de trabalho. Mesmo no macOS, o ANE é usado com frequência apenas para gerar prévias com upsampling no Finder.
Com a chegada do M5 (2025) e a proposta de “performance de LLM”, o autor aponta que as cores do ANE foram incorporadas às do GPU, sinalizando o fim do NPU standalone. Agora, o objetivo passa a ser mapear a arquitetura interna do ANE no M1 — incluindo compute, datapath, scheduler, memória e modelo de execução — para entender quais suposições sobre workloads de ML a Apple colocou em silício desde o A11 Bionic (2017) e como isso se conecta à mudança de NPUs focadas em CNN para GPUs executando transformers.
Jensen Huang afirmou, em evento do Goldman Sachs Communacopia + Technology, que a Nvidia deve manter uma trajetória de crescimento recorde e voltar a acelerar a receita no fim do próximo ano. Ele repetiu a orientação de que a empresa pode crescer 70% ano a ano, citando a demanda por sistemas que combinam CPUs Grace e GPUs Blackwell, com crescimento de 27% mês a mês em um pedido envolvendo 36 Grace CPUs e 72 Blackwell GPUs.
Huang também atribuiu a confiança ao papel da Nvidia como plataforma base do ecossistema de IA, dizendo que “cada laboratório” pode usar seus recursos e que a companhia está presente em diferentes etapas, de fornecedores de memória a projetos de data center e startups. Ele ainda comentou as parcerias de investimento, afirmando que a Nvidia só entra quando há contratos reais gerando receita e que já vê US$ 100 bilhões em contratos desse tipo.
O JD.com lançou o Physical AI Acceleration Plan para expandir IA e robótica na rede logística, reafirmando a meta de cinco anos de comprar 3 milhões de robôs, 1 milhão de veículos autônomos e 100 mil drones de entrega. O plano foi apresentado no JDDiscovery 2026, em Pequim, com a divulgação da série Wolf Robot do JD Logistics, voltada a atividades de armazenagem, separação, transporte e entrega.
A empresa conecta seus equipamentos físicos ao Meta Brain, sistema de IA usado em operações de armazém, transporte e entrega, e diz que o Meta Brain 3.0 calcula rotas ideais para centenas de milhões de encomendas em segundos. Também há investimentos em infraestrutura: o JD Cloud planeja um cluster com 100 mil GPUs para treinamento e inferência de modelos, além de coletar mais de 10 milhões de horas de vídeo para treinamento de embodied-AI.
Um modelo de linguagem com 3,8 bilhões de parâmetros foi treinado por US$ 998 e obteve 0,384 no benchmark CORE. O treinamento usou 65 bilhões de tokens em 43 horas, com o projeto descrito como uma iniciativa feita do zero, com infraestrutura própria e execução em GPUs alugadas.
O autor relata que o resultado foi possível ao ajustar detalhes como agendamento de taxa de aprendizado, escolha de otimizadores por tipo de parâmetro e melhorias de eficiência no treino. Também são citadas mudanças na mistura de dados, uso de FP8 com padding de vocabulário e redução do contexto para 1024 tokens, além de métricas de desempenho durante a execução.
A NVIDIA afirmou que o upscaling DLSS 5 não ficará restrito às placas GeForce RTX 50. Em mensagem no fórum da fabricante, um representante disse que o suporte também está previsto para GPUs da linha GeForce RTX 40, embora ainda não exista data para a implementação nos hardwares mais antigos.
A empresa informou que o foco atual é otimizar o software para as RTX 50, com atualizações esperadas para este trimestre. Depois que o serviço estiver “aprimorado por completo” nas RTX 50, a intenção é expandir o suporte oficial para as RTX 40, mas a chegada pode levar tempo, sem previsão definida.
A Nvidia confirmou que o DLSS 5, renderização com IA que deveria estrear inicialmente em GPUs RTX 50, também terá suporte oficial para placas da linha RTX 40. A empresa informou que o foco atual é otimizar o desempenho da série RTX 50, com expansão para a RTX 40 após esse ajuste. A Nvidia também afirmou que não vai dar aos jogadores controles granulares, mantendo o DLSS 5 como um simples botão de ativar ou desativar.
Segundo a Nvidia, as opções mais detalhadas de “artistic controls” ficam com os desenvolvedores, incluindo seleção de modelo, Structure Intensity, Tone Intensity, além de recursos como automatic masking e custom per-pixel masking. A empresa ainda disse que desenvolvedores podem repassar alguns controles para menus próprios e que os modelos de DLSS 5 rodam em todos os frames, sem exigência de uma taxa mínima. Sobre os jogos já anunciados para receber a tecnologia, a Nvidia não confirmou quais títulos manterão o DLSS 5, apenas afirmou que “mais jogos estão a caminho” e que atualizações serão compartilhadas conforme integrações forem finalizadas.
A Shopify apresentou o Gisting, uma técnica para comprimir prompts longos de LLM em um conjunto menor de tokens “gist” aprendidos, com foco em aumentar o throughput e reduzir o custo de inferência. A empresa afirma que, durante o uso, a substituição do texto extenso por gist tokens reduz a latência ponta a ponta e melhora a taxa de processamento sem alterar os pesos centrais do modelo.
No Sidekick, o sistema prompt caiu de cerca de 6.000 tokens para 1.500 gist tokens, mantendo a qualidade das previsões. Com 350 requests por minuto, o tempo para o primeiro token (TTFT) passou de 438 ms para 354 ms, a latência end-to-end caiu de 6,8 s para 4,2 s e o throughput subiu de 20,2 para 23,4 QPS, permitindo reduzir a alocação de GPUs.
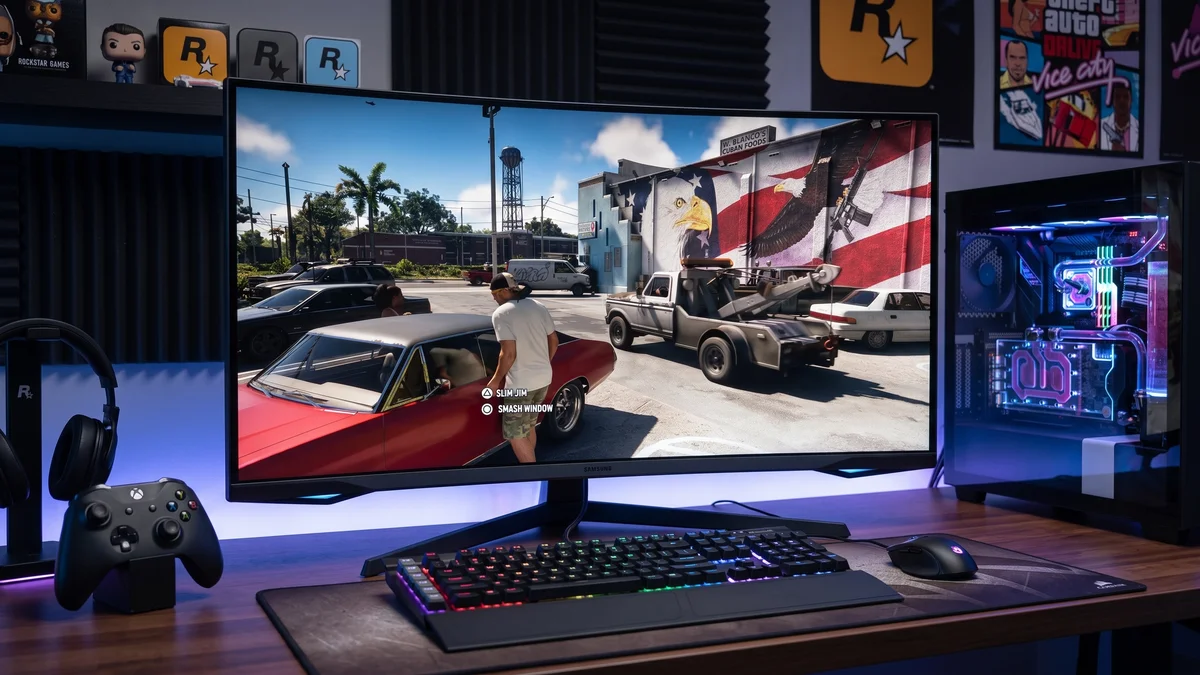
GTA 6 chega ao PlayStation 5 e ao Xbox Series a partir de 19 de novembro, enquanto os jogadores de PC ainda aguardam uma data indefinida. O primeiro trailer de gameplay foi exibido em um PS5 base e destaca reflexos com Ray Tracing e outros efeitos gráficos, levantando a dúvida sobre o peso disso no hardware do PC.
O texto aponta que o PS5 base não tem suporte ao upscaling por aprendizado de máquina da Sony (PSSR), o que pode influenciar a resolução final e a forma como os efeitos são entregues. Para o PC, a expectativa é de melhor desempenho com GPUs intermediárias e high-end, com uso de tecnologias como DLSS/FSR e, em placas mais fortes, possibilidade de Path Tracing; também são citados cenários de requisitos com VRAM acima de 12 GB, RAM de 32 GB e armazenamento que deve passar de 100 GB.
A crise na indústria de hardware de PC, impulsionada pela demanda por GPUs e memórias para treinar modelos de IA em datacenters, deixou placas de vídeo mais caras e difíceis de comprar. Com menos espaço para upgrades, o upscaling por inteligência artificial passou a ser usado para manter jogos rodando com boa qualidade e mais FPS.
Tecnologias como NVIDIA DLSS e AMD FSR evoluíram desde 2019 e hoje permitem renderizar em resoluções menores, reconstruindo a imagem no resultado final. Além do ganho em desempenho no jogo, o texto aponta que ferramentas de IA também estão sendo aplicadas no desenvolvimento, como para otimizar cenários, acelerar a compilação de shaders e prever gargalos de código antes do lançamento.
A Nvidia passou a sustentar sua vantagem na IA para além das GPUs, com a expansão do foco em como os sistemas ao redor do processador conseguem operar com eficiência em data centers de grande escala. Após a concorrência de chips próprios de hyperscalers e a desaceleração recente das ações, a empresa reforçou um novo argumento: à medida que a computação de IA chega ao patamar de gigawatts, a orquestração do ambiente de execução fica mais complexa.
A companhia está lançando a arquitetura Vera Rubin, que combina a GPU Rubin com outras unidades, incluindo a Vera CPU, um acelerador de inferência Groq 3 LPX e racks para armazenamento e redes. A Vera CPU tem como foco coordenar o fluxo de dados para a GPU, e a Nvidia cita melhorias de até 3x nas operações, além de permitir extrair mais desempenho do flash sem gargalos; a disputa, segundo o texto, migra para a eficiência do sistema completo, não apenas para a GPU.
Amazon e Nvidia anunciaram uma parceria expandida que inclui a adição de mais 2 milhões de chips GPU da Nvidia aos data centers da Amazon Web Services (AWS). As GPUs citadas incluem Nvidia Blackwell Ultra, Rubin e Rubin Ultra, com previsão de envio para os data centers da AWS em 2027 e 2028.
O anúncio foi feito durante a call de resultados trimestrais da Nvidia e ocorre apenas cinco meses depois de a Amazon ter concordado em implantar mais de 1 milhão de GPUs na infraestrutura da AWS a partir deste ano. As empresas não divulgaram valores do acordo, mas a Nvidia afirmou que a demanda superou as expectativas, e também disse que sua tecnologia — incluindo hardware de rede, modelos abertos, CPUs, software de processamento de dados e plataforma de robótica — será integrada à AWS.
A quarta-feira (26) reúne indicadores econômicos e um evento corporativo que pode influenciar o apetite por inteligência artificial: a leitura do IPCA-15 no Brasil, o PCE nos Estados Unidos e o balanço da Nvidia. No Brasil, o IPCA-15 de agosto é aguardado após julho ter subido apenas 0,06%, com projeções próximas desse patamar. Nos EUA, o foco recai sobre o núcleo do PCE de julho, com expectativa de desaceleração para 3,3%.
Depois do fechamento do mercado americano, a Nvidia divulga o resultado do segundo trimestre do ano fiscal de 2027. A empresa, com valor de mercado de US$ 5,2 trilhões e participação de cerca de 7,3% no S&P 500, é vista como termômetro do setor por fornecer grande parte das GPUs usadas no boom de IA. Documentos regulatórios citam planos de destinar US$ 105 bilhões para apoiar a OpenAI a erguer um data center em Ohio, além de iniciativas para securitizar GPUs e viabilizar crédito a projetos de data center.
Serviços como ChatGPT, Claude e Gemini popularizaram o uso de IA via navegador, mas o processamento em data centers faz com que qualquer PC dependa da internet para resumir textos, gerar códigos e criar imagens. Com isso, a indústria passou a apostar nos AI PCs, máquinas com componentes dedicados para acelerar tarefas de IA no próprio dispositivo.
A proposta mira três pontos: manter dados sensíveis no armazenamento local, reduzir a dependência de conexão com latência praticamente zero e melhorar eficiência energética com a NPU (Unidade de Processamento Neural). Para cargas mais pesadas, GPUs dedicadas também ganham destaque, enquanto o modelo híbrido aponta a nuvem para tarefas ultra complexas e o PC para o que exige privacidade e resposta imediata.
A OVHcloud vai reajustar preços em grande parte do seu catálogo a partir do outono, e o motivo apontado não está nos produtos em si: os custos de memória e armazenamento subiram fortemente desde meados de 2025. O fundador Octave Klaba relaciona a escalada ao avanço do setor de IA, que teria puxado capacidade de fabricação dos componentes usados em servidores comuns.
Klaba afirma que fornecedores globais de RAM reconfiguraram fábricas para memórias de maior largura de banda, voltadas a GPUs, em detrimento de DDR4 e DDR5. Com base nas compras da própria OVHcloud, ele cita que a memória chegou a 604 (índice) em junho de 2026, ante 604? (jun/2025 como base), e projeta aumentos ainda maiores para setembro de 2026 e início de 2027, além de reajustes em SSDs e HDs; a empresa também separa itens de armazenamento e IP em instâncias Gen3 a partir de 1º de outubro e reduz planos de economia de 1, 6 e 24 meses, mantendo opções de 12 e 36 meses.
A startup de codificação com IA Cursor agora faz parte oficialmente da SpaceX, segundo um anúncio no blog da própria Cursor. A SpaceX havia fechado um acordo em abril para desenvolver tecnologia em conjunto e, no mesmo movimento, ganhou a opção de adquirir a Cursor por US$ 60 bilhões.
Com a aquisição concluída, a Cursor destaca que a integração com a infraestrutura de computação da SpaceX pode acelerar o escalonamento da “inteligência” por meio do acesso a uma grande frota de GPUs. A SpaceX também afirma que está construindo capacidade computacional para ampliar o uso de IA, posicionando a Cursor como um local para tornar essa inteligência útil.
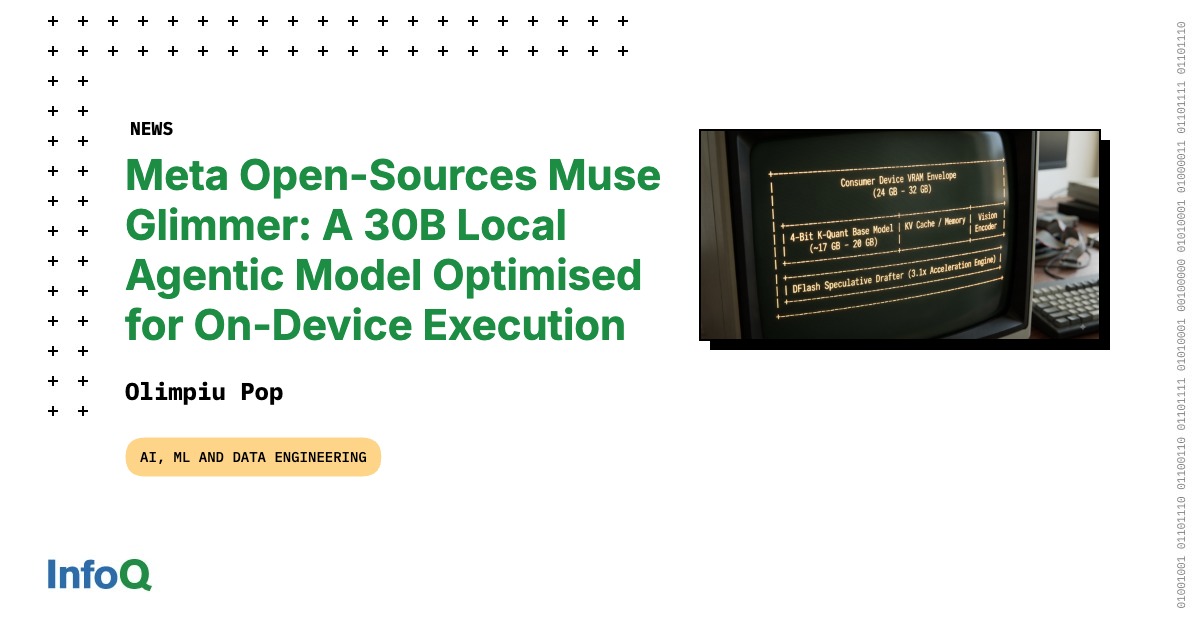
A Meta AI Research lançou o Muse Glimmer, um modelo open-weight de 30 bilhões de parâmetros sob licença Apache 2.0. Projetado para execução local “always-on”, ele permite que desenvolvedores rodem agentes autônomos, invocação complexa de ferramentas, execução de código e avaliações “LLM-as-a-judge” diretamente em GPUs e workstations, sem depender de APIs em nuvem.
Para caber em orçamentos de memória de hardware comum, o Muse Glimmer usa quantização dinâmica 4-bit para reduzir o tamanho para cerca de 17 GB a 20 GB e combina um “drafter” DFlash para validar blocos com múltiplos tokens em paralelo, com ganhos de throughput reportados de até 3,1x. O modelo também inclui um encoder de percepção de 1,8B para inputs multimodais e foi treinado para diagnosticar falhas (como erros de chamadas de API ou comandos no terminal) e tentar caminhos alternativos, com suporte a frameworks como OpenClaw.
SpaceX e NVIDIA estão unindo esforços para levar data centers de IA ao espaço com o satélite Starmind AI1, em órbita baixa a cerca de 600 km. O projeto prevê satélites de 30 metros de altura, com asas solares de 75 metros, usando CPUs NVIDIA Vera e GPUs Rubin, além de links a laser do Starlink para comunicação e envio de resultados à Terra. A proposta também mira um payload de computação que pode chegar a 250 kW no pico e 175 kW em média, alimentado por energia solar.
O desafio central apontado é o resfriamento: no vácuo, o calor precisa ser dissipado por radiação infravermelha, um processo lento, o que impõe um trade-off entre potência de computação, área de radiadores e massa do satélite. Para isso, cada unidade usaria um sistema de radiador líquido de 160 m², mas ainda não está claro como escalar essa solução para níveis de calor típicos de implantações de data center. A matéria também destaca limites de rede em órbita e riscos ligados a detritos e eventos como o de Kessler, além de ameaças associadas a conflitos no espaço.