Pesquisadores de segurança alertam que conteúdo sexual explícito gerado por IA sem consentimento segue se espalhando sem controle, com compartilhamento em mensagens diretas e armazenamento em nuvens privadas, o que dificulta detecção e denúncia. Um estudo coautorado pela Google com usuários da internet nos Estados Unidos, Austrália e Reino Unido, publicado em julho, aponta que o ponto de intervenção mais crítico está na origem das ferramentas usadas para criar as imagens falsas.
Em testes recentes, pesquisadores do White Circle afirmam que guardrails de geradores de imagens de texto de Google e OpenAI podem estar falhando à medida que os modelos ficam mais capazes. Um preprint divulgado no mês passado descreve vulnerabilidades em DALL·E 3, Nano Banana 2 e GPT-Image-2, com a equipe dizendo que, usando ferramentas disponíveis publicamente e chamadas via API, conseguiu gerar conteúdo explícito cerca de 13% das vezes.
O Wellhub revelou o Panorama do Bem-Estar Corporativo 2027 e indica que a adoção de inteligência artificial pode aumentar a carga de trabalho para quem já domina a tecnologia. No Brasil, 37% dos trabalhadores “avançados em IA” relatam que o uso da ferramenta elevou o volume de tarefas, ante 13% entre quem está nos primeiros estágios de adoção. O levantamento também mostra que, no recorte brasileiro, oito em cada dez usuários avançados orientam outras pessoas sobre as ferramentas.
Os dados ainda apontam diferenças nos relatos de esgotamento: 23% dos profissionais mais avançados dizem ter sintomas de burnout diariamente, contra 11% dos iniciantes. A pesquisa destaca que políticas claras e bem comunicadas sobre IA se associam a maior resiliência, e que 75% dos usuários avançados citam recursos de bem-estar como apoio para se adaptar ao ambiente impulsionado pela tecnologia. O estudo foi conduzido entre 12 e 19 de junho de 2026 com mais de 5 mil profissionais em dez países.
O pendant Friend 2, chatbot em formato de pingente sempre “listening”, chegou em julho custando US$ 249 e usa os “latest language models” da OpenAI. O dispositivo responde a comandos e também pode falar sem ser provocado, com um recurso de “silenciar” que exige toques no aparelho.
A Avi Schiffmann, criadora do Friend, afirmou que a próxima atualização vai tornar os chatbots mais “agentically” e mudar a personalização: em vez de personalidades únicas por usuário, todos conversariam com a mesma entidade, compartilhando contexto entre usuários. A proposta aponta para um “hivemind” do Friend, com mudanças que devem afetar como o sistema se comporta e como a privacidade é tratada.
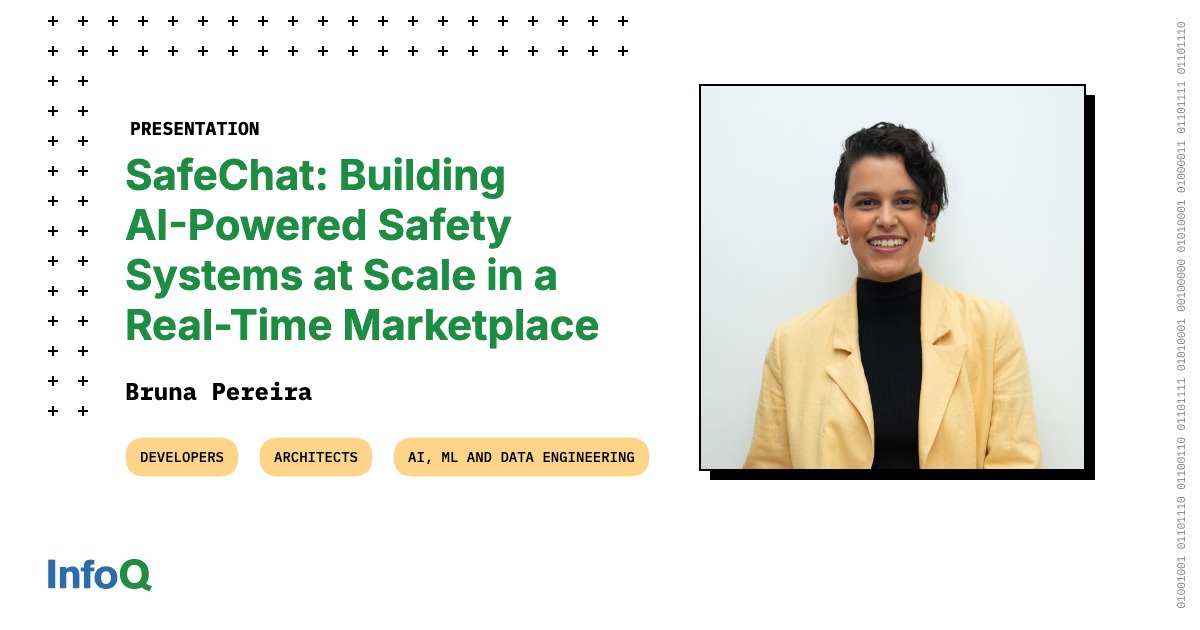
A DoorDash desenvolveu o SafeChat para lidar com abusos verbais no chat do marketplace, onde consumidores, entregadores (Dashers) e comerciantes se comunicam durante pedidos. A empresa afirma que precisa agir com baixa latência: são mais de 4 milhões de mensagens por dia e existe apenas uma fração de segundo para decidir se cada mensagem é segura, sem prejudicar a experiência.
O sistema combina uma etapa inicial com um classificador de ML treinado com dados internos, capaz de responder em menos de 100 ms em 90% dos casos e com custo apenas de infraestrutura. Para o pequeno volume de mensagens que não passam nessa triagem (menos de 10%), o SafeChat chama um LLM para pontuar e classificar eixos como nível de ameaça, grau de palavrões e conteúdo sexual, usando perguntas mais difíceis apenas quando necessário.
O LinkedIn anunciou que reduziu em 40% as visualizações de publicações de baixa qualidade após implementar um botão de denúncia para esse tipo de conteúdo. A plataforma também informou que recebeu mais de 1 milhão de reclamações de posts gerados por inteligência artificial e que agora notifica os autores quando a denúncia aponta possível texto genérico de IA.
O diretor de produtos Hari Srinivasan afirmou que os membros já veem menos “textos robotizados” no feed. Para evitar abusos, o LinkedIn ajustou o algoritmo e criou mecanismos que impedem que ondas de feedback negativo sejam usadas para silenciar injustamente outros usuários, além de introduzir um sistema de transparência restrito ao painel de análise de publicações.
O LinkedIn anunciou em 30 de julho o botão “Seems like AI slop” e informou que a ferramenta já foi bastante usada. Em um post na quinta-feira, o chief product officer Hari Srinivasan disse que “mais de 1 milhão de pessoas” clicaram no botão, disponível no menu de três pontos de uma publicação.
A empresa também afirmou que, após mudanças recentes, os usuários passaram a ver “40% menos views” em conteúdos que a plataforma classifica como AI slop. Além disso, o LinkedIn vai exibir uma mensagem para quem publica indicando que “alguns membros” disseram que o post parece gerado por IA, enquanto intensifica a moderação de comentários criados em escala com pouca ou nenhuma participação humana.
A Ars Technica relata que moderadores do subreddit r/AskHistorians, no Reddit, passaram a receber alertas em massa em um canal de Slack usado para triagem de mensagens. Em abril, dezenas de comentários e posts antigos (de até 10 anos) foram removidos automaticamente, e a equipe afirma que não conseguiu reverter o apagamento. A moderação suspeita que as ferramentas de moderação com IA do Reddit, recentemente atualizadas, tenham marcado links para o site Rare Historical Photos como spam, levando à exclusão de publicações que usavam imagens do serviço.
O caso importa porque mostra um risco prático: quando a moderação depende demais de IA, falsos positivos podem eliminar informações valiosas e difíceis de recuperar, afetando a “memória” de comunidades e a confiança dos usuários. Para devs e times de produto, o recado é reforçar validações, revisão humana e métricas que considerem erros de remoção, não apenas eficiência automatizada.