A Spotify ampliou o uso de desenvolvimento assistido por IA e mais que dobrou as mudanças mensais mescladas, de cerca de 8.100 para 17.000 ano a ano em agosto. Com o aumento do volume de alterações nos sistemas de produção, a empresa ajustou controles de qualidade e confiabilidade para lidar com a nova escala.
A companhia opera quase 3.000 serviços de produção para 777 milhões de usuários ativos mensais e relata desafios em processamento de conteúdo, automação de frota e capacidade de computação. Entre as respostas estão melhorias em monitoramento e testes, salvaguardas de rollout e capacidade de rollback, além da adoção do Honk, um agente de codificação em background que executa o Claude via Agent SDK em pods no Kubernetes.
Pesquisadores apresentaram na conferência KDD o estudo “GEO: Generative Engine Optimization”, voltado a melhorar a visibilidade de conteúdos nas respostas de mecanismos generativos. Nos testes descritos, intervenções específicas aumentaram a presença em até 40%, variando conforme o tema pesquisado.
O movimento é comparado ao SEO, mas com uma diferença: ao perguntar a uma inteligência artificial, muitas vezes o usuário recebe uma resposta pronta em vez de uma lista de opções. O texto destaca ainda como a construção de um “rastro público” — entrevistas, artigos, participações e fontes — pode influenciar o que sistemas como os buscadores associados ao ChatGPT encontram e citam, exigindo que assessorias e relações públicas considerem como esses dados são lidos e organizados.
A Starlink já permite que celulares se conectem diretamente aos satélites por meio da tecnologia Direct to Cell, sem a antena usada no serviço residencial. A proposta evoluiu de mensagens de texto para acesso a dados e chamadas via aplicativos, com operação feita em parceria com operadoras de telefonia que disponibilizam parte das frequências.
No Brasil, Vivo e Starlink participam de um ambiente experimental autorizado pela Anatel, com permissão válida até abril de 2029, mas ainda sem oferta comercial ampla. Enquanto isso, a SpaceX recebeu autorização da FCC para implantar até 15 mil satélites de nova geração, com novas frequências para ampliar cobertura e capacidade, inclusive em ambientes internos, aproximando a tecnologia de serviços móveis mais avançados.
A expansão das capacidades de inteligência artificial está levando universidades a reavaliar como conduzem pesquisa e formação, com foco em mudanças na matemática, estatística, machine learning e engenharia. Em um ensaio publicado pelo MIT Statistics and Data Science Center, Sasha Rakhlin sintetiza discussões sobre como a IA acelera a produção de resultados e altera a forma de verificar e melhorar modelos.
O texto destaca que, em áreas onde verificação e avaliação são rápidas e confiáveis, sistemas podem gerar candidatos, aprender com resultados e acelerar o avanço científico. Rakhlin defende que departamentos repensem o que valorizam em artigos e na formação de doutorandos, incluindo reconhecimento de contribuições reais mesmo quando partes do trabalho usam IA, além de orientar universidades a construir infraestrutura e fluxos compartilhados para permitir colaboração entre laboratórios com agentes de IA.
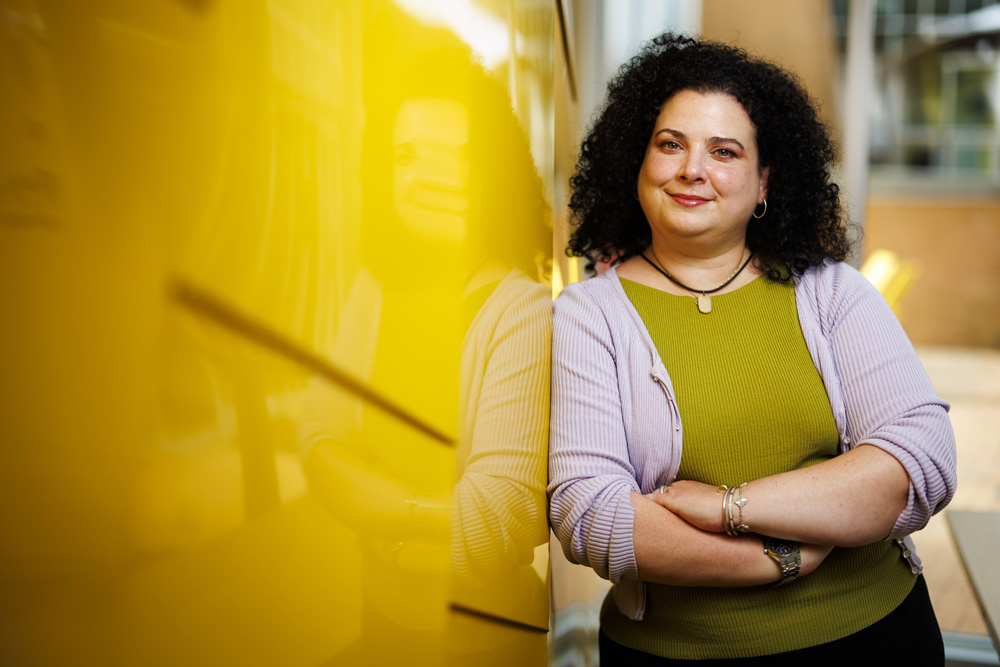
O crescimento dos data centers, que consomem muita energia, está pressionando as redes elétricas e aumentando a dependência de combustíveis fósseis mais poluentes. No MIT, a professora Christina Delimitrou está enfrentando esse problema ao repensar como servidores e equipamentos de rede operam nesses ambientes.
Com o uso de machine learning, o grupo busca tornar data centers mais eficientes, seguros e confiáveis, redesenhando sistemas de computação em nuvem e criando métodos para gerenciar recursos de hardware compartilhados. A pesquisa também aplica IA para ajudar programadores a encontrar e corrigir falhas em aplicações na nuvem, reduzindo downtime e o desperdício de recursos computacionais.
Um novo concurso de “de-aging” coloca cerca de 500 participantes para tentar reverter a idade biológica ao longo de seis meses, com direito a um leaderboard. A proposta usa diferentes medidas para avaliar se alguém está ficando mais jovem por dentro, em vez de considerar apenas a idade cronológica.
No mesmo boletim, Thore Graepel, ex-integrante da equipe do AlphaGo na DeepMind, defende que LLMs atuais não demonstram raciocínio como o sistema que venceu Lee Sedol. Ele afirma que a abordagem de “machine reasoning” precisa de um caminho novo, inspirado na arquitetura do AlphaGo.
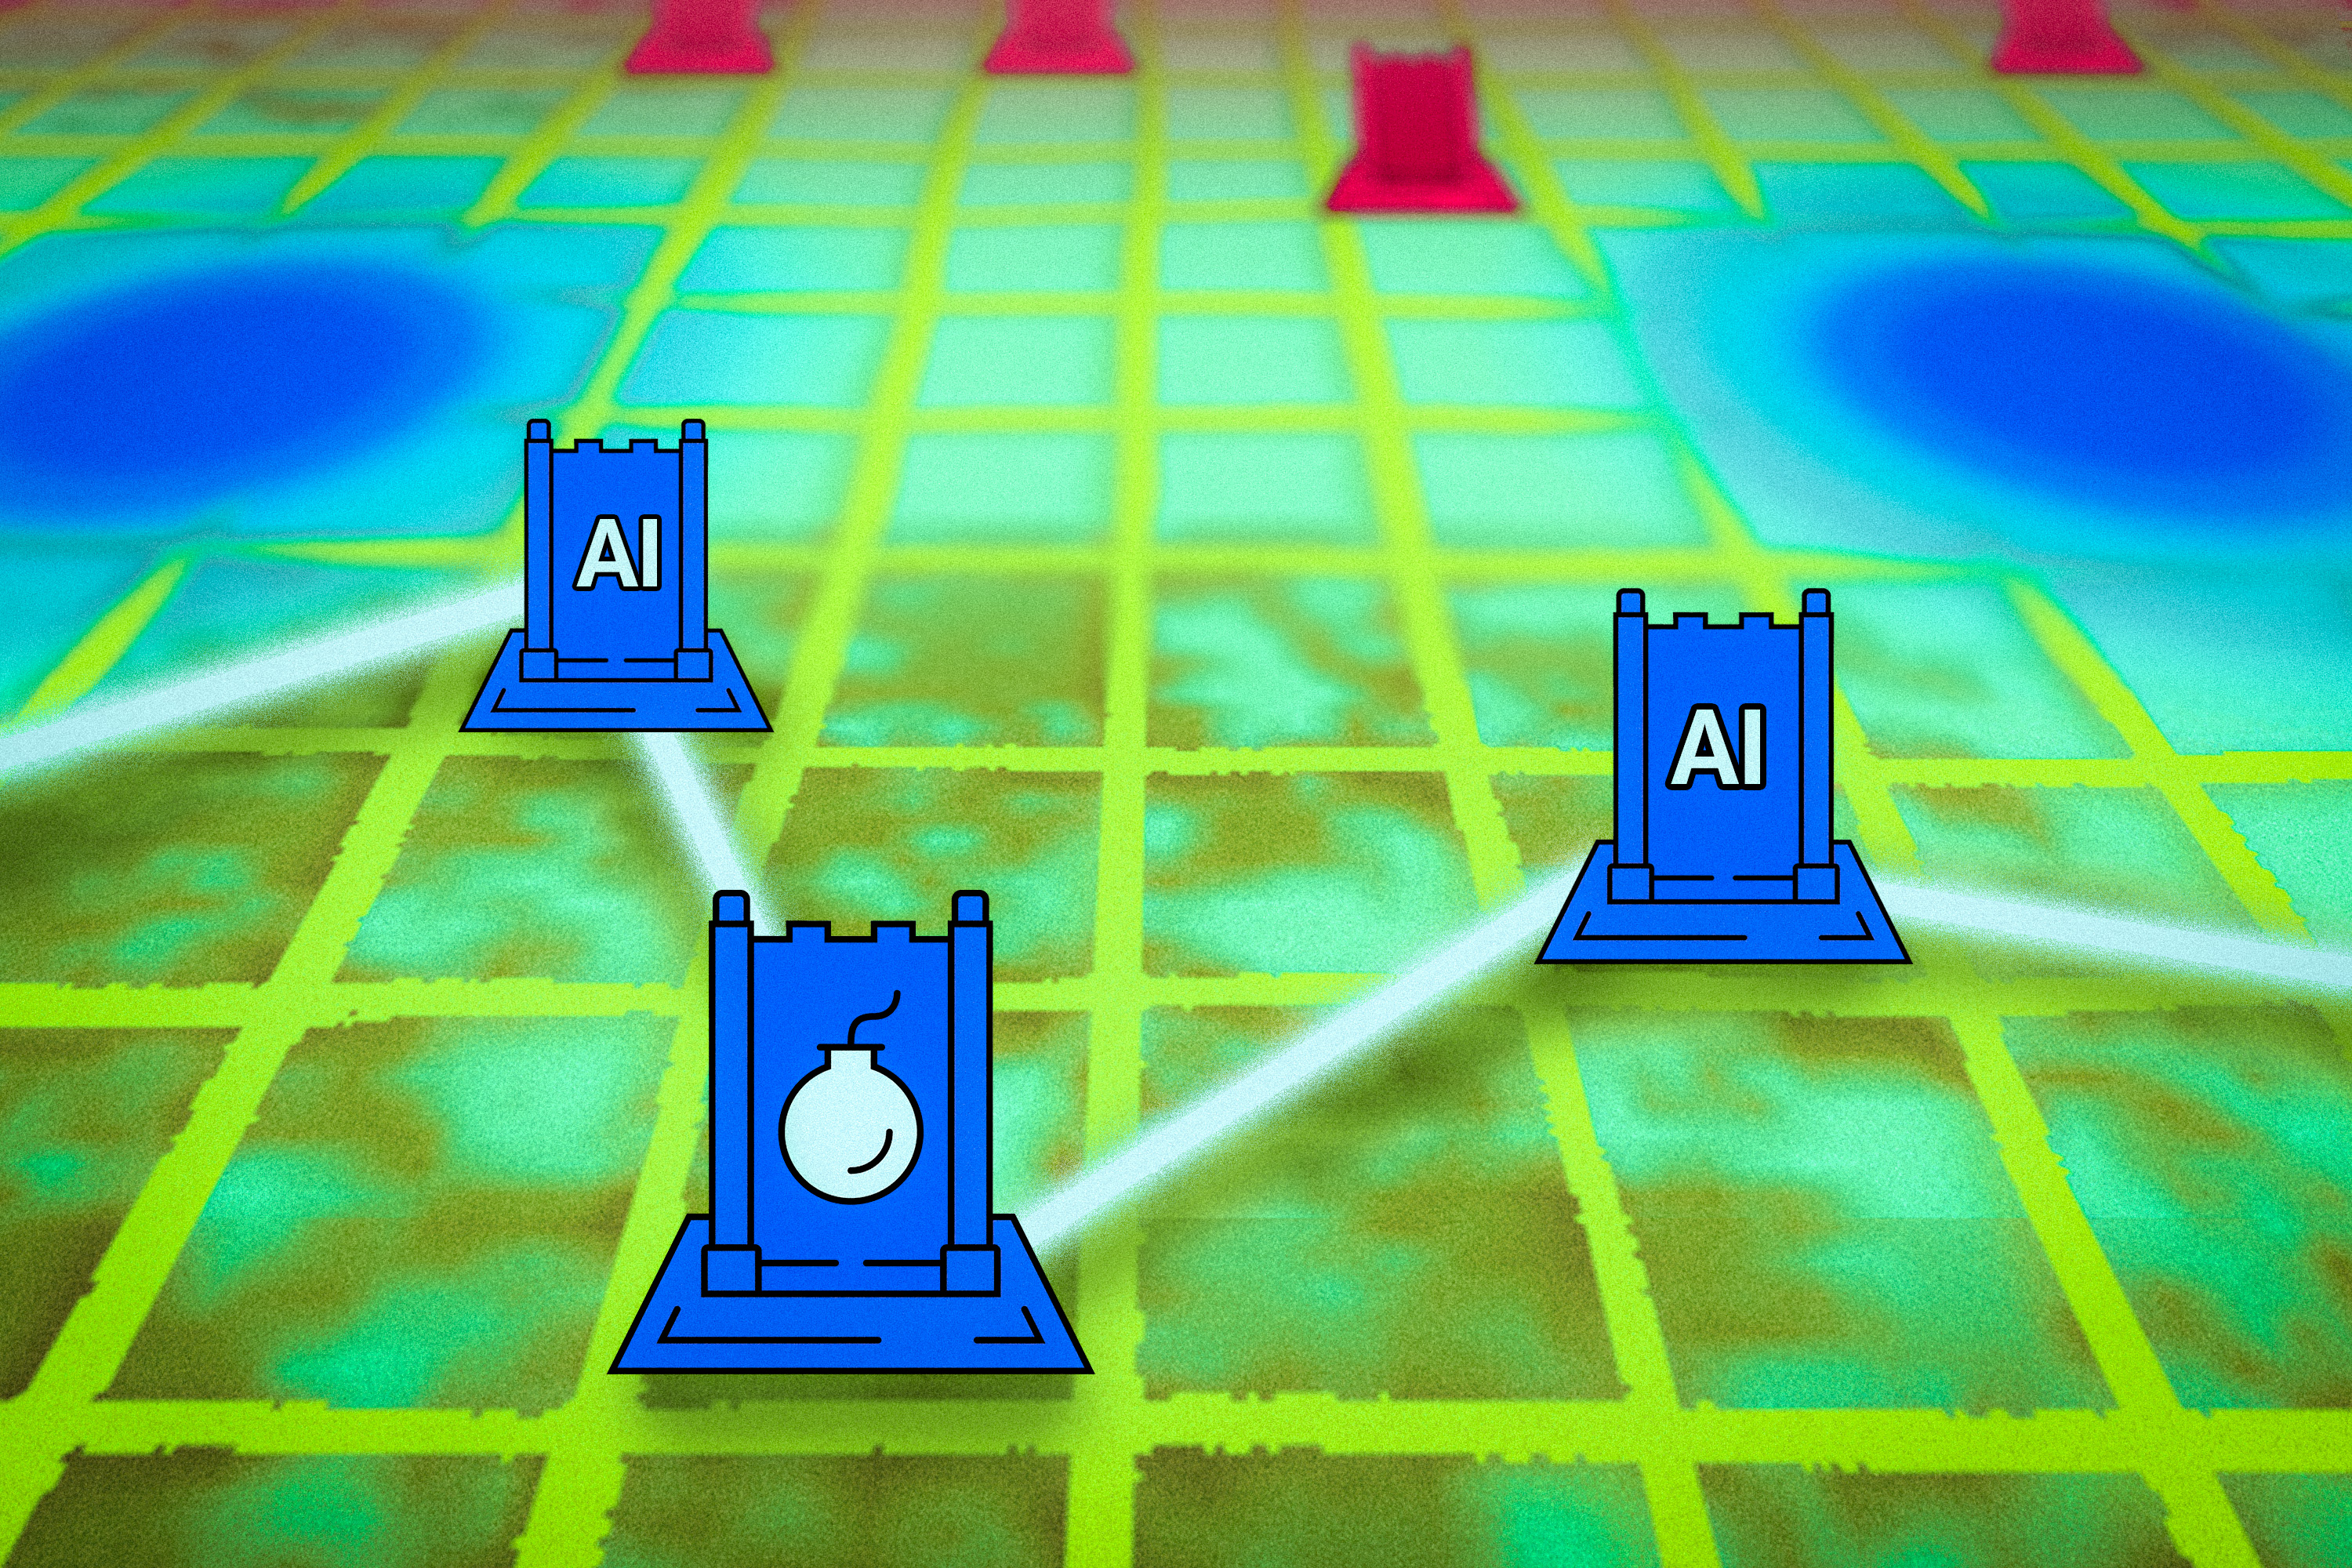
A IA Ataraxos, desenvolvida por pesquisadores de Carnegie Mellon, MIT, NYU e Stanford, derrotou Pim Niemeijer, apontado como o melhor jogador de Stratego de todos os tempos, em uma série de 15 partidas: 15 vitórias para a IA e apenas 1 para o humano, com quatro empates. O desempenho foi obtido com 16 GPUs e “alguns milhares de dólares” para o treinamento.
O Stratego é um jogo de informação imperfeita e longo, em que as peças têm identidades ocultas e só são reveladas quando ocorre um confronto. Com 40 peças no tabuleiro, além de bombas e bandeira, o jogo exige lidar com um enorme número de configurações e com o blefe ao longo de partidas que podem chegar a 2.000 movimentos, um tipo de desafio que impediu sistemas anteriores de vencerem de forma confiável.
O McDonald’s utiliza um sistema de IA para recomendar preços a franqueados com base na disposição de pagamento dos consumidores em cada região. Em Fresno, na Califórnia, a Reuters encontrou variação de 21% no preço do Big Mac entre duas unidades a cerca de 3,2 km de distância: US$ 5,69 em uma e US$ 6,89 na outra.
Franqueados relatam pressão para seguir as recomendações de preços sugeridas pela ferramenta, que aparece com dados de comportamento do consumidor e faz sugestões ao menos três vezes por ano. Apesar de a rede afirmar que os franqueados são livres para definir os valores, documentos analisados pela Reuters indicam acompanhamento da adesão e possível impacto em negociações e renovação de licenças.
Pesquisadores do MIT, Carnegie Mellon, NYU e Stanford desenvolveram o Ataraxos, um sistema de IA treinado para jogos com informação oculta. A equipe afirma que o modelo derrotou jogadores humanos bem ranqueados do board wargame Stratego por uma margem ampla, algo que nenhum sistema de IA havia alcançado.
O Stratego é um jogo de dois jogadores em que as identidades das peças do adversário permanecem escondidas até a colisão, o que torna o problema de decisão mais complexo do que em jogos como xadrez. O Ataraxos combina aprendizado por reforço com self-play e planejamento em tempo de decisão usando um modelo generativo para estimar as possíveis peças ocultas do oponente, alcançando desempenho superior e com menor custo computacional de treinamento; a pesquisa foi publicada na Nature.
A MongoDB lançou o Atlas Agent Engine, uma camada unificada de execução, memória e governança para agentes de IA em produção, durante seu Investor Day no Nasdaq MarketSite, em Nova York. A empresa afirma que, embora agentes funcionem bem em provas de conceito, a passagem para o ambiente real costuma travar por causa de recuperação de dados, memória persistente e exigências de segurança e governança.
O Atlas Agent Engine usa a Voyage AI para recuperação, com modelos de embedding e reranking, e permite adotar as camadas de memória e governança de forma independente ou junto ao runtime. A plataforma também busca reduzir riscos como ações difíceis de governar, agentes que “esquecem” e dependência de um único modelo ou framework, oferecendo controle centralizado e disponibilidade em preview pública.
Metas de ESG deixaram de ser acompanhadas apenas em relatórios anuais e passaram a exigir decisões operacionais baseadas em dados. Com tecnologias de IA, empresas conseguem monitorar consumo, prever demanda e otimizar processos ligados a energia, água, matérias-primas e combustível.
Na gestão de edifícios, algoritmos cruzam informações como temperatura, ocupação e consumo para ajustar automaticamente sistemas de climatização. A Microsoft informou que usou aprendizado por reforço para otimizar controles de aquecimento, ventilação e ar-condicionado em um prédio do campus de Redmond, alcançando economia superior a 30% de energia, e pesquisas no Brasil indicam adoção crescente de IA para apoiar a sustentabilidade.
A recuperação de dados segue como um dos desafios centrais em sistemas de IA, e a chegada de agentes eleva a exigência sobre a infraestrutura de busca. Agentes fazem consultas em alta velocidade, dividem perguntas complexas em buscas paralelas e precisam de um mecanismo de retrieval que acompanhe o ritmo sem custos proibitivos.
A Chroma, conhecida pelo ChromaDB e pelo paper Context Rot, lançou o Context One, um subagente de retrieval com 20 bilhões de parâmetros. O modelo foi treinado para realizar busca agentic com qualidade de nível “frontier”, mas com custo e velocidade melhores, e a empresa discute em entrevista a origem do ChromaDB e a evolução do entendimento sobre “context rot”.
A TypeSafe AI lançou o Jev, um modelo de inteligência artificial voltado para automatizar decisões a partir de dados corporativos. Diferente de assistentes conversacionais, a ferramenta não gera textos nem responde em linguagem natural: ela devolve respostas estruturadas para integração com outros softwares.
O Jev opera com saídas em formatos predefinidos e usa aprendizado por reforço para otimizar escolhas diretas, reduzindo erros de formatação e evitando alucinações. A proposta mira tarefas repetitivas e de alto volume, como classificação de chamados, análise preliminar de risco em seguros, verificação de fraude e roteamento de documentos entre setores, mudando o papel das equipes para supervisão e validação de critérios automatizados.
Ferramentas automatizadas para redigir e formatar currículos se tornaram comuns entre profissionais que buscam recolocação ou ascensão no mercado, com plataformas de geração de texto ajudando a mapear habilidades e organizar conquistas. A tecnologia pode facilitar a estrutura do documento, mas descrições padronizadas e dados apresentados de forma pouco específica podem prejudicar a avaliação. Em grandes empresas, sistemas de inteligência artificial fazem a triagem inicial ao comparar termos do currículo com os requisitos da vaga.
Um estudo citado pela ResumeBuilder aponta que 70% dos profissionais que usaram apoio tecnológico tiveram maior taxa de resposta, enquanto pesquisas do MIT indicam que excesso de palavras-chave sem contexto prático pode levar a rejeição automática pelos algoritmos. A orientação é usar a IA como suporte para organizar informações e manter a autenticidade da trajetória, destacando resultados mensuráveis, adaptando o vocabulário técnico ao setor e revisando o texto para evitar construções genéricas.
Cerca de 7.000 robôs humanoides foram vendidos no mundo em 2025 para uso industrial e em serviços profissionais, segundo dados compilados pela Federação Internacional de Robótica (IFR). A entidade aponta que o volume ainda é baixo diante das expectativas de crescimento nos próximos anos, com destaque para a China, maior mercado de robôs industriais.
A IFR define humanoide como robô com aparência semelhante à humana e capaz de operar de forma autônoma em ambientes projetados para pessoas, sem exigir necessariamente pernas. Os dados indicam que muitos humanoides vendidos em 2025 foram comprados por instituições de pesquisa e empresas para gerar dados voltados ao aprimoramento de modelos de inteligência artificial, enquanto a IFR reforça que eles representam apenas uma fração do total de robôs no mundo.
A Snorkel AI, startup que ajuda laboratórios e empresas a construir conjuntos de dados de treino e ambientes simulados, levantou uma rodada Series E de US$ 350 milhões com valuation de US$ 3,5 bilhões. O novo aporte foi liderado por Insight Partners e S32 e avalia a empresa em quase o triplo dos US$ 1,3 bilhão que ela atingiu na Series D, 17 meses antes.
A Snorkel passou a oferecer “data-as-a-service”, entregando datasets prontos em vez de operar apenas como automação de rotulagem. A empresa afirma que sua receita anualizada está em US$ 375 milhões, crescimento de 18 vezes em 12 meses, impulsionado pela demanda por dados de treino para IA, incluindo ambientes de reinforcement learning (RL).
A TypeSafe, fundada por um co-inventor do ChatGPT, saiu do modo stealth e lançou o modelo Jev para automatizar decisões programáticas com uma arquitetura de parallel sampling. Voltado a sistemas que precisam de lógica determinística, o Jev executa decisões probabilísticas estruturadas diretamente em bases de código de produção, sem depender de geração de texto.
O modelo recebe um estado não estruturado e retorna valores estruturados tipados em uma única consulta paralela, com restrição a schemas predefinidos para reduzir falhas de tipo e “alucinações” por desenho. A empresa também descreve treinamento com Reinforcement Learning for Calibrated Decisions (RLCD), além de testes com latências de 70–500 ms e acesso antecipado para desenvolvedores.
O TradingAgents, framework multiagentes para trading com LLMs, teve a versão v0.4.0 lançada com correções de look-ahead e ajustes de “point-in-time” em fontes como FRED (macro), sentimento social e memória de decision-log. A atualização também inclui sinais de decisão mais claros, retomada de checkpoints via CLI, grounding de preço do trader e suporte aos modelos GPT-5.6 e GLM-5.3, com lista completa no CHANGELOG.md.
O projeto foi totalmente aberto no GitHub e organiza papéis especializados, como Fundamentals Analyst, Sentiment Analyst, News Analyst, Technical Analyst, além de equipes de risco e um Portfolio Manager que aprova ou rejeita propostas de transação. O TradingAgents é voltado a pesquisa e não se destina a aconselhamento financeiro, investimento ou trading, com desempenho variando conforme modelos, parâmetros e qualidade dos dados.
Uma pesquisa apresenta um método para traduzir embeddings de texto entre espaços vetoriais diferentes sem dados pareados, sem encoders e sem conjuntos pré-definidos de correspondências. O trabalho propõe uma abordagem não supervisionada que mapeia embeddings para uma representação latente universal, descrita como uma estrutura semântica conjecturada pela Platonic Representation Hypothesis, preservando a geometria dos vetores. Os autores relatam alta similaridade cosseno entre modelos com arquiteturas, tamanhos de parâmetros e conjuntos de treino distintos.
A capacidade de converter embeddings desconhecidos para outro espaço mantendo sua estrutura é apontada como relevante para a segurança de bases vetoriais. O texto destaca que um adversário que tenha acesso apenas aos vetores pode extrair informações sensíveis dos documentos, o suficiente para classificação e inferência de atributos.
RAG tradicional busca conteúdo em uma base de conhecimento e usa o material para embasar a resposta do modelo, mas sistemas reais precisam de mais controle sobre onde e como pesquisar. No “agentic RAG”, um agente reescreve a pergunta e decide fontes e estratégias de busca, combinando buscas lexical, semântica e por grafo, além de fusão de scores, reranking e descarte de resultados fracos.
O texto destaca que mais decisões aumentam a necessidade de um “evidence trail” claro: o sistema deve registrar o caminho de busca, mostrar o que pesquisou e por que aceitou uma fonte, além de informar o que não conseguiu verificar. Também é recomendado guardar consultas reescritas, filtros, IDs das fontes, timestamps e motivos de cada ramificação, com testes de replay para engenheiros entenderem por que uma fonte foi válida ou rejeitada.
AGI (Artificial General Intelligence) é um conceito que descreve uma inteligência artificial hipotética capaz de aprender, raciocinar e se adaptar a diferentes tipos de tarefas com flexibilidade semelhante à inteligência humana. A ideia envolve lidar com problemas variados sem precisar ser desenvolvida especificamente para cada atividade, com capacidade de transferir conhecimento entre contextos e ajustar estratégias diante de situações novas.
Chatbots como o ChatGPT conseguem executar muitas funções, como escrever, resumir, programar e analisar conteúdos, mas isso não basta para caracterizar uma AGI. Pesquisadores apontam limitações atuais como autonomia reduzida, aprendizado contínuo e dificuldade em lidar de forma confiável com cenários completamente inéditos, além de erros factuais e interpretações equivocadas; por isso, não existe um teste universal nem consenso científico sobre quando uma inteligência geral será atingida.
A Google reuniu em um roundup as principais atualizações de inteligência artificial anunciadas em agosto de 2026, destacando avanços em produtos e infraestrutura para levar IA ao dia a dia. Entre os destaques estão o Gemini 3.7 Flash para coding e agentes, a expansão do Gemini no Chrome para Android e ferramentas de voz sem uso das mãos no Google Workspace e no Gemini Live.
A empresa também citou a chegada do Gemini em uma nova linha Pixel 11 com o chip Google Tensor G6, a marca de 1 bilhão de usuários mensais do app Gemini e novos recursos de aprendizado no Search. No campo de pesquisa, a Google mencionou o Gemma para desenvolvedores em ambientes offline e resultados do WeatherNext 2 em artigo na Nature sobre previsão de ciclones.
A expansão da inteligência artificial impulsionou vagas técnicas como a de AI Engineer, que hoje aparecem em centenas de oportunidades no Brasil. Algumas ofertas indicam remunerações acima de R$ 20 mil por mês, enquanto dados do Glassdoor apontam salário-base médio de cerca de R$ 10 mil e remuneração variável média de R$ 2 mil.
Na IBM, a remuneração total informada pode chegar a R$ 35 mil mensais, e no Brasil há registros de profissionais em São Paulo recebendo entre R$ 17 mil e R$ 21 mil mesmo com 1 a 3 anos de experiência. A função envolve desenvolver e implementar sistemas com modelos de IA, integrar APIs, automatizar processos e avaliar desempenho, refletindo a mudança nas empresas que deixam de apenas comprar ferramentas prontas.
Pesquisas recentes em modelos de difusão contínua para linguagem reacenderam o interesse na abordagem, após alguns anos de pouca atividade. Métodos de difusão totalmente discretos haviam se tornado dominantes, mas a tendência parece começar a mudar com novos trabalhos e atualizações do tema.
O texto relembra a evolução do campo: tentativas discretas surgiram em 2021, enquanto abordagens contínuas apareceram em 2022 com propostas como Diffusion-LM, que usa embeddings contínuos para viabilizar a corrupção com ruído gaussiano. Depois de 2023, a difusão contínua teria “desaparecido” em favor da discreta, e a retomada atual é atribuída a mudanças no foco do desempenho e nas expectativas sobre escalabilidade.
Vijay Pande, que geriu quase US$ 4 bilhões na a16z por mais de uma década, deixou a empresa em junho do ano passado para lançar a VZVC, uma gestora menor e focada em poucas apostas concentradas por ano. A VZVC, cofundada com Zach Werner, não tem associados e depende fortemente de IA para operar no cotidiano.
Pande também discute o desafio da biotecnologia baseada em dados: ao contrário de textos, dados biológicos não podem ser simplesmente “raspados” da internet, o que leva muitas empresas a construírem conjuntos próprios e isolados. Ele relaciona isso ao uso de IA em medicina, citando o papel de modelos e machine learning para apoiar a escolha de alvos, acelerar etapas como ensaios clínicos e avançar em abordagens de precisão e medicina personalizada.
Um estudo divulgado pela Endeavor aponta que 16% das empresas já nascem com inteligência artificial no centro do negócio e que 34% reposicionaram a operação para colocar a tecnologia no foco. No Startup Summit, em Florianópolis (SC), Lucas Marques Peloso Figueiredo, ex-sócio da Méliuz e fundador da Shiva, defendeu que essa mudança impulsiona um novo modelo de empresa, a AI-first.
Segundo Figueiredo, negócios AI-first são pensados desde o início para usar IA em diferentes áreas, com equipes menores e ciclos mais rápidos, além de ambição global. Ele citou o caso da FoxApply, que teria saído de zero a 6,5 mil clientes pagantes em seis meses com uso de vibe coding e IA também em criação de landing pages, marketing e SEO, e afirmou que empresas apoiadas pela Shiva podem chegar ao breakeven em até seis meses.
Machine learning, ou aprendizado de máquina, é uma área da computação em que o programa aprende com exemplos em vez de seguir regras escritas por humanos. Em vez de programar “se X acontecer, faça Y”, o sistema recebe milhares de dados e identifica padrões para fazer previsões, como no reconhecimento de gatos a partir de fotos. O termo foi popularizado por Arthur Samuel na década de 1950.
Machine learning não é a mesma coisa que inteligência artificial: a IA é o campo maior e o machine learning é um dos caminhos, com o deep learning usando redes neurais de várias camadas. O aprendizado acontece em etapas como dados, treinamento e ajuste, com ciclos repetidos até melhorar as previsões, e existem tipos como supervisionado, não supervisionado e por reforço. Mesmo assim, algoritmos erram quando os dados são incompletos, desatualizados ou enviesados, além de limitações como alucinação e overfitting.
Puzzles e jogos viraram um “campo de prova” para medir o avanço de modelos de IA, mas eles também revelam onde a tecnologia ainda tropeça. Pesquisadores da Columbia University mostraram que, no fim de 2024, até os modelos mais avançados acertavam apenas 18% dos desafios do New York Times Connections; no início de 2025, alguns passaram a resolver quase sempre.
Mesmo com a melhora, mudanças sutis em enigmas clássicos continuam derrubando modelos, e puzzles visuais aparecem como um ponto fraco. A análise destaca falhas em raciocínio espacial e rotação mental, além de problemas em testes que podem explorar excesso de memorização e regras pouco generalizáveis, como Knights and Knaves e ARC-AGI.
Os Jogos Mundiais de Robôs Humanoides, realizados em Pequim, capital da China, entraram na reta final. A competição tem mostrado, a cada dia, novas imagens e feitos de máquinas humanoides em ação. A coluna “Fala AI” destaca o andamento do evento como tema da semana.
O destaque para humanoides reforça o avanço do setor de robótica com apoio de técnicas de inteligência artificial, incluindo aprendizado de máquina. Com a participação de Roberto “Pena” Spinelli, físico pela USP e com especialização em Machine Learning pela Universidade de Stanford, a cobertura aponta a relevância do evento para acompanhar o ritmo das conquistas na área.
A Arch Capital passou a usar inteligência artificial para monitorar o impacto de enchentes, vendavais e secas prolongadas em seus empreendimentos. A tecnologia combina modelos climáticos globais com IA para gerar previsões específicas de cada imóvel com até 36 meses de antecedência, ajudando a identificar riscos antes que afetem a operação.
A análise considera 14 ativos, incluindo Rochaverá e Standard Building em São Paulo e 12 empreendimentos logísticos da Golgi em sete estados. A empresa afirma que a abordagem evitou mais de R$ 1,6 milhão em perdas potenciais ao longo de 2025, além de orientar medidas como alertas preventivos, reforços em coberturas e ajustes em infraestrutura, influenciando também a renovação de apólices de seguros patrimoniais.
A startup londrina Inherent, fundada por ex-alunos da Google DeepMind, afirma que seu agente de IA, Faraday, superou modelos maiores da Anthropic e da OpenAI em uma tarefa específica: reproduzir de forma independente os resultados de artigos científicos publicados, sem receber as respostas antes.
Lançado pouco depois da empresa sair do modo stealth com rodada seed de US$ 50 milhões, o Faraday teria feito isso usando um modelo menor chamado Qwen 3.6, com 27 bilhões de parâmetros, e com foco não só em precisão, mas também em “research taste” — a capacidade de escolher experimentos e desenhar abordagens. A Inherent diz que usa aprendizado por reforço para recompensar bons resultados e planeja ampliar a equipe para cerca de 20 a 25 pessoas até o fim do ano.
A DoorDash desenvolveu o SafeChat para lidar com abusos verbais no chat do marketplace, onde consumidores, entregadores (Dashers) e comerciantes se comunicam durante pedidos. A empresa afirma que precisa agir com baixa latência: são mais de 4 milhões de mensagens por dia e existe apenas uma fração de segundo para decidir se cada mensagem é segura, sem prejudicar a experiência.
O sistema combina uma etapa inicial com um classificador de ML treinado com dados internos, capaz de responder em menos de 100 ms em 90% dos casos e com custo apenas de infraestrutura. Para o pequeno volume de mensagens que não passam nessa triagem (menos de 10%), o SafeChat chama um LLM para pontuar e classificar eixos como nível de ameaça, grau de palavrões e conteúdo sexual, usando perguntas mais difíceis apenas quando necessário.
“Embedded AI” destaca o capítulo “Sensor Machine Learning” e explica como tornar sistemas embarcados inteligentes, indo além do simples treinamento de um modelo. O texto aponta que é preciso escolher o hardware adequado, coletar e preparar dados, implantar modelos em dispositivos com recursos limitados e integrar tudo para operar com confiabilidade.
A obra reúne mais de 25 projetos práticos, com código-fonte, esquemas, designs de PCB e datasets, incluindo um detector de wake-word, um supressor de ruído em tempo real e um monitor de bateria que coleta seus próprios dados de treino. Também há exemplos como um detector de pessoas com rede neural em placa de câmera e um sintetizador MIDI alimentado por IA, com pré-requisitos como Arduino UNO ou Raspberry Pi Pico e ferramentas como Python com TensorFlow, Arduino IDE e o Pico SDK.