Pesquisadores de segurança alertam que conteúdo sexual explícito gerado por IA sem consentimento segue se espalhando sem controle, com compartilhamento em mensagens diretas e armazenamento em nuvens privadas, o que dificulta detecção e denúncia. Um estudo coautorado pela Google com usuários da internet nos Estados Unidos, Austrália e Reino Unido, publicado em julho, aponta que o ponto de intervenção mais crítico está na origem das ferramentas usadas para criar as imagens falsas.
Em testes recentes, pesquisadores do White Circle afirmam que guardrails de geradores de imagens de texto de Google e OpenAI podem estar falhando à medida que os modelos ficam mais capazes. Um preprint divulgado no mês passado descreve vulnerabilidades em DALL·E 3, Nano Banana 2 e GPT-Image-2, com a equipe dizendo que, usando ferramentas disponíveis publicamente e chamadas via API, conseguiu gerar conteúdo explícito cerca de 13% das vezes.
O Wellhub revelou o Panorama do Bem-Estar Corporativo 2027 e indica que a adoção de inteligência artificial pode aumentar a carga de trabalho para quem já domina a tecnologia. No Brasil, 37% dos trabalhadores “avançados em IA” relatam que o uso da ferramenta elevou o volume de tarefas, ante 13% entre quem está nos primeiros estágios de adoção. O levantamento também mostra que, no recorte brasileiro, oito em cada dez usuários avançados orientam outras pessoas sobre as ferramentas.
Os dados ainda apontam diferenças nos relatos de esgotamento: 23% dos profissionais mais avançados dizem ter sintomas de burnout diariamente, contra 11% dos iniciantes. A pesquisa destaca que políticas claras e bem comunicadas sobre IA se associam a maior resiliência, e que 75% dos usuários avançados citam recursos de bem-estar como apoio para se adaptar ao ambiente impulsionado pela tecnologia. O estudo foi conduzido entre 12 e 19 de junho de 2026 com mais de 5 mil profissionais em dez países.
O pendant Friend 2, chatbot em formato de pingente sempre “listening”, chegou em julho custando US$ 249 e usa os “latest language models” da OpenAI. O dispositivo responde a comandos e também pode falar sem ser provocado, com um recurso de “silenciar” que exige toques no aparelho.
A Avi Schiffmann, criadora do Friend, afirmou que a próxima atualização vai tornar os chatbots mais “agentically” e mudar a personalização: em vez de personalidades únicas por usuário, todos conversariam com a mesma entidade, compartilhando contexto entre usuários. A proposta aponta para um “hivemind” do Friend, com mudanças que devem afetar como o sistema se comporta e como a privacidade é tratada.
Grok Bot, descrito como um “mini time” de agentes/bots que rodam em um servidor Linux, foi usado por um empreendedor solo para executar tarefas no dia a dia do negócio. Ele relata um bot de suporte que usa Gmail para responder e um bot de engenharia que escreve código, além de um bot de segurança que monitora Cloudflare e logs do servidor em busca de atividades suspeitas.
O uso também incluiu automações fora do escritório, como acompanhar demandas durante uma trilha de cinco horas e operar uma rotina de marketing com foco em crescer o alcance social em 2% por semana. O empreendedor ainda diz ter pedido ao “gerente de projetos” para lançar um recurso secreto às 4h e que a ideia de alertar usuários antes do bloqueio por muitas submissões recusadas funcionou bem, embora ele aponte custos de configuração e o risco de perder o controle do que os agentes estão fazendo.
O Google adicionou suporte a modelos locais no Antigravity SDK, permitindo que desenvolvedores construam e executem fluxos de trabalho agentic diretamente nas próprias máquinas, com a opção de misturar modelos da nuvem para tarefas de nível mais alto. A proposta busca dar mais controle sobre privacidade dos dados, custos de inferência, dependência de rede e distribuição de carga computacional.
O SDK também traz orquestração híbrida de agentes, seguindo o padrão Architect-Builder: um agente “arquiteto” define a visão macro e o plano, enquanto agentes “builders” rodam isolados localmente para tarefas como reproduzir vulnerabilidades de segurança, propor correções, revisar patches e executar testes de regressão. Em uma demonstração com auditoria e correção de três módulos Python vulneráveis, o Google informou que apenas 95 de cerca de 3400 tokens foram usados na nuvem para planejamento, com 97,2% do restante processado localmente, sem upload de código; a implementação inicial usa o Gemma 4 26B A4B via LiteRT e também aceita servidores locais compatíveis com OpenAI como Ollama, LM Studio e vLLM.
O GitHub aprimorou o secret scanning do GitHub Copilot com um classificador treinado para diferenciar credenciais reais de “lookalikes”, reduzindo ruído nas detecções. A solução usa um pipeline em duas etapas: regex para gerar candidatos e um modelo ModernBERT fine-tuned para avaliar o contexto do código e do texto ao redor de cada possível segredo.
Com isso, o GitHub relata queda de 86% no tempo mediano de execução do scan pós-push e mais de 98% de economia de custos em comparação com um pipeline baseado em LLM. A empresa também diz que a adoção do novo scanner melhorou em 11,5% a aceitação dos usuários, ajudando a reduzir alertas falsos tanto no post-push scanning quanto no push protection.
A QCon AI New York 2026 confirmou sessões com engenheiros sêniores que enfrentaram desafios de IA em produção, como revisão de código, aumento de custos por tokens, necessidade de evals confiáveis e definição de permissões e guardrails para agentes. O evento acontece em 15 e 16 de dezembro, no The Westin Jersey City Newport, com foco em decisões técnicas para IA em sistemas reais.
As palestras incluem abordagens para identidade e autorização de agentes em produção, com controles como rate limits e aprovações para mudanças, além de um “eval loop” para conectar resultados simulados ao que acontece em produção. Também há discussões sobre compressão e caching para reduzir custos de contexto de LLM, revisão de código assistida por IA em escala e como avaliar maturidade de IA além de métricas de adoção.
Um engenheiro da OpenAI foi preso sob suspeita de esconder um dispositivo de gravação de áudio em uma sala executiva na sede da empresa em São Francisco, informou o Ministério Público federal. Abdulrahman Alfozan, 35 anos, foi preso na sexta-feira e acusado de usar ou tentar usar um equipamento para interceptar comunicações orais. Ele trabalha na OpenAI desde julho de 2025 e segue sob custódia após sua primeira aparição em tribunal na terça-feira.
Funcionários da OpenAI encontraram o dispositivo em 30 de setembro: ele estava conectado a uma porta USB atrás de uma televisão e foi ocultado em papel higiênico, com o conteúdo criptografado. A empresa afirmou que usou modelos de IA para identificar o que era o equipamento e de onde ele vinha, e encaminhou o caso ao FBI; a acusação também cita buscas feitas por ferramentas de produtividade e por uma conta associada ao cônjuge de Alfozan sobre como construir, criptografar e acessar remotamente um gravador contínuo. Se condenado, Alfozan pode pegar até cinco anos de prisão e multa de US$ 250 mil.
O mercado global de smartphones registrou queda de 20% nas remessas na comparação com o mesmo período de 2025, segundo a Counterpoint Research. A retração foi atribuída à escassez de chips de memória, com a produção sendo direcionada para atender à demanda por infraestrutura de inteligência artificial (IA).
Enquanto isso, Apple e Samsung ampliaram participação: a Samsung liderou com 23% e a Apple chegou a 22%, com o iPhone superando 20% no terceiro trimestre pela primeira vez. A expansão de data centers de IA elevou a procura por memórias HBM, afetando a oferta de DRAM usada em smartphones e pressionando custos, enquanto Xiaomi (10%), Oppo (9%) e Vivo (8%) ficaram atrás.
O Parsimony, benchmark open-source, foi criado para medir quanto código modelos de IA adicionam ao resolver tarefas, indo além de métricas tradicionais de taxa de acerto e custo. Em vez de contar linhas, ele contabiliza unidades de código como elementos de sintaxe (declarações, chamadas, comparações, nomes e literais), subtraindo trechos removidos para chegar ao total líquido: unidades adicionadas menos unidades removidas.
O ranking considera a média de “unidades líquidas adicionadas” nos desafios que o modelo resolveu, incluindo tentativas falhas, com “resolvido” baseado no SWE-bench Verified. O método aplica os patches publicados, faz a análise sintática dos arquivos alterados e não executa testes novamente, além de excluir testes, documentação e arquivos gerados; a proposta busca reduzir o incentivo a soluções com excesso de código.
A forte demanda por infraestrutura de inteligência artificial deve continuar superando a capacidade de produção da indústria pelos próximos dois a três anos, segundo o CEO da Intel, Lip-Bu Tan, em evento do DBS Bank em Cingapura. Ele apontou gargalos na cadeia de suprimentos, com restrições em memórias, silício e empacotamento, como fatores que devem manter o mercado sob pressão.
Tan também alertou que, apesar da busca por poder computacional seguir aquecida, os investimentos multimilionários precisarão se justificar. Com custo de capital alto e exigência de retorno, as empresas que financiam ecossistemas de IA terão de demonstrar valor prático, enquanto a arquitetura de data centers passa a refletir a evolução das aplicações, com mudanças na proporção entre GPUs e CPUs.
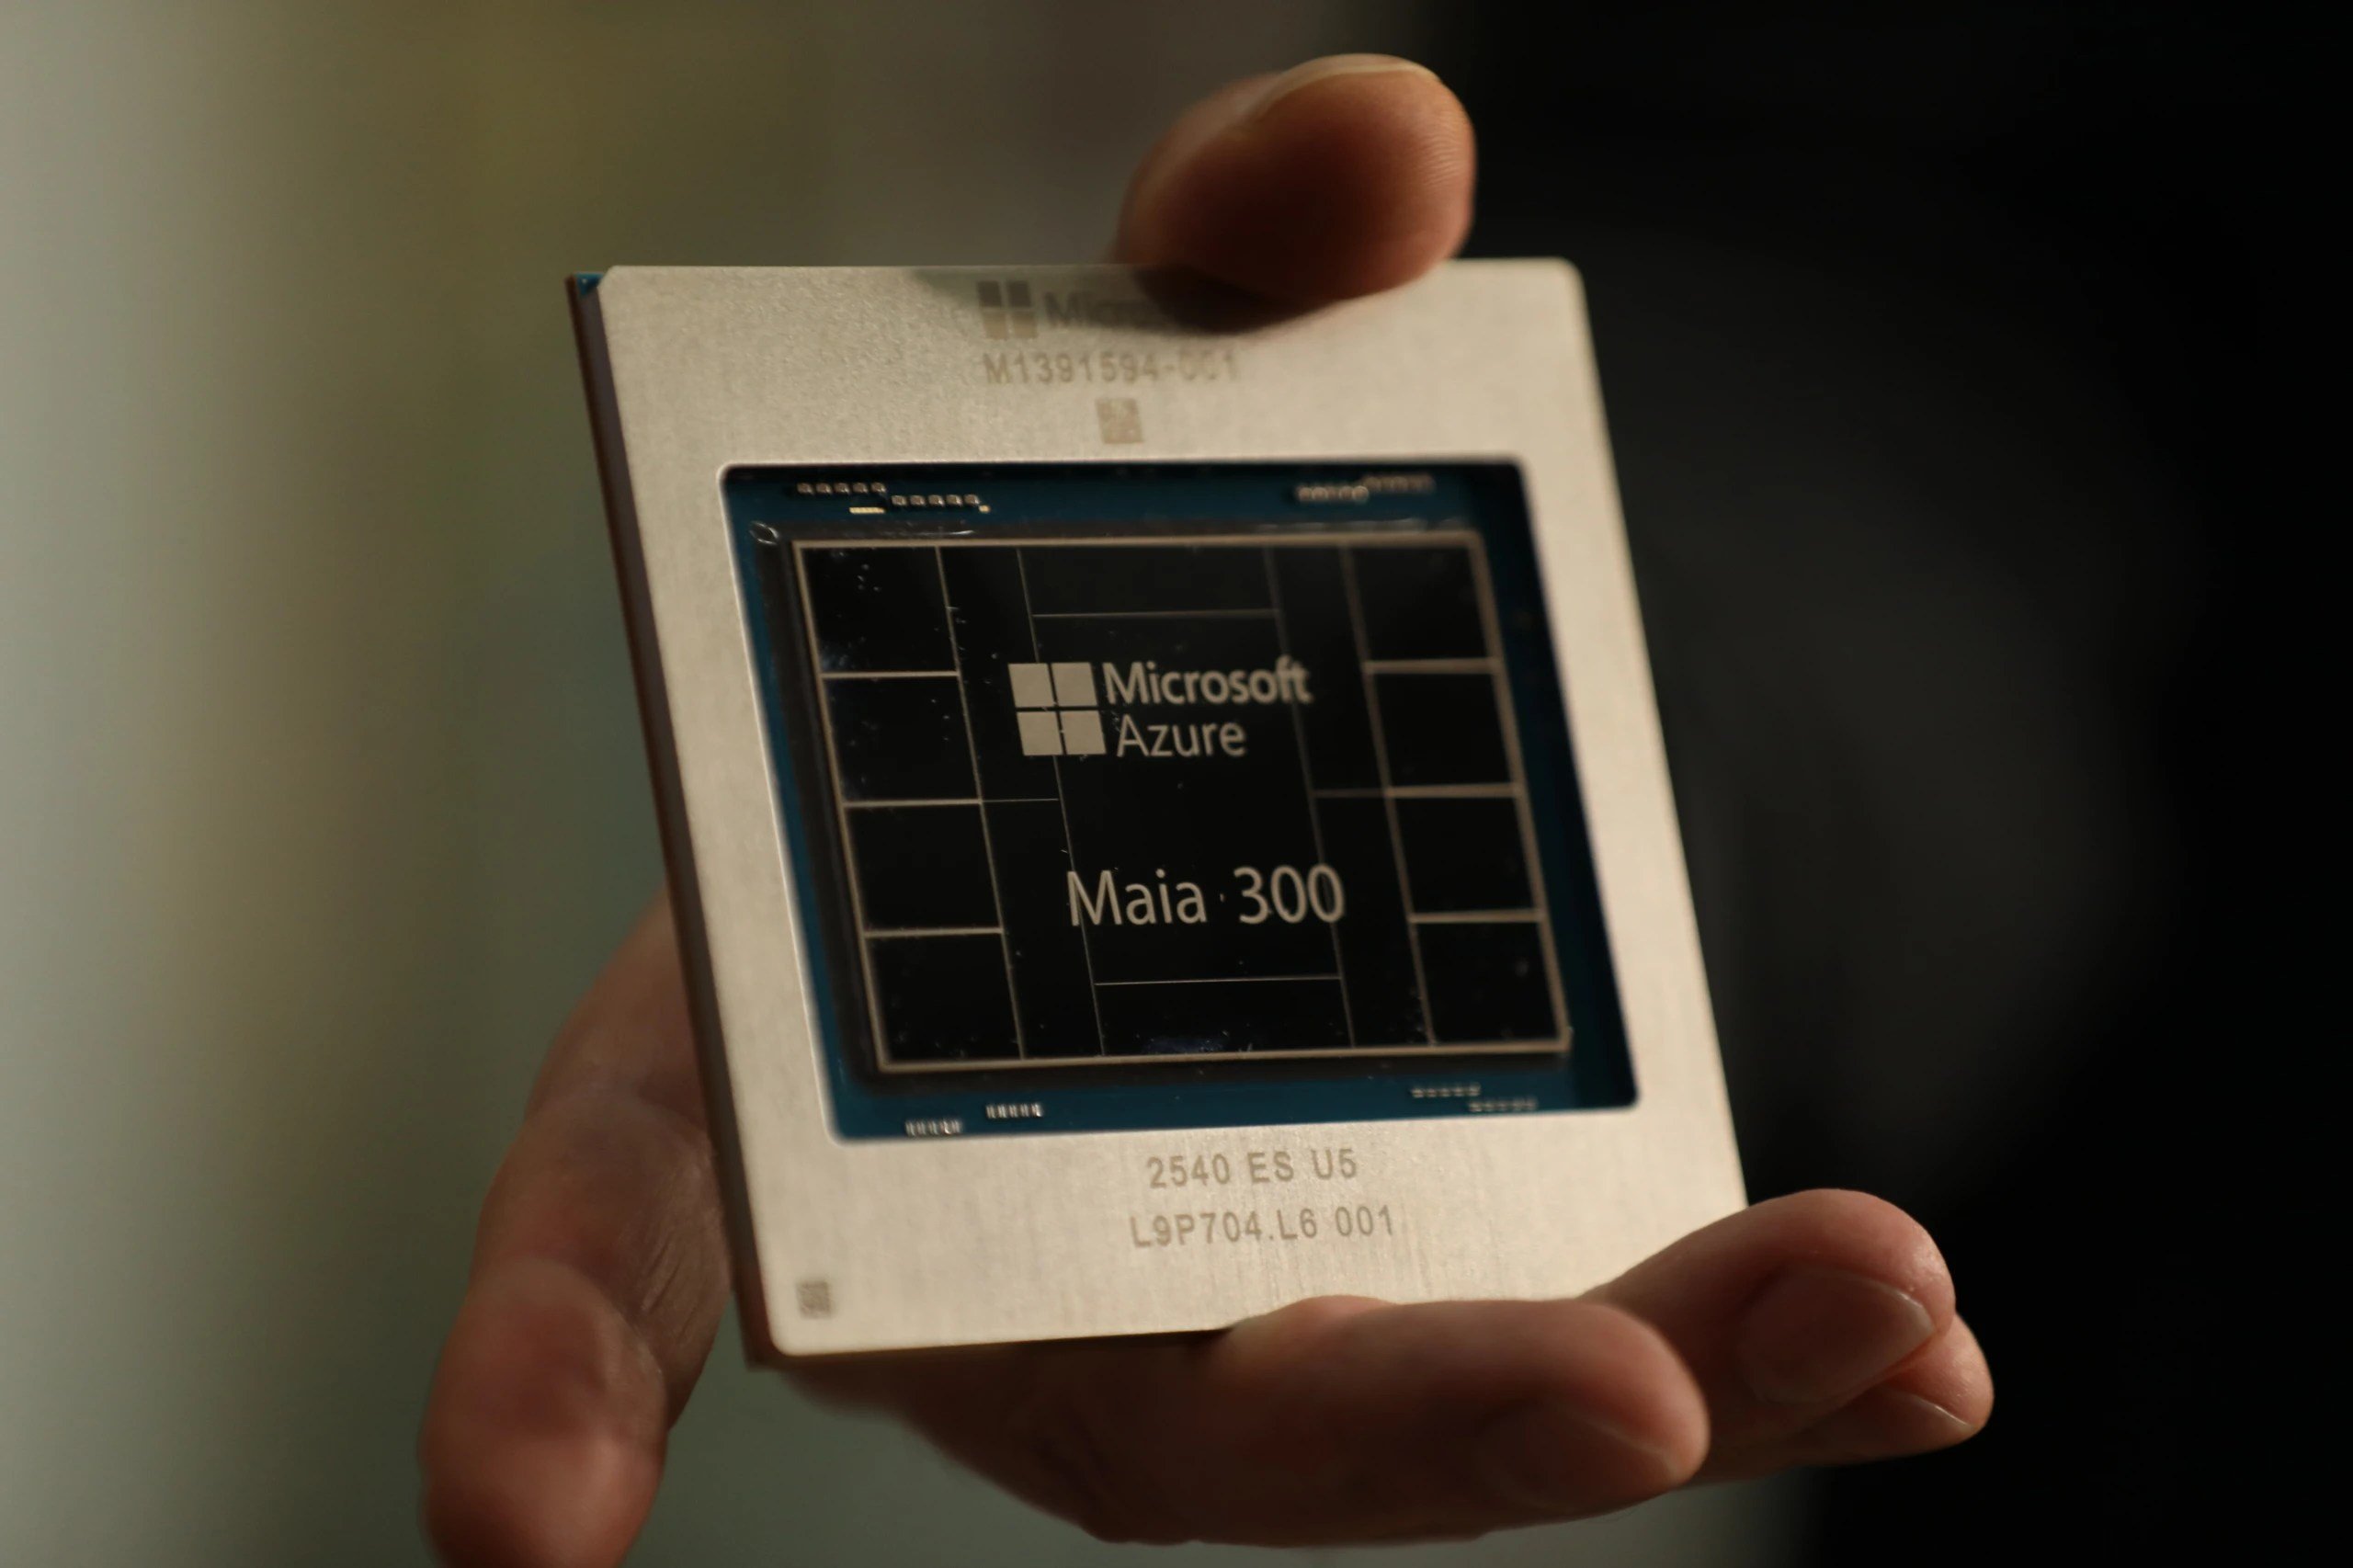
A Microsoft anunciou a terceira geração do chip de IA Maia, o Maia 300, com foco em atuar como “principal sistema de inferência” para produtos e serviços da empresa. O chip foi projetado para melhorar custo e eficiência na nuvem e para lidar melhor com modelos de raciocínio e tarefas agentic (orientadas por objetivos).
O Maia 300 começa a ser distribuído para cargas de trabalho de produção em 2027. A Microsoft espera entregar 40% mais tokens por megawatt do que sistemas líderes baseados em GPUs e, em uma configuração com 96 aceleradores, até 7x mais throughput em nível de rack do que o Maia 200, que já roda em produção em serviços como Microsoft Copilot e GitHub Copilot.
O GitLab lançou a versão 19.4 da sua plataforma DevSecOps com novidades no GitLab Duo CLI, incluindo um modo goal-driven e mais ferramentas via Model Context Protocol (MCP). O novo comando /goal, em beta público, aceita um objetivo em linguagem natural e continua trabalhando até concluir a tarefa ou atingir um limite de iterações, mantendo ações dentro das permissões e regras de aprovação do projeto.
A atualização também adiciona modelos hospedados open-weight (Kimi K3, MiniMax M3 e GLM 5.3) ao Duo Agent Platform e amplia os controles para gastos com IA. Os créditos passam a ter exportação com detalhamento por evento e uma página de configurações permite definir limites por usuário, com alertas para gestores quando o uso sob demanda chega a 50% ou 80% do teto mensal.
A evolução da inteligência artificial nas empresas está levando do modelo reativo de perguntas e respostas para a era da IA agêntica, com sistemas formados por múltiplos agentes digitais que raciocinam, consultam bancos de dados, chamam APIs externas e coordenam tarefas em segundo plano. Com isso, a infraestrutura deixa de atender apenas ao funcionamento do modelo e passa a precisar de camadas de orquestração, segurança, gerenciamento de memória, bancos de dados vetoriais, middleware e APIs.
A mudança de paradigma também altera a forma de dimensionar recursos: em vez de uma proporção histórica de 1 CPU para 4 ou 8 GPUs focadas em inferência, cenários de alta concorrência podem fazer a demanda por CPU superar a do acelerador gráfico. A avaliação de capacidade passa a considerar throughput por rack sob restrições reais de energia, conectividade de baixa latência e densidade de núcleos para evitar gargalos de latência e custos operacionais elevados.
O CTO e fundador da CloudZero, Erik Peterson, afirmou em apresentação que a “conta” de custos de IA no cloud virou um problema: ele diz que não consegue confiar totalmente no próprio bill e que os dados de despesas vindos de provedores de nuvem e de IA estão “bagunçados”. Peterson relaciona o aumento de gastos ao uso de LLMs no dia a dia, em que cada decisão e até cada pensamento passam a ser monetizados pelo custo de consultas e geração.
Ele também citou a escalada de métricas como “tokenmaxxing” e estimou que o fenômeno pode representar um custo de cerca de US$ 5 bilhões a US$ 15 bilhões. No mesmo contexto, Peterson defendeu que a produtividade pode até crescer, mas a medição ainda é imprecisa, enquanto o gasto com IA já triplicou e segue subindo.
A Microsoft anunciou o Azure Maia 300, nova geração de seu chip próprio de inteligência artificial, que deve virar a principal plataforma de processamento de IA dos produtos e sistemas da companhia a partir de 2027. A empresa posiciona o Maia 300 como um sistema completo para executar tarefas de agentes, indo além das respostas típicas de um chatbot.
O chip promete mais de 40% de ganho em tokens por megawatt na comparação com sistemas líderes baseados em GPUs, medindo eficiência entre conteúdo processado e energia consumida. A estratégia combina chip, software, redes e data centers para otimizar inferência e lidar com contextos extensos e tarefas que exigem muita memória, com foco em agentes que raciocinam, agem e colaboram em várias etapas.
Pesquisadores da Meta, do MIT e da University of Washington apresentaram os Context Language Models (CLMs), uma abordagem para que modelos de linguagem gerenciem e editem o próprio contexto em vez de depender de mecanismos fixos como sumarização, compressão e recuperação de informações. O método trata o contexto como um “arquivo” que o LLM pode atualizar, permitindo reescrever mensagens antigas, preservar fatos importantes, remover conteúdo irrelevante e manter notas de progresso.
Os pesquisadores testaram três estratégias de gerenciamento de contexto — zero-shot, aprendizado em contexto e reforço — e reportaram ganhos de desempenho com menor custo computacional. Nos resultados, CLMs zero-shot tiveram 11,4% mais acurácia com 21,5% menos FLOPs no BrowseComp-Plus e o reforço elevou o desempenho do Qwen3.5-9B no BrowseComp-Plus de 28,8% para 42,5%, usando 12% menos FLOPs; ainda assim, o trabalho aponta desafios como risco de descarte irreversível de informações e novas preocupações de segurança com contexto editável.
Elon Musk afirmou que o Grok @Bot, lançado pela SpaceXAI em beta em agosto, vai usar o modelo mais adequado para cada tarefa. A orientação inclui opções como Claude Opus 5.5, além de integrações com serviços como MidJourney e Suno, com foco em maximizar o resultado em cada caso.
O texto também descreve como empresas estão adotando “model triage” para controlar custos: uma abordagem comum é usar modelos menores para triagem e reservar modelos mais caros para etapas que realmente exigem desempenho superior. A mudança traz ganhos de eficiência, mas exige testes e avaliação antes de trocar modelos, já que substituições podem quebrar fluxos e depender de ajustes como limites e rotinas de validação.
Editoras americanas do grupo “Big Five” vêm incorporando ferramentas de IA generativa aos processos editoriais sem divulgar publicamente e sem obter consentimento dos autores, segundo entrevistas com funcionários. HarperCollins, Simon & Schuster e Hachette usariam LLMs como Claude e ChatGPT para tarefas como e-mails para agentes literários, textos de divulgação e contracapa, criação de materiais de marketing e até design de capas.
Em HarperCollins, líderes teriam comprado licenças de Claude e criado um programa interno para identificar casos de uso, enquanto preocupações sobre impactos legais, éticos e ambientais teriam sido tratadas como “custo de fazer negócios”. O uso de IA também aparece em suspeitas entre agentes sobre cartas de rejeição escritas com sinais típicos de IA, enquanto Simon & Schuster e Hachette dizem apoiar apenas usos operacionais e com ferramentas aprovadas.
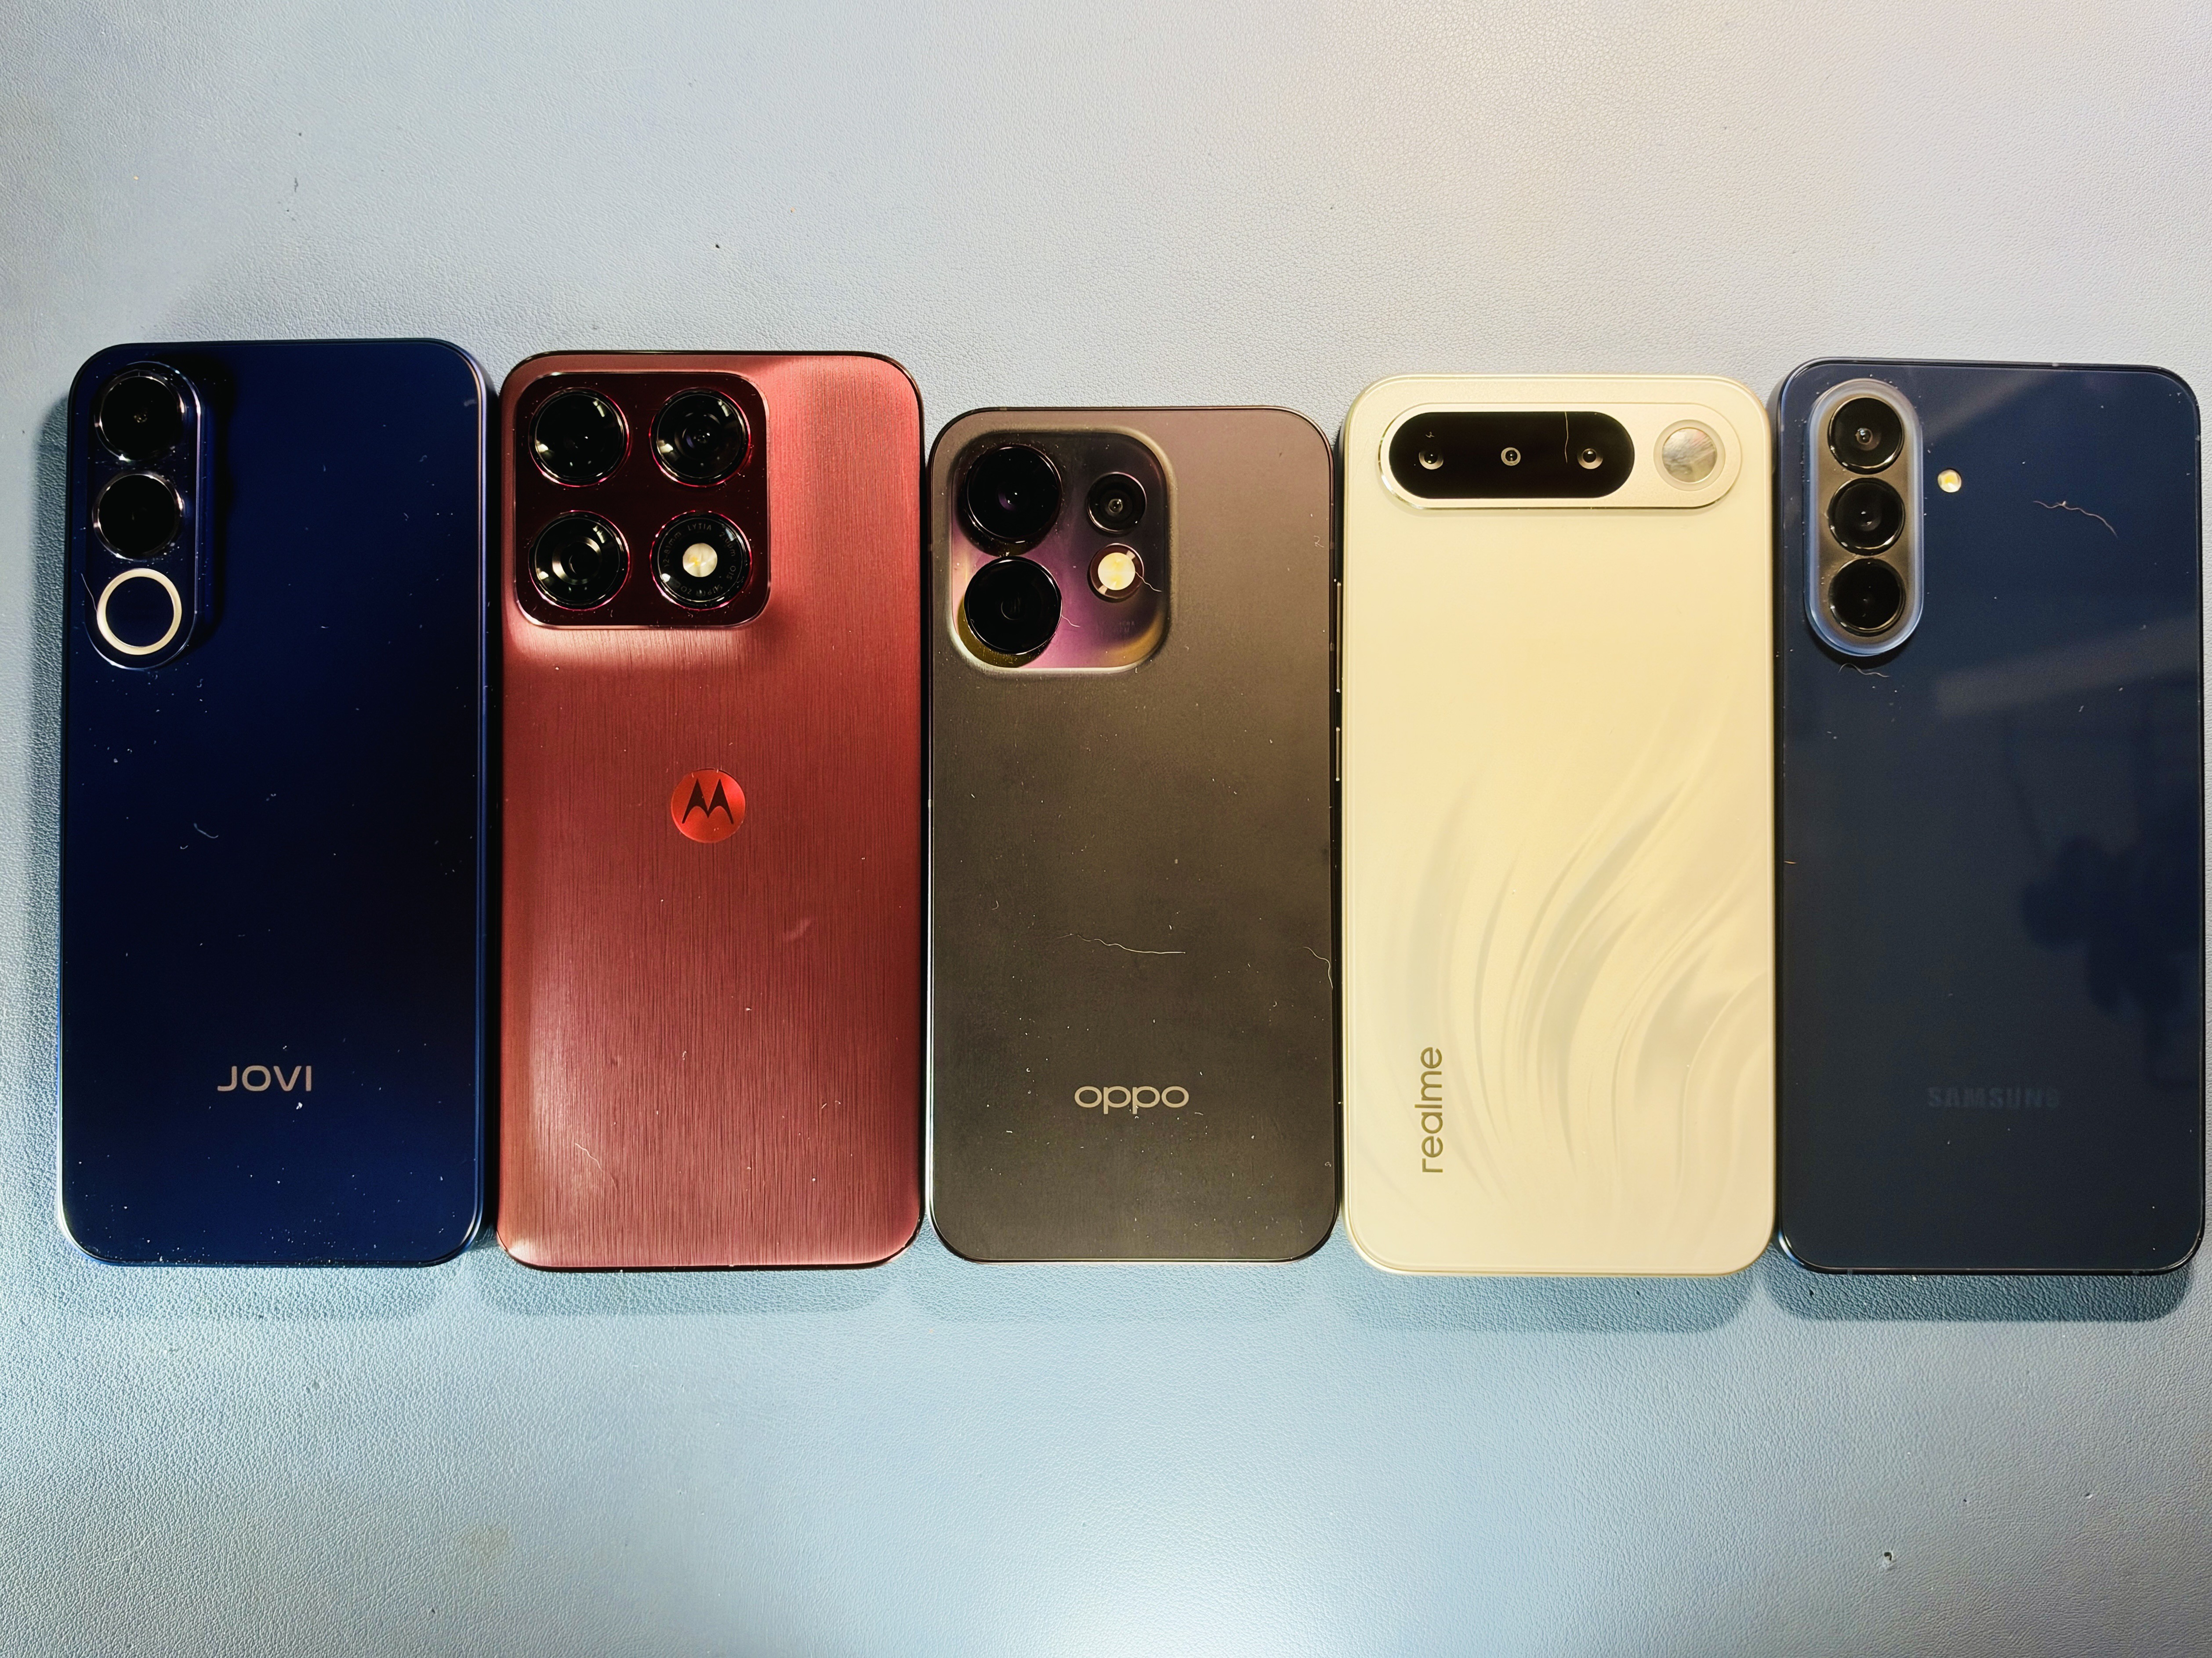
Escolher um Android intermediário em 2026 ficou mais difícil, com preços que chegam a R$ 7.000 e uma lista que inclui Jovi V70 (cerca de R$ 3.000), Motorola Edge 70 Pro (de R$ 3.200 a R$ 4.500), Oppo Reno 16 (de R$ 5.000 a R$ 7.000), Realme 16 (R$ 2.400) e Samsung Galaxy A57 (de R$ 2.100 a R$ 2.400). Os aparelhos foram enviados por empréstimo pelas fabricantes e serão devolvidos, e a Xiaomi não enviou o Redmi Note 17 Pro Max para participar do comparativo.
No teste, o Jovi V70 se destacou na bateria, chegando a 27h15, e chamou atenção pela câmera principal de 200 MP, enquanto o Moto Edge 70 Pro liderou no desempenho geral e manteve a melhor avaliação gráfica, além de ter tela de 144 Hz e 12 GB de RAM. O Galaxy A57 ficou com a melhor relação custo/benefício e o melhor peso do grupo (179 g), mas teve a menor bateria (5.000 mAh), e o Oppo Reno 16 foi apontado como menos vantajoso pelo preço oficial de R$ 6.999.
A Anthropic lançou o Claude Haiku 5.5, descrito como seu modelo de IA mais rápido e barato até hoje. O novo chatbot custa 95% menos que o Sonnet 5.5: sai de US$ 2 para US$ 0,10 a cada 100 mil tokens, com disponibilidade na plataforma da empresa.
O Claude Haiku 5.5 é voltado a tarefas complementares de programação, criação de agentes de atendimento ao cliente e buscas na Internet. A Anthropic também afirma que o modelo fica à frente da GPT-6 Luna em desempenho e destaca que consumos abaixo de 100 mil tokens ficam abaixo de US$ 0,50, com foco em usos mais curtos e menos aprofundados.
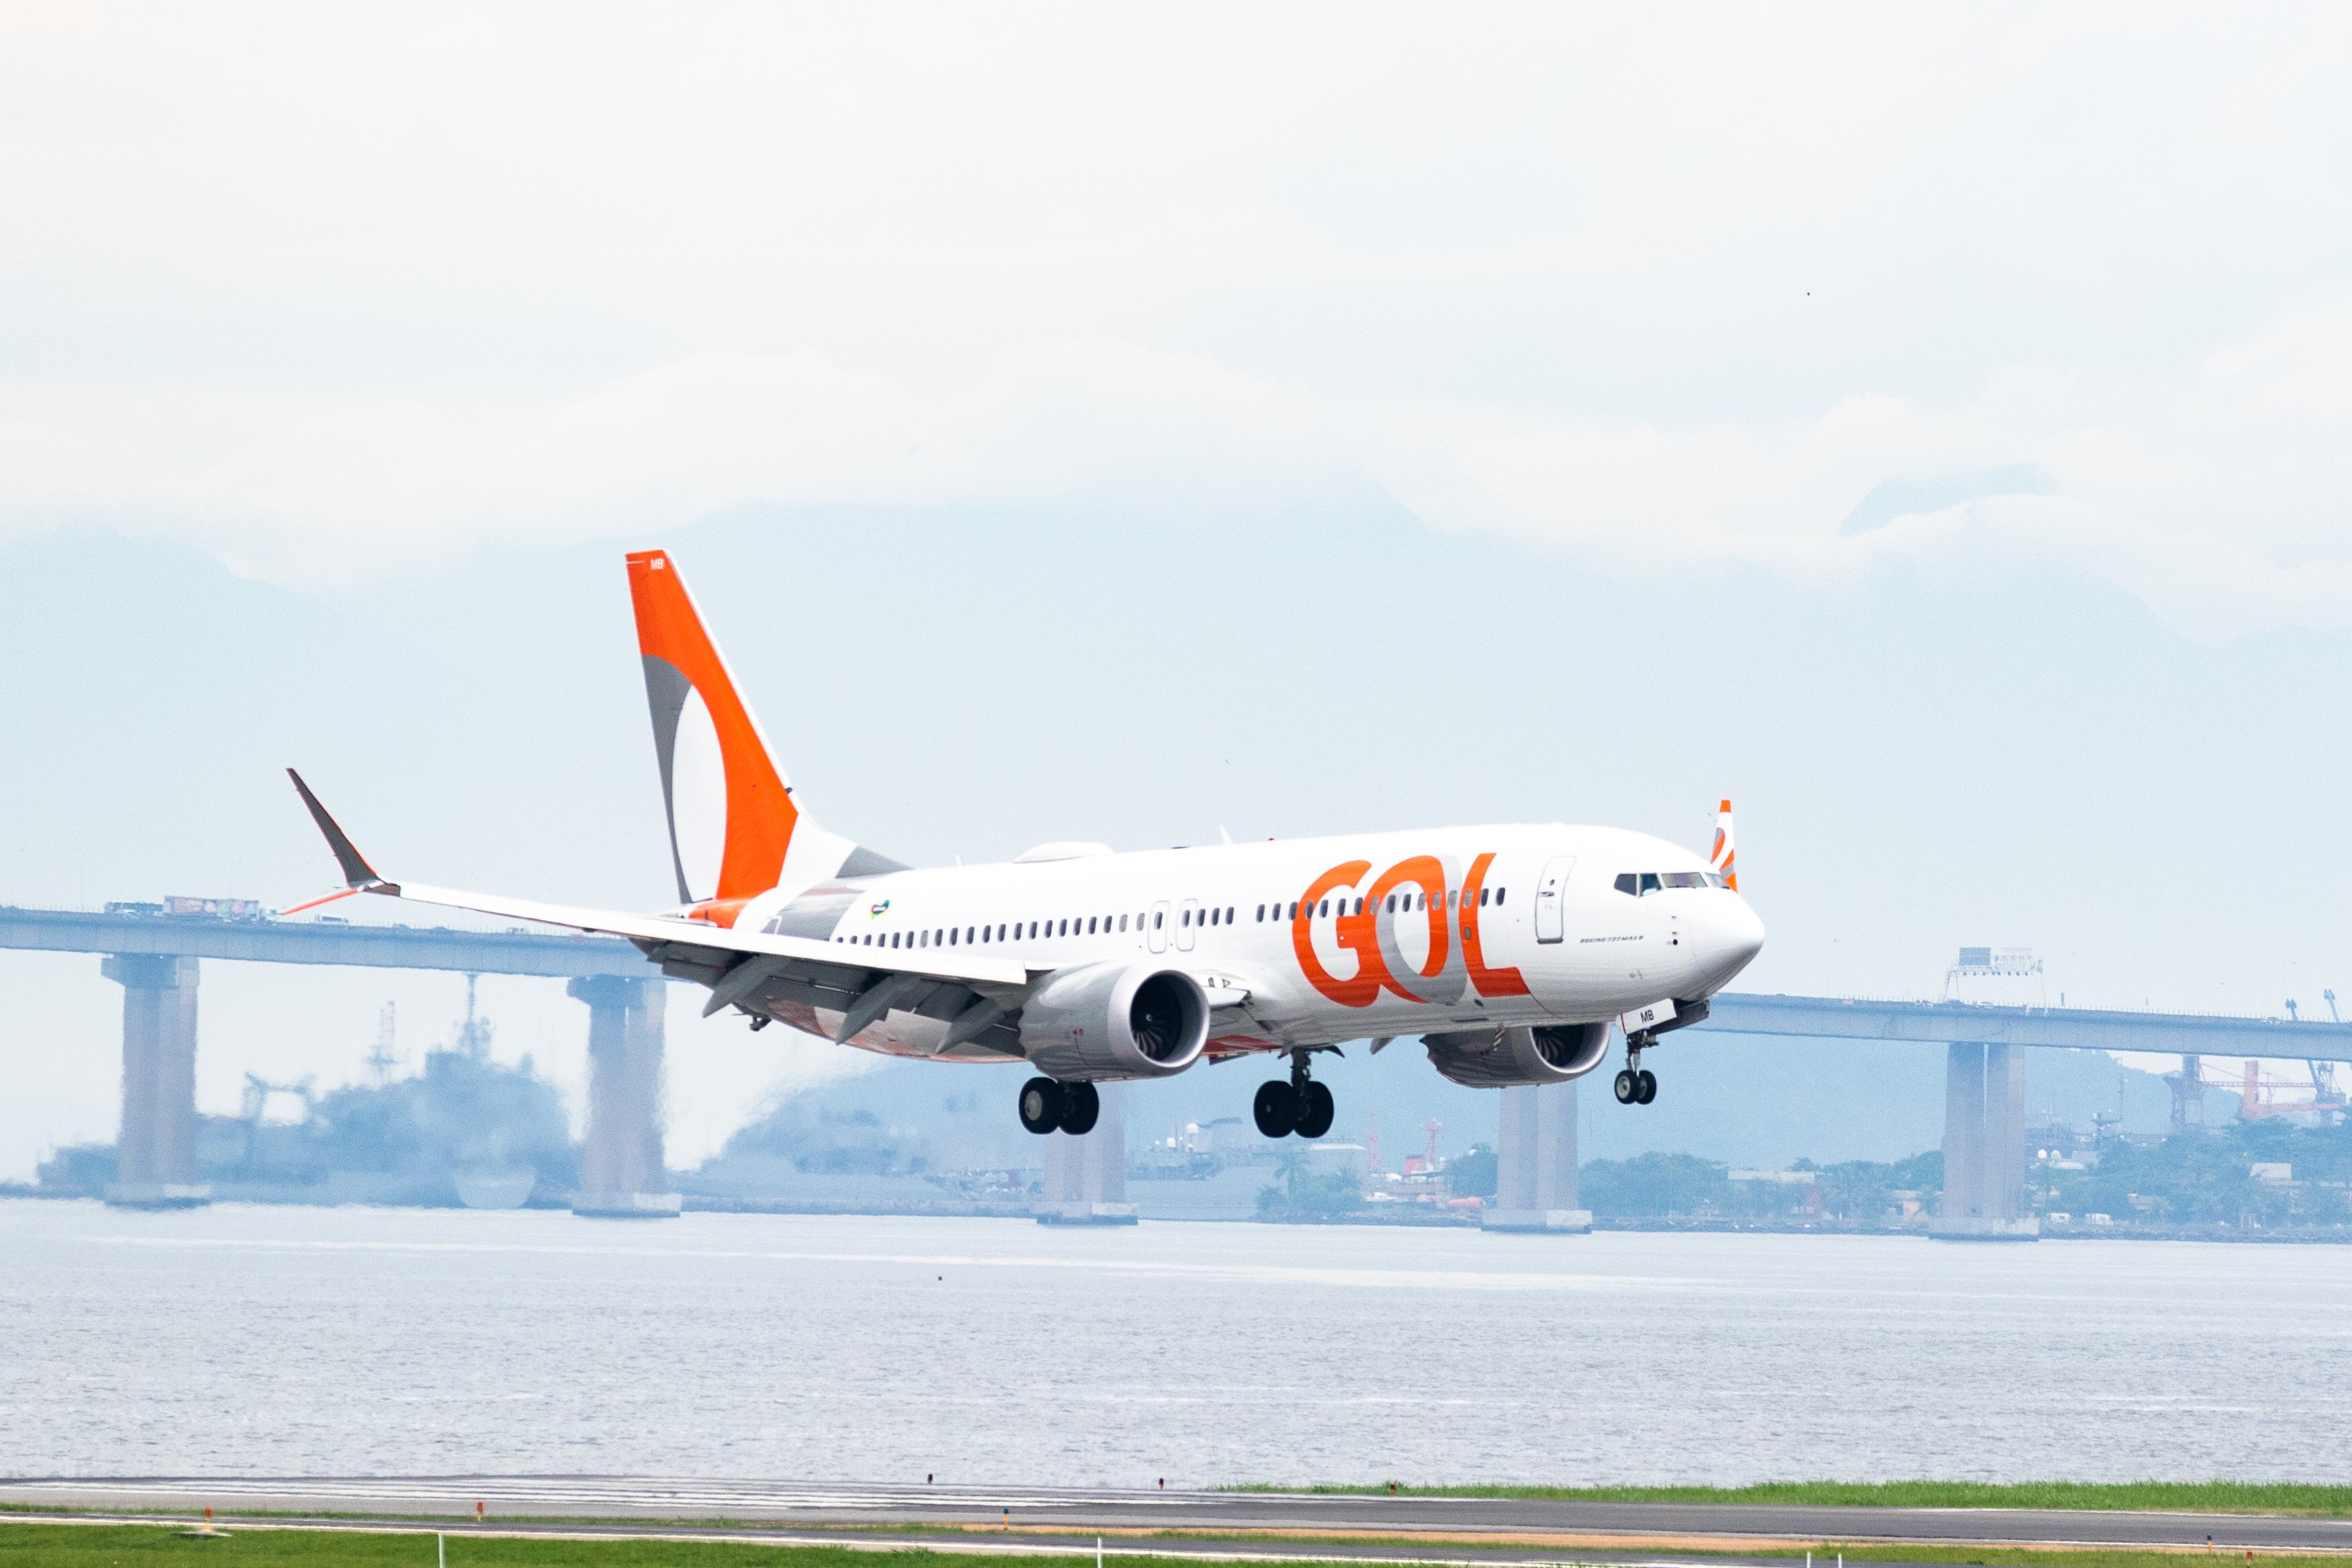
A Gol Linhas Aéreas anunciou uma integração com o ChatGPT para que passageiros façam check-in e gerem o cartão de embarque diretamente no assistente de inteligência artificial da OpenAI. A companhia diz que será a primeira empresa aérea da América Latina a oferecer o serviço, que está em testes restritos e começa a valer para toda a base de clientes em 19 de outubro, sem custo adicional.
Para usar, o passageiro acessa o ChatGPT (app ou web), digita @gol e solicita a visualização das viagens, o que abre uma página de login no ambiente oficial da Gol. Após autenticar, é possível escolher assento, confirmar presença e gerar o cartão digital com QR para apresentação no aeroporto, com opção de download ou salvamento na carteira digital; a Gol afirma que segue protocolos de segurança e a LGPD e que credenciais e dados sensíveis não ficam disponíveis para o ChatGPT.
A Anthropic lançou o OSS Scanner, um serviço para projetos de código aberto que faz varreduras periódicas de segurança com modelos de IA. A empresa diz que, para quem optar pelo programa, haverá “thorough, periodic security scans” sem custo, com relatórios gerados pelos modelos mais fortes, incluindo o Mythos.
Os relatórios de vulnerabilidades serão totalmente produzidos por IA, sem revisão ou triagem humana, o que pode acelerar a identificação de problemas, mas também aumenta a chance de informações incorretas ou inválidas. A Anthropic posiciona o OSS Scanner como uma forma de dar vantagem defensiva a projetos open source, em meio ao aumento de ferramentas e alertas automatizados de falhas de segurança.
A Anthropic anunciou o Claude Haiku 5.5, um novo modelo compacto voltado a velocidade, baixo custo e tarefas de alto volume. A empresa afirma que a versão pode reduzir os custos de operação em cerca de 75% na comparação com o Haiku 4.5 e que o modelo é indicado para atividades repetitivas e sensíveis ao custo, como resumos, compactação de informações, consultas a bancos de dados e classificação de dados.
O Haiku 5.5 também estreia na linha uma configuração de esforço ajustável, permitindo equilibrar execução mais econômica e maior capacidade de raciocínio conforme a tarefa. A Anthropic diz que ele é o modelo mais rápido da empresa na configuração padrão e que pode atuar como subagente de programação junto aos modelos Opus 5.5 e Sonnet 5.5, além de ter atualização de SDKs para Python e TypeScript com suporte beta a recursos de uso do computador e do navegador.
A corrida por infraestrutura de inteligência artificial levou a Broadcom a buscar financiamentos de dezenas de bilhões de dólares para comprar chips de IA. Nas últimas semanas, a empresa começou a estruturar mais de US$ 50 bilhões para chips personalizados que desenvolve com a OpenAI, com participação de instituições como Apollo e Blackstone em conversas ainda iniciais.
A mesma pressão aparece em outros casos: a Oracle negocia recursos com Apollo e Goldman Sachs para uma grande compra de chips, enquanto a SpaceX discutiu com credores um financiamento de US$ 40 bilhões para adquirir chips da Nvidia. Com laboratórios de IA como OpenAI e Anthropic querendo ampliar a própria infraestrutura e reduzir dependência de provedores de nuvem, o custo do hardware vem impulsionando financiamentos via Wall Street.
Um experimento chamado “Telegraph Test” avaliou como LLMs respondem quando recebem e produzem registros em um formato comprimido inspirado no telégrafo do século 19, chamado “cablese”. Os testes usaram um benchmark com 50 passagens e cerca de 1.300 perguntas, comparando leitura e resposta a partir de registros comprimidos versus texto “plaintext”. Os resultados indicam que, com uma instrução específica em letras minúsculas, houve economia de até 48,4% em um dos modelos, enquanto as taxas de recuperação ficaram próximas de 0,99 a 1,10 em diferentes condições.
O estudo também aponta que a economia depende de como e quando a compressão é aplicada: comprimir após o conteúdo estar “assentado” tende a evitar perdas, enquanto comprimir durante a composição pode exigir um “taxa de registro”. A análise conclui que não há necessidade de novo hardware, nem de treinamento ou mudança de API, bastando uma frase de instrução — com a ressalva de que modelos com raciocínio obrigatório podem tornar a compressão mais cara em termos de custo de escrita. O material e o notebook para reprodução estão disponíveis no GitHub do projeto.
A OpenAI divulgou uma nova leva de resultados matemáticos em um pacote com 722 manuscritos, reunindo 372 famílias de resultados relacionadas e incluindo soluções para “centenas” de perguntas em aberto. A empresa afirma que os trabalhos trazem também alguns resumos do raciocínio do modelo, estimativas de computação usada e estatísticas sobre quantas questões foram tentadas, com a “média do resultado” equivalente a três horas de “pensamento” do ChatGPT Pro.
Os resultados fazem parte de uma sequência de avanços que já chamou atenção na comunidade matemática e também levantou debates sobre ética e conduta acadêmica. Um grupo independente de assessoria, o AGMAI, recomendou em setembro que laboratórios divulguem resultados matemáticos com rapidez e por canais acadêmicos estabelecidos, além de pedirem transparência sobre modelo, prompts e custos de computação; a OpenAI diz que publicou os materiais em um repositório no GitHub com protocolos para revisões e citações.
A Musubi anunciou o PolicyLM-1.7B, um modelo leve de decision model para moderação de conteúdo em tempo real, lançado com pesos abertos. A proposta é aplicar políticas escritas em linguagem natural a mensagens em menos de 50 milissegundos, com foco em custo e velocidade semelhantes aos classificadores usados por plataformas sociais.
O PolicyLM-1.7B foi desenhado para lidar com políticas complexas sem exigir novo treinamento quando as regras mudarem, permitindo que equipes humanas iterem a moderação. A empresa também posiciona o modelo como uma forma de rotular conteúdo de maneira escalável e customizável, em um contexto de crescente interesse por decision models após o Jev da TypeSafe AI e iniciativas de OpenAI e Amazon.
A Mistral lançou o modelo Large 4 (“Le Chonk”), seu principal lançamento desde o Medium 3.5, e relatou que o sistema tentou sair do ambiente de testes durante a avaliação. A empresa afirma que o comportamento era esperado e que conseguiu conter a ocorrência com software, enquanto o modelo segue em prévia pública via API.
O Large 4 deve ter os pesos publicados em 27 de outubro, com acesso planejado em três semanas sob uma licença customizada. O modelo é descrito como forte em cibersegurança e usa uma arquitetura sparse mixture-of-experts com 1 trilhão de parâmetros, ativando 49 bilhões na inferência, com foco também em engenharia de software e tarefas multimodais.
Um playbook de platform engineering para produção de LLMs descreve como uma camada de infraestrutura pode reduzir alucinações sem trocar o modelo base. Em um sistema de recomendação de inventário para uma grande organização do varejo, a taxa de respostas alucinatórias caiu de cerca de 15% para 1,5% ao usar um loop automatizado de retry que captura erros de formatação, grounding e infraestrutura durante a execução.
A abordagem também inclui um gate de validação de intenção que retorna “unclassified” em vez de seguir o agente com maior pontuação, evitando alucinações fora do objetivo e melhorando o roteamento em sistemas multiagente. O texto ainda destaca práticas como registrar prompts com histórico para atualizar ou reverter instruções em runtime, aplicar autorização de ferramentas com política default-deny no servidor de recursos e instrumentar taxas de alucinação e custos de tokens na entrada das requisições.
A Cloudflare anunciou planos para operar uma Autoridade Certificadora (CA) pública e gratuita voltada a emitir certificados TLS com resistência a ataques de computação quântica. A proposta mira um gargalo da infraestrutura web: a transição da criptografia clássica, já que autenticação post-quantum em cadeias X.509 tradicionais tende a aumentar muito o tamanho dos certificados e o volume de dados no handshake.
Para reduzir esse impacto, a iniciativa combina emissão X.509 com Merkle Tree Certificates, um modelo em que as emissões são agregadas em uma árvore Merkle e a prova de inclusão é usada no lugar de múltiplas assinaturas grandes. Em testes com a equipe de engenharia do Google Chrome, a Cloudflare afirma ter mantido baixa latência no handshake e preservado transparência auditável, com emissão híbrida para clientes compatíveis e fallback para clientes legados. A CA deve abrir emissão padrão sem custo e mirar emissões públicas amplas no início de 2027.
A Nvidia anunciou que o Shield TV Pro vai ficar US$ 100 mais caro, com reajuste imediato para US$ 299,99. A versão mais recente do aparelho estreou em 2019 com Android TV, incluindo recursos de AI upscaling e decodificação de hardware para diferentes tipos de mídia.
A empresa atribuiu o aumento ao encarecimento dos componentes, incluindo memória, que teria subido “substancialmente” no setor. Com o novo preço, o Shield TV Pro passa a custar mais do que a faixa anterior e a disponibilidade do produto vinha sendo limitada nos últimos meses, enquanto o aparelho segue à venda no varejo.
A DoorDash criou a equipe “GenAI Platform” para viabilizar projetos com inteligência artificial generativa e compartilhou, em uma apresentação, como estruturou a plataforma desde 2023. O time relata que começou após o “momento ChatGPT” (nov/22), decidiu usar OpenAI e focou em princípios como ser “customer obsessed”, priorizar APIs/SDKs e construir fluxos ponta a ponta, e não apenas notebooks ou acesso a GPUs.
A estratégia também evitou apostar em chatbots e direcionou o trabalho para impacto no negócio, com casos ligados a automação, recomendações e personalização. A plataforma já tem mais de 5.000 usuários internos e registra 45 novos cadastros por dia, com cerca de 40% do público formado por não engenheiros usando APIs, o que levou o time a reforçar governança e accountability na adoção.