A Spotify ampliou o uso de desenvolvimento assistido por IA e mais que dobrou as mudanças mensais mescladas, de cerca de 8.100 para 17.000 ano a ano em agosto. Com o aumento do volume de alterações nos sistemas de produção, a empresa ajustou controles de qualidade e confiabilidade para lidar com a nova escala.
A companhia opera quase 3.000 serviços de produção para 777 milhões de usuários ativos mensais e relata desafios em processamento de conteúdo, automação de frota e capacidade de computação. Entre as respostas estão melhorias em monitoramento e testes, salvaguardas de rollout e capacidade de rollback, além da adoção do Honk, um agente de codificação em background que executa o Claude via Agent SDK em pods no Kubernetes.
Pesquisadores apresentaram na conferência KDD o estudo “GEO: Generative Engine Optimization”, voltado a melhorar a visibilidade de conteúdos nas respostas de mecanismos generativos. Nos testes descritos, intervenções específicas aumentaram a presença em até 40%, variando conforme o tema pesquisado.
O movimento é comparado ao SEO, mas com uma diferença: ao perguntar a uma inteligência artificial, muitas vezes o usuário recebe uma resposta pronta em vez de uma lista de opções. O texto destaca ainda como a construção de um “rastro público” — entrevistas, artigos, participações e fontes — pode influenciar o que sistemas como os buscadores associados ao ChatGPT encontram e citam, exigindo que assessorias e relações públicas considerem como esses dados são lidos e organizados.
A Starlink já permite que celulares se conectem diretamente aos satélites por meio da tecnologia Direct to Cell, sem a antena usada no serviço residencial. A proposta evoluiu de mensagens de texto para acesso a dados e chamadas via aplicativos, com operação feita em parceria com operadoras de telefonia que disponibilizam parte das frequências.
No Brasil, Vivo e Starlink participam de um ambiente experimental autorizado pela Anatel, com permissão válida até abril de 2029, mas ainda sem oferta comercial ampla. Enquanto isso, a SpaceX recebeu autorização da FCC para implantar até 15 mil satélites de nova geração, com novas frequências para ampliar cobertura e capacidade, inclusive em ambientes internos, aproximando a tecnologia de serviços móveis mais avançados.
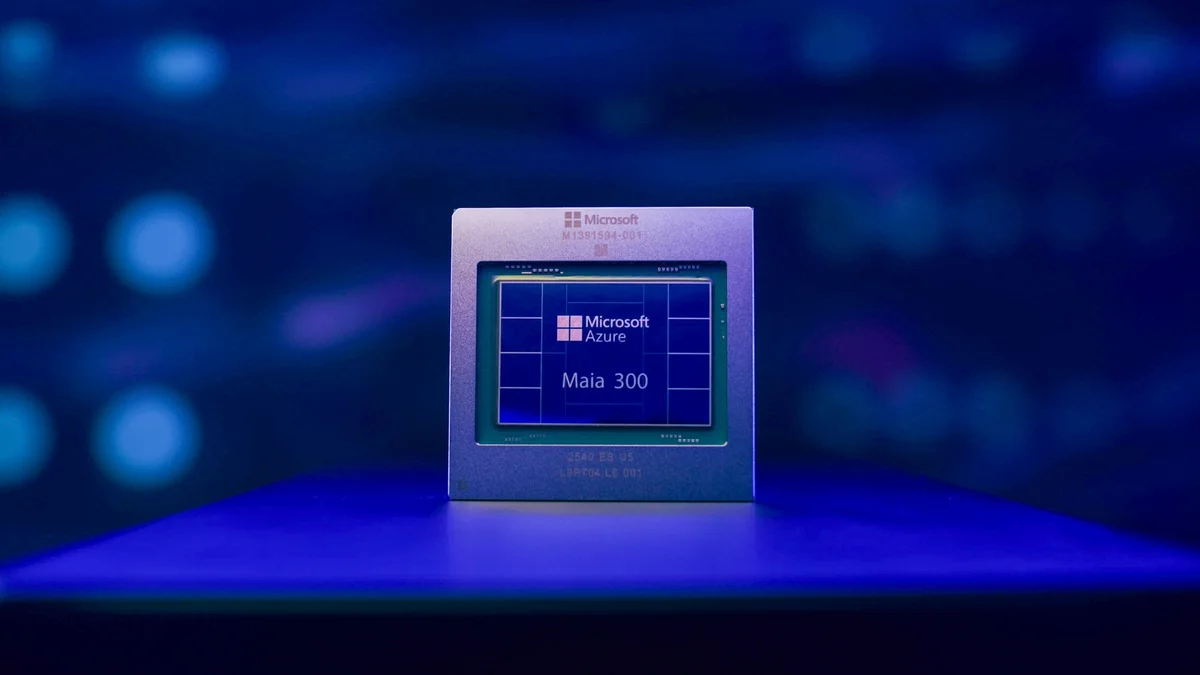
A Microsoft revelou o Maia 300, novo chip de IA para servidores, com foco em aumentar a eficiência energética no processamento de inferência. O componente promete processar 40% mais tokens por megawatt do que infraestruturas baseadas em GPUs, permitindo atender mais demandas de IA com a mesma capacidade elétrica.
O Maia 300 dá sequência ao Maia 200 e é voltado para conversas extensas, tarefas que exigem raciocínio e agentes capazes de executar várias ações em sequência. A arquitetura usa chiplets fabricados no processo N2P da TSMC, organiza componentes para manter dados próximos do uso e traz 288 GB de memória HBM4 por acelerador, além de uma configuração completa com 96 aceleradores e promessa de até sete vezes mais tokens que um rack Maia 200; a implantação está prevista para começar em 2027.
A Shopify apresentou o Gisting, uma técnica para comprimir prompts longos de LLM em um conjunto menor de tokens “gist” aprendidos, com foco em aumentar o throughput e reduzir o custo de inferência. A empresa afirma que, durante o uso, a substituição do texto extenso por gist tokens reduz a latência ponta a ponta e melhora a taxa de processamento sem alterar os pesos centrais do modelo.
No Sidekick, o sistema prompt caiu de cerca de 6.000 tokens para 1.500 gist tokens, mantendo a qualidade das previsões. Com 350 requests por minuto, o tempo para o primeiro token (TTFT) passou de 438 ms para 354 ms, a latência end-to-end caiu de 6,8 s para 4,2 s e o throughput subiu de 20,2 para 23,4 QPS, permitindo reduzir a alocação de GPUs.
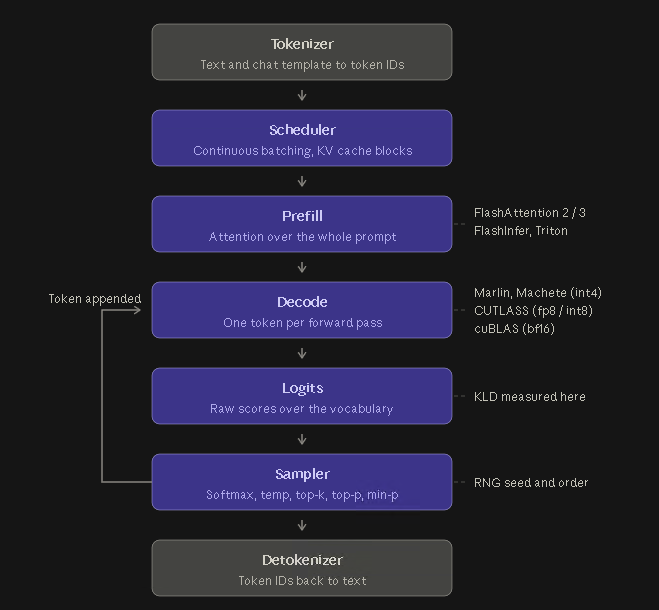
Usuários que baixam modelos locais, inclusive versões quantizadas, podem ter a impressão de que o LLM “fica pior” do que o esperado. O texto explica que cada combinação de hardware e software executa a inferência de forma diferente, alterando como as probabilidades do próximo token são calculadas e convertidas em texto durante o decode.
A recomendação é medir o desempenho com benchmarks que representem o uso real, evitando testes curtos e zero-shot com poucos prompts. Também é destacada a cautela com alegações de baixa KLD em cards de modelos quantizados, já que interpretar esses números depende de detalhes como ambiente de execução, checkpoints de referência e metodologia completa.
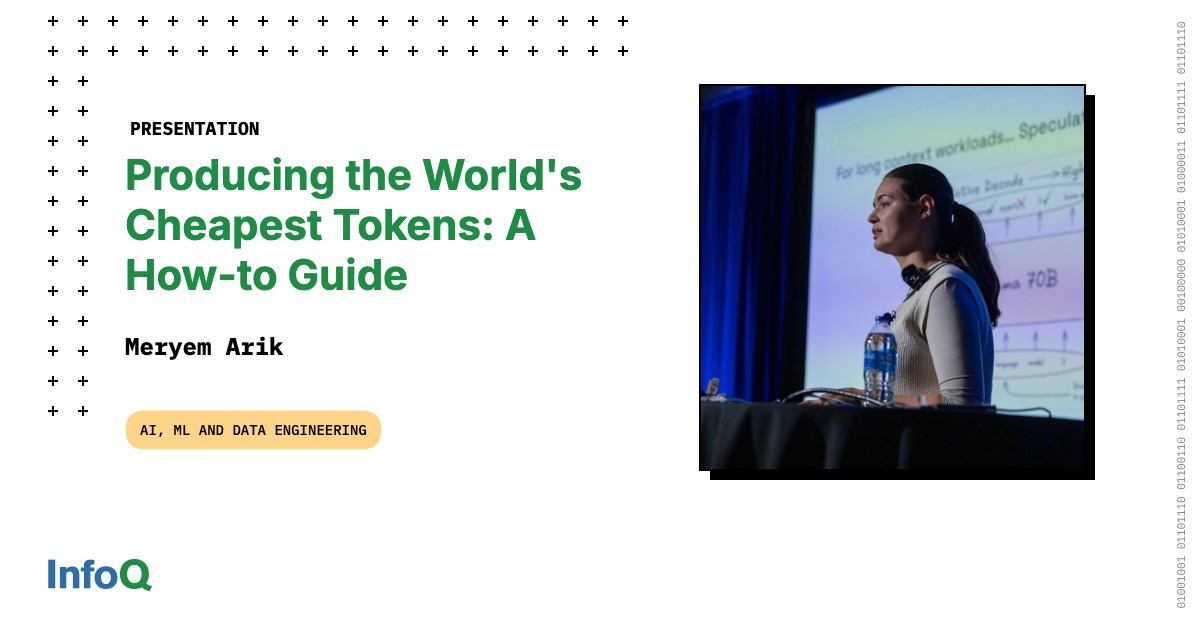
Meryem Arik, da Doubleword, apresentou um guia para desenhar sistemas de inferência do zero com foco em produzir tokens pelo menor custo possível. Ela destaca que muitas empresas pagam 2x a 5x a mais na inferência por não alinharem a “inference stack” ao caso de uso e às prioridades de cada aplicação.
A apresentação descreve o espaço de trade-offs entre latência, custo e qualidade, e como escolher estratégias diferentes conforme o objetivo. Para workloads não em tempo real, como processamento de dados, agentes offline, sumarização, rotulagem e geração de dados sintéticos, o caminho passa por otimizações como batch, reordenação de filas e escalonamento inteligente, em vez de priorizar ultra-baixa latência.