A Spotify ampliou o uso de desenvolvimento assistido por IA e mais que dobrou as mudanças mensais mescladas, de cerca de 8.100 para 17.000 ano a ano em agosto. Com o aumento do volume de alterações nos sistemas de produção, a empresa ajustou controles de qualidade e confiabilidade para lidar com a nova escala.
A companhia opera quase 3.000 serviços de produção para 777 milhões de usuários ativos mensais e relata desafios em processamento de conteúdo, automação de frota e capacidade de computação. Entre as respostas estão melhorias em monitoramento e testes, salvaguardas de rollout e capacidade de rollback, além da adoção do Honk, um agente de codificação em background que executa o Claude via Agent SDK em pods no Kubernetes.
Pesquisadores apresentaram na conferência KDD o estudo “GEO: Generative Engine Optimization”, voltado a melhorar a visibilidade de conteúdos nas respostas de mecanismos generativos. Nos testes descritos, intervenções específicas aumentaram a presença em até 40%, variando conforme o tema pesquisado.
O movimento é comparado ao SEO, mas com uma diferença: ao perguntar a uma inteligência artificial, muitas vezes o usuário recebe uma resposta pronta em vez de uma lista de opções. O texto destaca ainda como a construção de um “rastro público” — entrevistas, artigos, participações e fontes — pode influenciar o que sistemas como os buscadores associados ao ChatGPT encontram e citam, exigindo que assessorias e relações públicas considerem como esses dados são lidos e organizados.
A Starlink já permite que celulares se conectem diretamente aos satélites por meio da tecnologia Direct to Cell, sem a antena usada no serviço residencial. A proposta evoluiu de mensagens de texto para acesso a dados e chamadas via aplicativos, com operação feita em parceria com operadoras de telefonia que disponibilizam parte das frequências.
No Brasil, Vivo e Starlink participam de um ambiente experimental autorizado pela Anatel, com permissão válida até abril de 2029, mas ainda sem oferta comercial ampla. Enquanto isso, a SpaceX recebeu autorização da FCC para implantar até 15 mil satélites de nova geração, com novas frequências para ampliar cobertura e capacidade, inclusive em ambientes internos, aproximando a tecnologia de serviços móveis mais avançados.
A evolução da inteligência artificial nas empresas está levando do modelo reativo de perguntas e respostas para a era da IA agêntica, com sistemas formados por múltiplos agentes digitais que raciocinam, consultam bancos de dados, chamam APIs externas e coordenam tarefas em segundo plano. Com isso, a infraestrutura deixa de atender apenas ao funcionamento do modelo e passa a precisar de camadas de orquestração, segurança, gerenciamento de memória, bancos de dados vetoriais, middleware e APIs.
A mudança de paradigma também altera a forma de dimensionar recursos: em vez de uma proporção histórica de 1 CPU para 4 ou 8 GPUs focadas em inferência, cenários de alta concorrência podem fazer a demanda por CPU superar a do acelerador gráfico. A avaliação de capacidade passa a considerar throughput por rack sob restrições reais de energia, conectividade de baixa latência e densidade de núcleos para evitar gargalos de latência e custos operacionais elevados.
A Spotify Ads apresentou no QCon AI uma plataforma multiagente que automatiza a criação de anúncios a partir de instruções do anunciante, reduzindo tarefas como copywriting e geração de conteúdo musical. O sistema roda em produção no Spotify Ads Manager e, desde o lançamento do ano passado, mais de 70% dos anúncios passaram a usar ferramentas de IA, com cerca de 20.000 criativos gerados para mais de 7.000 anunciantes.
A arquitetura inclui um gateway de LLM via Vertex AI e um orquestrador de agentes com agentes paralelos, como um para geração de scripts e outro para aplicar guardrails de políticas. A solução também extrai intenções do texto natural para definir segmentação e usa camadas de moderação e padronização do ambiente, com controle de dependências e monitoramento integrado para rodar a IA com baixa latência e segurança.
Durante a “Birthday Week”, a Cloudflare anunciou a Clef, uma linha de modelos open-weight voltados a escolher entre opções pré-definidas em vez de gerar texto. Foram lançados modelos com 9B e 27B parâmetros, incluindo uma Clef multimodal de 27B que recebe um estado e um esquema de perguntas tipadas e devolve decisões com probabilidades para cada opção permitida.
A proposta é permitir que agentes usem o resultado para decidir como agir, como roteamento de solicitações de suporte, escalonamento ou adiamento para um humano. A empresa também lançou a Clef-Flash (9B), com latência mediana de 38,8 ms nos benchmarks da Cloudflare, e disponibilizou a tecnologia via Workers AI e pesos para download no Hugging Face, além de planejar fine-tuning para casos como triagem de suporte e classificação de bots.
A Cloudflare anunciou planos para operar uma Autoridade Certificadora (CA) pública e gratuita voltada a emitir certificados TLS com resistência a ataques de computação quântica. A proposta mira um gargalo da infraestrutura web: a transição da criptografia clássica, já que autenticação post-quantum em cadeias X.509 tradicionais tende a aumentar muito o tamanho dos certificados e o volume de dados no handshake.
Para reduzir esse impacto, a iniciativa combina emissão X.509 com Merkle Tree Certificates, um modelo em que as emissões são agregadas em uma árvore Merkle e a prova de inclusão é usada no lugar de múltiplas assinaturas grandes. Em testes com a equipe de engenharia do Google Chrome, a Cloudflare afirma ter mantido baixa latência no handshake e preservado transparência auditável, com emissão híbrida para clientes compatíveis e fallback para clientes legados. A CA deve abrir emissão padrão sem custo e mirar emissões públicas amplas no início de 2027.
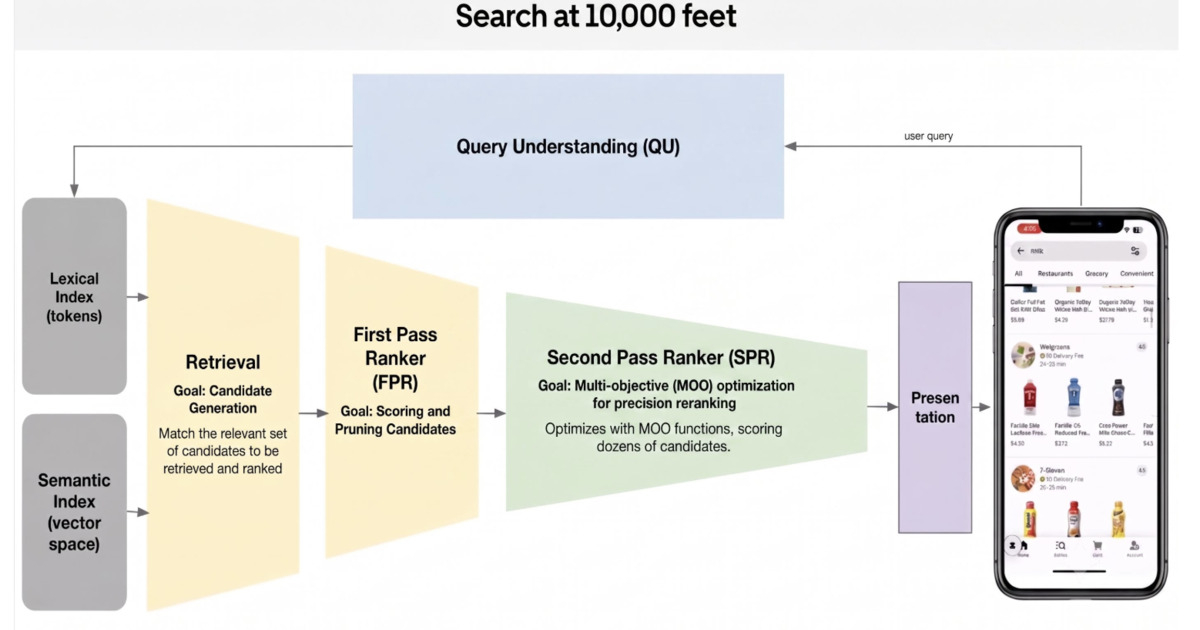
A Uber refez partes importantes do pipeline de busca do Uber Eats e relata uma redução de 50% na latência fim a fim. As mudanças atravessam recuperação (retrieval), hidratação de features, ranking, caminho de anúncios, apresentação e infraestrutura, com uso de um fluxo de coding agentic para identificar, benchmarkar e validar otimizações adicionais.
A empresa também trocou o foco do indicador principal: em vez de medir o tempo de resposta de APIs, passou a acompanhar o Above-the-Fold completion, tempo até a primeira tela de resultados com imagens. Com paginação e cache no servidor, renderização assíncrona e ajustes como descarte de candidatos de baixo valor, embeddings de produto e separação entre hidratação de ranking e apresentação, a Uber diz ter melhorado o Above-the-Fold em mais de 200 ms e cortado etapas específicas em dezenas de milissegundos, além de redesenhar o caminho de anúncios e reduzir overhead de infraestrutura.
A Cloudflare lançou dois modelos de decisão, Clef e Clef-flash, treinados pela empresa e hospedados no Workers AI. A proposta é entregar saídas estruturadas e tipadas de forma determinística, para serem usadas em fluxos que exigem decisões programáticas, com compatibilidade via Jev-API. A empresa também disponibilizou os modelos no Hugging Face sob licença Apache 2.0 para rodar localmente.
Além do uso direto nos modelos hospedados, a Cloudflare anunciou um produto de reinforcement learning (RL) para permitir que clientes façam fine-tuning do Clef para seus casos de uso. Em testes internos com Threat Intelligence, a classificação de domínios levou 2,2s usando Clef, enquanto um LLM geral (gpt-oss-120b) levou 4,7s e retornou apenas duas classificações, com a empresa destacando ganhos de latência e mais resultados para decisões rápidas.
Agentes de IA que “passam” em demos podem falhar quando chegam ao mundo real por causa de dados inconsistentes, fontes diferentes, mudanças frequentes de informação e desafios como permissões de sistema. Mesmo quando retrieval e RAG funcionam no ambiente controlado, o agente pode não ter o contexto de negócios necessário para tomar ações com base em informações atuais e confiáveis.
No dia 14 de outubro, Ravi Marwaha, COO e Chief Product & Technology Officer da Arango, vai explicar seis requisitos de dados para tirar agentes da fase de demonstração e preparar a arquitetura para produção. O conteúdo inclui exemplos sobre clientes que aparecem de formas diferentes em sistemas distintos, necessidade de entender “por que” uma decisão foi tomada e como manter governança e contexto unificado para reduzir latência, custos e trabalho manual.
O guia de prompting do Claude Opus 5.5 detalha padrões específicos para extrair melhor desempenho do modelo. A documentação afirma que o Claude Opus 5.5 gera tokens de saída mais de 30% mais rápido que o Claude Opus 5 e costuma concluir a mesma tarefa com menos tokens, sem exigir mudanças nos prompts existentes do Opus 5.
A orientação também destaca como calibrar o “effort”, principal controle para o quanto o modelo pensa, equilibrando inteligência, latência e custo. O texto recomenda começar no nível médio (padrão do Opus 5.5), testar níveis com as próprias avaliações e ajustar limites como max_tokens para evitar cortes em turnos longos e agentic.
A Qualcomm defendeu no Rio Innovation Week 2026 o uso de Edge AI para processar tarefas diretamente em celulares e computadores. A proposta busca reduzir a latência, diminuir a dependência da internet e permitir que dados sensíveis fiquem no próprio dispositivo, com exemplos como tradução em tempo real, resumo de documentos e edição de fotos.
O executivo Diego Aguiar, head de vendas e IoT da Qualcomm no Brasil, também afirmou que agentes de IA devem executar tarefas com supervisão humana quando houver decisões relevantes. A empresa diz avaliar novas funções por critérios como resolver um problema real, responder rápido sem gastar bateria e garantir que o usuário entenda e controle o uso dos próprios dados.
A NVIDIA lançou o Nemotron 3 Diarization, um modelo open-weight com 100M de parâmetros para diarização de fala em tempo real e em gravações. Ele transforma conversas com sobreposição em dados com identificação de quem falou e quando, permitindo gerar transcrições atribuídas por participante.
O modelo alcançou o 1º lugar no VoiceArena Diarization-Bench, com 14,72% de Diarization Error Rate (DER), e suporta até oito falantes. Também foi treinado com dados públicos e licenciados, incluindo áudio licenciado da David AI, e usa processamento em blocos com opções de latência customizáveis para cenários streaming e offline.
Um engenheiro do LinkedIn descreveu como a empresa usa “context engineering” para criar uma camada de contexto organizacional que ajuda agentes de IA a depurar incidentes em serviços críticos. No exemplo, um alerta de aumento de latência é enviado a um coding agent como o GitHub Copilot, que busca instruções, analisa logs, métricas e mudanças recentes e identifica a causa em um serviço downstream com muitos erros.
O agente também gera um resumo detalhado com a raiz do problema e os próximos passos, atualiza o sistema de incidentes e cria uma PR para mitigar a falha. Segundo o relato, o fluxo ocorre em poucos minutos e substitui tarefas que levariam horas, apoiado por “Contextual Agent Playbooks and Tools” e por centenas de workflows automatizados.
Agentes de IA da Perplexity ajudaram a construir o CobbleDB, um banco de dados key-value em Rust criado para substituir o DynamoDB. A empresa decidiu trocar o serviço depois de considerar que pagava caro e tinha pouca flexibilidade para controlar o desempenho de leitura no seu tráfego de busca.
Com apoio de centenas de agentes de programação ao longo do desenvolvimento, o CobbleDB passou a atender parte do tráfego de produção. A Perplexity reportou latência mediana de batch-read de 5,6 ms (contra 31,4 ms no DynamoDB) e p99 de 24,2 ms (antes 123 ms), além de estimar custo pelo menos 20% menor e planejar abrir o código em algum momento.
A TypeSafe, fundada por um co-inventor do ChatGPT, saiu do modo stealth e lançou o modelo Jev para automatizar decisões programáticas com uma arquitetura de parallel sampling. Voltado a sistemas que precisam de lógica determinística, o Jev executa decisões probabilísticas estruturadas diretamente em bases de código de produção, sem depender de geração de texto.
O modelo recebe um estado não estruturado e retorna valores estruturados tipados em uma única consulta paralela, com restrição a schemas predefinidos para reduzir falhas de tipo e “alucinações” por desenho. A empresa também descreve treinamento com Reinforcement Learning for Calibrated Decisions (RLCD), além de testes com latências de 70–500 ms e acesso antecipado para desenvolvedores.
Agentes de voz enfrentam um problema de latência quando precisam executar tarefas reais, e Google e OpenAI lançaram soluções diferentes em poucos dias. A Google colocou no ar o Gemini 3.8 Live e o Gemini 3.8 Live Extended Thinking via Gemini API e Google AI Studio, enquanto a OpenAI lançou o GPT-Live-1 para manter a conversa em tempo real enquanto o trabalho acontece em segundo plano.
No Gemini 3.8 Live Extended Thinking, fala, raciocínio e execução de ferramentas ficam dentro de uma mesma sessão com chamadas assíncronas não bloqueantes, permitindo que o modelo continue falando. Já o GPT-Live-1 separa a conversa do raciocínio e das tool calls em uma camada de backend, exigindo mais orquestração na aplicação para coordenar contexto e lidar com interrupções, além de impactar custos e cobrança por minuto.
Agentes de IA podem ficar repetindo chamadas a ferramentas erradas sem disparar alertas de disponibilidade, dificultando a identificação do que deu errado. Em post do CNCF publicado em 4 de agosto, a StackGen descreveu como session traces e cost controls ajudam equipes a investigar loops de execução e gastos inesperados em fluxos autônomos.
A StackGen usa o Langfuse para registrar cada chamada de LLM, execução de ferramentas e delegação a subagentes como spans com latência e custos de tokens, preservando a cadeia de delegação em workflows multiagentes. O texto também recomenda limites rígidos de iterações e de chamadas por ferramenta antes da execução, bloqueios para solicitações consecutivas idênticas e métricas exportadas com cuidado para evitar alta cardinalidade, além de revisões pós-incidente com logs pesquisáveis e ferramentas de diagnóstico via linha de comando.
A OpenAI apresentou o ChatGPT Images 2.5, novo modelo de geração de imagens com melhorias em qualidade, edição e velocidade. A empresa afirma que o sistema foi ajustado para produzir iluminação mais natural, texturas mais detalhadas e maior fidelidade ao trabalhar com imagens de referência.
Segundo a OpenAI, a latência de geração foi reduzida em até 50% em comparação com o Images 2.0. O modelo já está disponível para usuários do ChatGPT, ChatGPT Work e Codex em desktop, dispositivos móveis e web.
O modelo GPT-6 Astra, da OpenAI, foi disponibilizado na OpenRouter como “flagship” para tarefas avançadas de ponta a ponta, incluindo análise, engenharia de software, pesquisa profunda e criação de documentos. Ele é indicado para agentes de IA com uso de computador e navegador ao longo de horizontes longos.
O GPT-6 Astra custa US$ 10 por 1M tokens de entrada e US$ 50 por 1M tokens de saída, com preços separados para Cache Read, Cache Write e Web Search. A OpenRouter roteia as requisições entre provedores (OpenAI e Azure) com modos de balanceamento e failover automático, além de oferecer métricas como throughput, latência e uptime; o lançamento ocorreu em 4 de setembro de 2026.
A Shopify apresentou o Gisting, uma técnica para comprimir prompts longos de LLM em um conjunto menor de tokens “gist” aprendidos, com foco em aumentar o throughput e reduzir o custo de inferência. A empresa afirma que, durante o uso, a substituição do texto extenso por gist tokens reduz a latência ponta a ponta e melhora a taxa de processamento sem alterar os pesos centrais do modelo.
No Sidekick, o sistema prompt caiu de cerca de 6.000 tokens para 1.500 gist tokens, mantendo a qualidade das previsões. Com 350 requests por minuto, o tempo para o primeiro token (TTFT) passou de 438 ms para 354 ms, a latência end-to-end caiu de 6,8 s para 4,2 s e o throughput subiu de 20,2 para 23,4 QPS, permitindo reduzir a alocação de GPUs.
Agentes de voz baseados em inteligência artificial já são usados em operações de vendas, suporte e atendimento ao consumidor, e devem ganhar ainda mais espaço em 2026. Nessa modalidade, o cliente liga, explica o problema e recebe resposta quase imediata, sem que necessariamente exista um atendente humano do outro lado.
A tecnologia automatiza etapas como tirar dúvidas, consultar informações, acompanhar pedidos e conduzir processos de venda, incluindo suporte com consulta a sistemas conectados e triagem de solicitações como agendamentos, cobranças e pesquisas de satisfação. A adoção, porém, depende de fatores como latência para evitar “silêncio” durante a ligação, capacidade de interpretar interrupções, sotaques e ruídos, além do cálculo de custos com infraestrutura, integrações e supervisão humana.
A indústria de IA usa o conceito de “efficient frontier” para descrever tradeoffs entre custo e capacidade dos modelos, e aplica a mesma lógica à inferência. Na prática, engenheiros de inferência ajustam pontos do sistema entre latência e throughput para reduzir custos, ou trocam qualidade por throughput com técnicas como quantização, distilação e poda.
O texto também separa abordagens que apenas movem o deployment ao longo da fronteira das que empurram a fronteira inteira, liberando mais eficiência para decidir onde alocar ganhos. Entre os exemplos citados estão batch sizing, estratégias de paralelismo (como Tensor Parallelism, Expert Parallelism e Attention Data Parallelism), além de otimizações de kernels e runtime e o uso de speculative decoding para aumentar desempenho no ciclo de geração.
A Alibaba Cloud lançou nesta quinta-feira (27) sua primeira região de nuvem no Brasil, com dois data centers dedicados a empresas, startups, desenvolvedores e instituições públicas. A iniciativa marca a primeira operação da divisão de computação em nuvem da Alibaba na América do Sul e integra um compromisso global de US$ 53 bilhões em investimentos em infraestrutura de inteligência artificial.
A nova região deve oferecer o portfólio completo de nuvem, com foco em baixa latência e adequação às regras locais de cibersegurança e proteção de dados. A companhia também planeja levar ao Brasil serviços de IA agêntica, incluindo ACS Agent Sandbox, DAS Agent e DataWorks Data Agent, além de ferramentas de segurança como o AI Security Guardrails 2.0.
A Alibaba Cloud lançou nesta quinta-feira (27) sua primeira região de nuvem no Brasil, com dois data centers voltados a empresas, startups, desenvolvedores e instituições públicas. A iniciativa marca a primeira operação da companhia na América do Sul e amplia sua presença na América Latina após a região do México, em fevereiro de 2025.
A nova região oferece computação, armazenamento, contêineres, redes, segurança, bancos de dados e serviços cloud-native com foco em baixa latência, disponibilidade e conformidade regulatória. A empresa também planeja trazer serviços de IA agêntica para o ciclo de vida do agente — incluindo desenvolvimento, depuração, implantação e segurança — como o ACS Agent Sandbox, o DAS Agent e o Agent Security Center.
Um desenvolvedor criou um “companheiro de IA” de baixa latência chamado Varkos que joga Skyrim junto com o jogador, com foco em respostas rápidas e execução confiável de ações no mundo do jogo. Em vez de depender apenas de diálogo, o sistema registra gatilhos futuros, aguarda eventos e continua planos quando o estado do mundo muda, sem roteiros pré-programados.
O Varkos também busca itens no cenário, resolve tarefas em múltiplas etapas (como pegar poções e entregá-las), gerencia objetivos persistentes como esconde-esconde e participa de combates com controle corporal nativo e eventos do jogo. A personalidade evolui ao longo do tempo com base em interações, e o projeto prevê levar o companheiro para além do Skyrim, usando um “void mode” quando o jogo fecha.
IA em tempo real em escala é mais difícil do que parece: pipelines que funcionam bem no desenvolvimento podem falhar em produção, com problemas como aumento de latência e queda de acurácia. Em um app de trading baseado em ML, a latência P99 disparou para 3 segundos quando o sistema chegou a cerca de 740 mil operações por segundo, apesar de a média parecer aceitável. O diagnóstico apontou que a lentidão não estava no modelo, mas em buscas e contenção sob carga, com o Postgres sendo pressionado no cenário específico.
A precisão também pode piorar quando os dados ficam desatualizados: perfis de usuários (wallet addresses) ultrapassaram uma SLA de 5 minutos por horas, embeddings ficaram obsoletos e métricas offline continuaram boas até a integração com dados online. Além disso, índices vetoriais precisam de manutenção, já que reembeddings degradam a qualidade do índice ao longo do tempo, reduzindo recall para 42% e elevando a latência de consulta. O texto ainda destaca que treinamento e serving devem ser separados quando possível e que retraining é inevitável, exigindo transição para evitar janelas de previsões defasadas.
Serviços como ChatGPT, Claude e Gemini popularizaram o uso de IA via navegador, mas o processamento em data centers faz com que qualquer PC dependa da internet para resumir textos, gerar códigos e criar imagens. Com isso, a indústria passou a apostar nos AI PCs, máquinas com componentes dedicados para acelerar tarefas de IA no próprio dispositivo.
A proposta mira três pontos: manter dados sensíveis no armazenamento local, reduzir a dependência de conexão com latência praticamente zero e melhorar eficiência energética com a NPU (Unidade de Processamento Neural). Para cargas mais pesadas, GPUs dedicadas também ganham destaque, enquanto o modelo híbrido aponta a nuvem para tarefas ultra complexas e o PC para o que exige privacidade e resposta imediata.
A DoorDash desenvolveu o SafeChat para lidar com abusos verbais no chat do marketplace, onde consumidores, entregadores (Dashers) e comerciantes se comunicam durante pedidos. A empresa afirma que precisa agir com baixa latência: são mais de 4 milhões de mensagens por dia e existe apenas uma fração de segundo para decidir se cada mensagem é segura, sem prejudicar a experiência.
O sistema combina uma etapa inicial com um classificador de ML treinado com dados internos, capaz de responder em menos de 100 ms em 90% dos casos e com custo apenas de infraestrutura. Para o pequeno volume de mensagens que não passam nessa triagem (menos de 10%), o SafeChat chama um LLM para pontuar e classificar eixos como nível de ameaça, grau de palavrões e conteúdo sexual, usando perguntas mais difíceis apenas quando necessário.
O CTO da Huawei Cloud na América Latina, Bin Duan, afirma que comparar modelos de IA apenas pelo preço por token é uma forma incompleta de estimar gastos. Ele diz que o custo de uma aplicação depende de variáveis como tokens de entrada e saída, tamanho do contexto, uso de cache, volume de chamadas e complexidade da tarefa, o que pode levar a economias de até 80% e 89% conforme o cenário.
A lógica sustenta o Model as a Service (MaaS), que oferece acesso a diferentes modelos de IA por uma infraestrutura em nuvem. A Huawei também prevê desconto de 30% em horário de menor demanda para os modelos GLM 5.1 e GLM 5.2, além de integrar capacidade computacional, software de IA e operações em nuvem, com avaliação por latência, throughput, estabilidade, custo e qualidade do resultado.
A Stripe concordou em adquirir a OpenRouter, uma plataforma de roteamento de modelos de IA que permite que desenvolvedores acessem centenas de modelos por uma única interface. Segundo a Stripe, a OpenRouter oferece suporte a mais de 400 modelos de mais de 80 provedores, permitindo enviar requisições por uma só API sem integrações separadas com cada fornecedor.
A plataforma avalia requisições com base em fatores como complexidade da tarefa, preço, velocidade e confiabilidade, direcionando cada pedido ao modelo mais adequado. Além disso, faz uma segunda camada de roteamento entre provedores que atendem ao mesmo modelo, com suporte a critérios como custo, throughput e latência, além de failover quando endpoints ficam indisponíveis, e integra isso ao trabalho da Stripe com uso de IA e cobrança baseada em tokens.
O modelo GPT-5.6 Sol, da série GPT-5.6 da OpenAI, passou a ter preço 50% menor no OpenRouter, com valores de US$ 2,50 de entrada e US$ 15 por 1M de contexto. O modelo é descrito como voltado a raciocínio complexo, tarefas de codificação e fluxos com agentes, com destaque para atividades no terminal e problemas de múltiplas etapas.
O OpenRouter também destaca métricas de desempenho como throughput de 36 tokens por segundo e latência de 3,25s no P50, além de disponibilidade monitorada por provedores. A plataforma roteia as requisições entre diferentes empresas conforme o modo escolhido (Balanced, Nitro ou Exacto) e pode redirecionar para um provedor saudável quando ocorre erro.
Arquitetura evolutiva usa fitness functions para transformar intenção arquitetural em feedback executável contínuo, com checagens determinísticas como regras de dependência, testes de contrato, limites de latência e varreduras de segurança. O texto aponta que nem toda preocupação arquitetural cabe em regras, limiares ou métricas, como quando mudanças passam nos testes, mas geram acoplamento acidental ou “drift” semântico.
Nesse contexto, surgem as agentic fitness functions: uma camada de governança em que um agente de IA, calibrado com registros de decisão, metadados de ownership, limites de serviço e rubricas, avalia evidências delimitadas e devolve um veredito estruturado com score, confiança, justificativa e orientação de escalonamento. A proposta separa gates determinísticos de sinais consultivos do agente, aplica rubricas versionadas e encaminha casos de baixa confiança ou alto impacto para revisão humana.