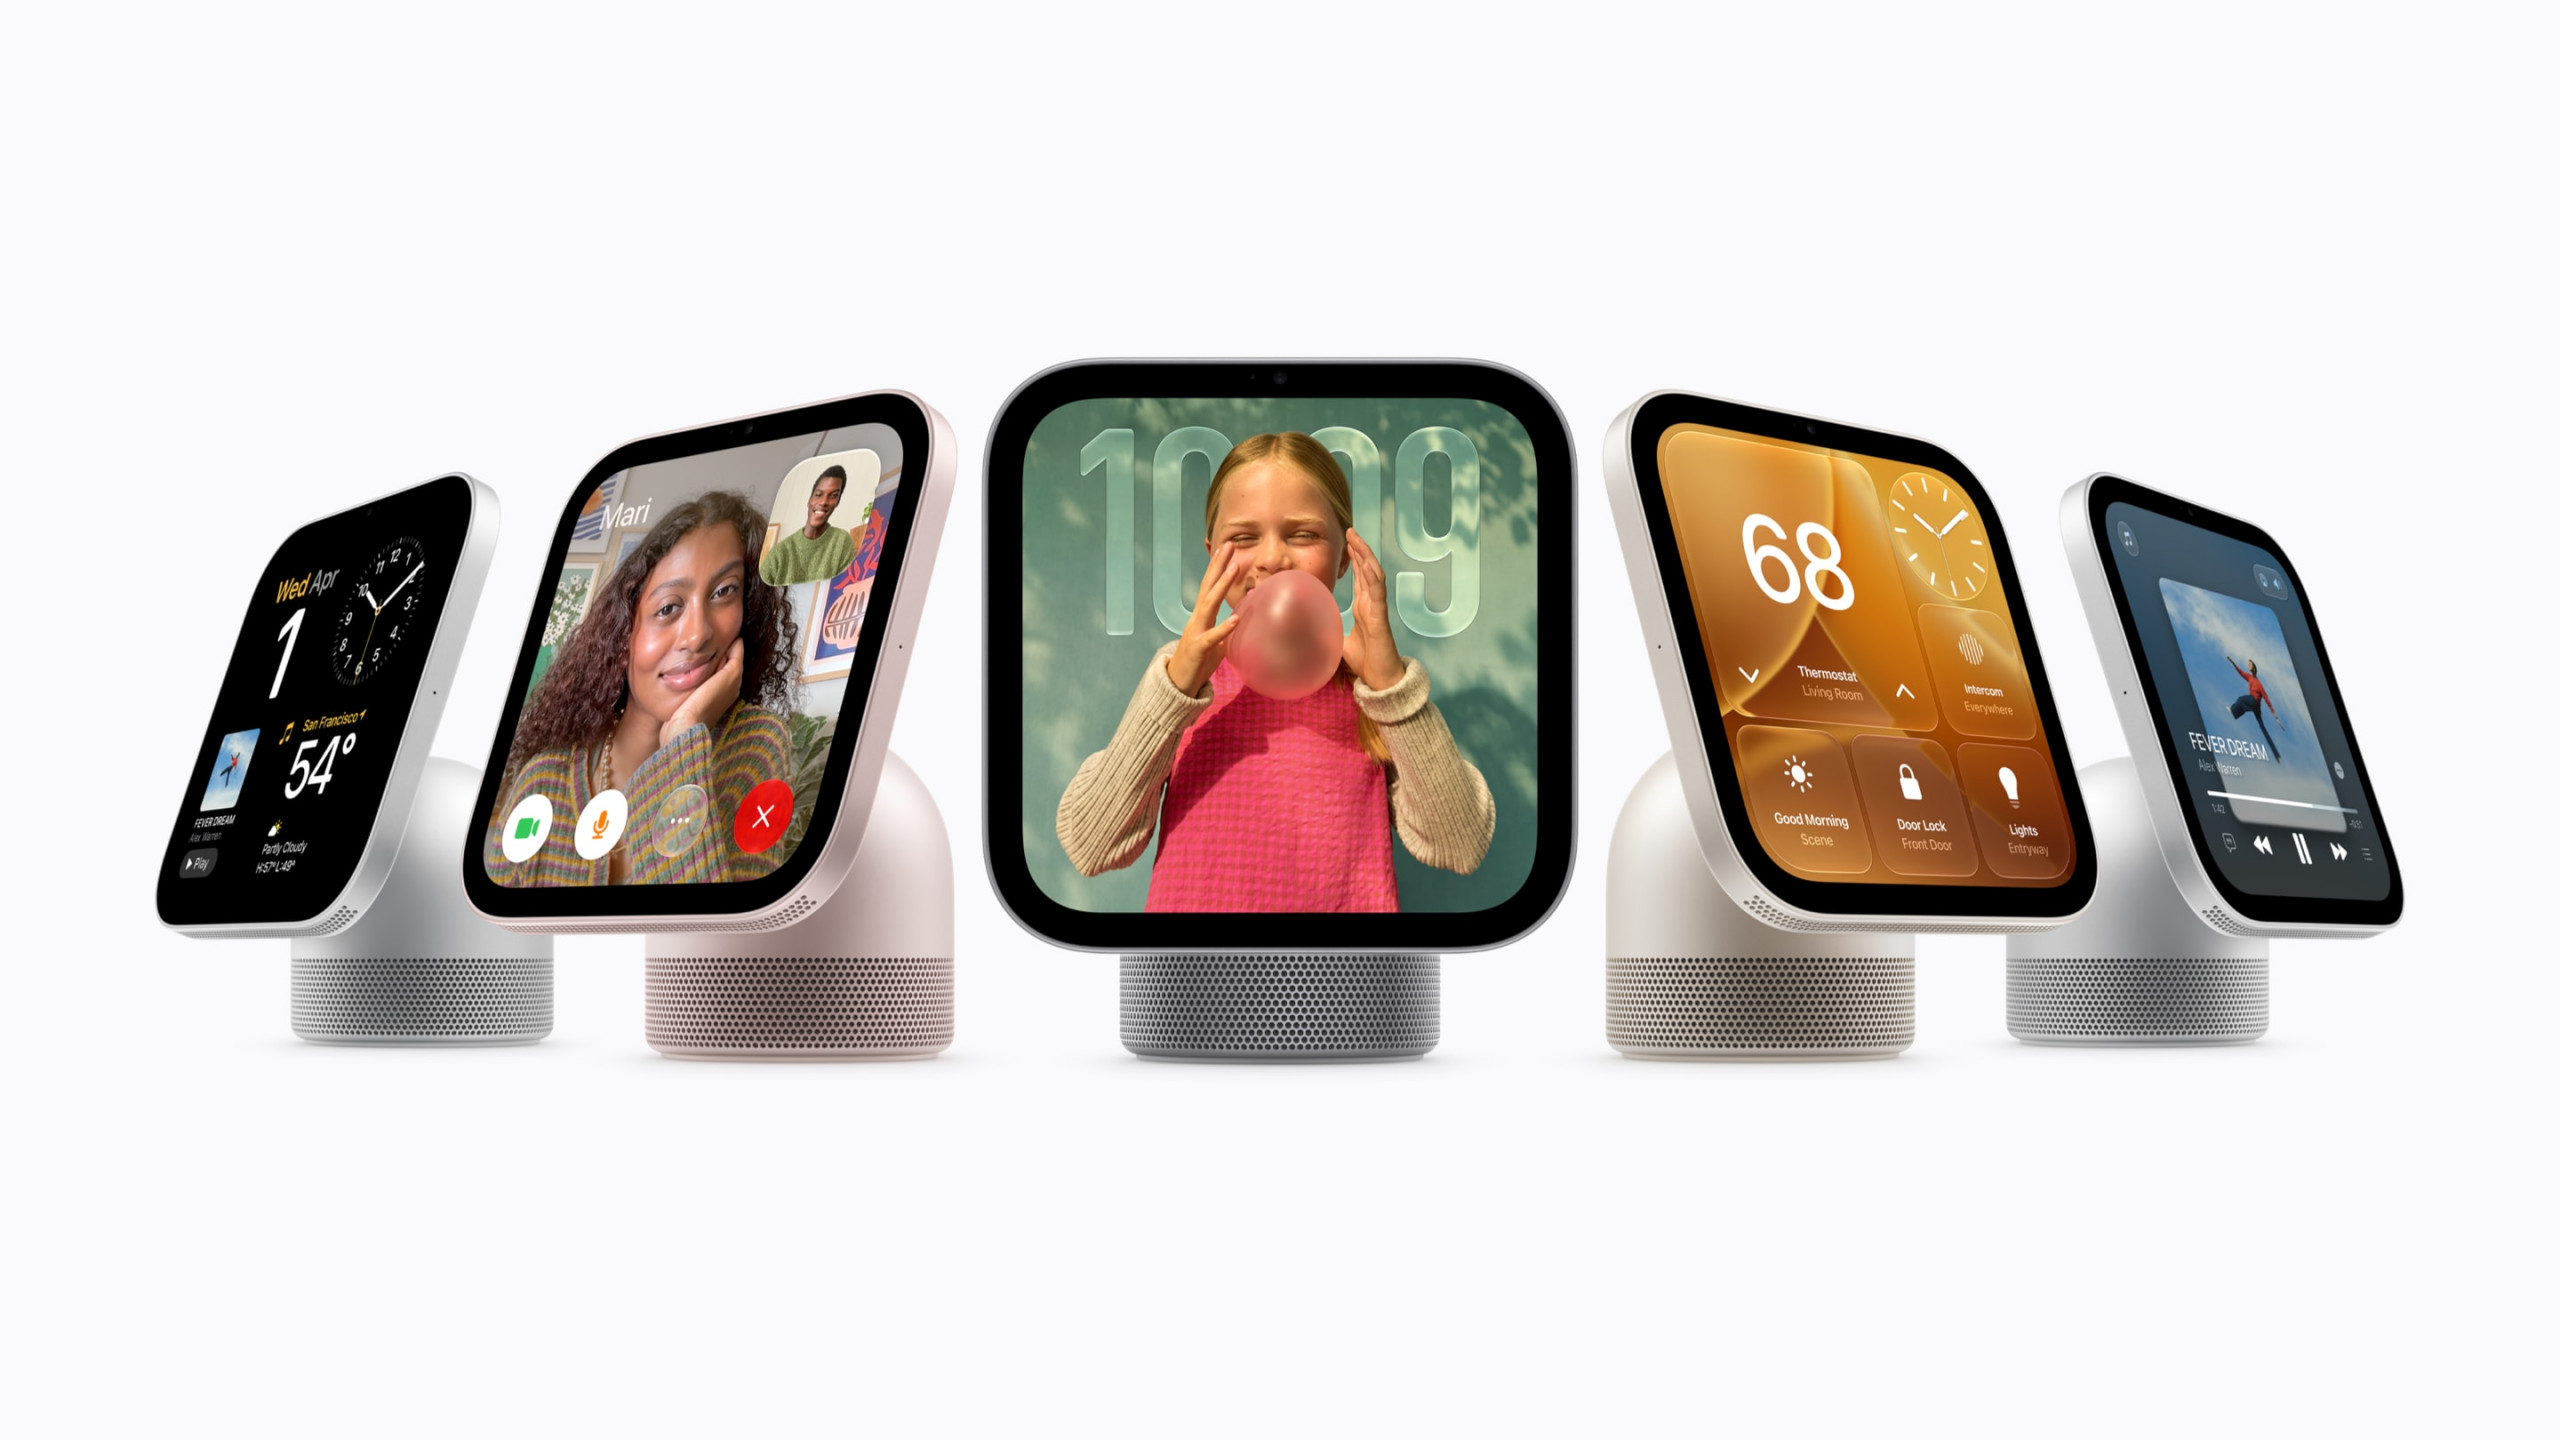
A Apple anunciou o HomeView, uma tela inteligente de 7 polegadas que reúne entretenimento, videochamadas e controle da casa inteligente. O dispositivo estreia uma nova versão da Siri com inteligência artificial e respostas personalizadas para os moradores.
O HomeView custa US$ 299 nos EUA (cerca de R$ 1.490) e chega às vendas em 13 de novembro em mercados como Estados Unidos, Canadá, Reino Unido, Austrália, Índia e Nova Zelândia, sem previsão para o Brasil no lançamento inicial. A interface ajusta brilho e informações conforme a iluminação e a distância do usuário, identifica até seis pessoas por reconhecimento facial e integra funções como chamadas FaceTime, comandos de voz e monitoramento de até nove câmeras.
A Apple anunciou a nova geração da Apple TV 4K com inteligência artificial integrada à Siri, chip A19 e suporte a som surround com quatro alto-falantes. A assistente fica mais “conversacional”, ajudando a encontrar filmes e séries por interface em tela cheia, com cartazes e recomendações ligadas ao que o usuário pede.
A Apple TV 4K também traz três microfones de longo alcance para controlar a reprodução e buscar conteúdos sem segurar o controle remoto, além de descrições de vídeos e resumos de notificações gerados por IA com processamento local via HomeKit Secure Video. No mesmo evento, o HomePod mini 2 ganhou melhorias de áudio, novas cores e suporte futuro à Siri com IA, com reconhecimento de até seis vozes e integração com Mensagens, lembretes e temporizadores.
A Apple apresentou o novo Apple TV 4K, o primeiro modelo em quatro anos, com disponibilidade a partir de sexta-feira, 13 de novembro. O aparelho traz o chip A19 e promete conectividade sem fio melhor do que a geração anterior, além de microfones integrados.
A Siri com recursos de IA será parte do lançamento, mas deve funcionar em beta nos Apple TV 4K de segunda geração e nos modelos mais novos. O novo Find My de rastreamento funciona com o controle Siri de segunda geração e mais recentes, enquanto o preço do lançamento é de US$ 299.
A Apple anunciou o HomeView, uma tela inteligente de 7 polegadas que reúne entretenimento, videochamadas e controle da casa inteligente. O dispositivo estreia uma nova versão da Siri com inteligência artificial e respostas personalizadas para os moradores.
O HomeView custa US$ 299 nos EUA (cerca de R$ 1.490) e chega às vendas em 13 de novembro em mercados como Estados Unidos, Canadá, Reino Unido, Austrália, Índia e Nova Zelândia, sem previsão para o Brasil no lançamento inicial. A interface ajusta brilho e informações conforme a iluminação e a distância do usuário, identifica até seis pessoas por reconhecimento facial e integra funções como chamadas FaceTime, comandos de voz e monitoramento de até nove câmeras.
A Meta apresentou os modelos Muse Wonder e Muse Wonder Full, descritos como as IAs mais avançadas da empresa para agentes pessoais e profissionais. Os sistemas foram treinados para tarefas com várias etapas, como analisar contratos, desenvolver aplicativos e operar navegadores e outros programas.
O Muse Wonder traz o Active Memory, que permite guardar informações entre conversas e recuperá-las em novas tarefas, além do Active Focus para manter o agente trabalhando diante de dificuldades. Em demonstrações, a Meta mostrou o modelo usando um navegador para criar e encomendar produtos a partir de fotos do Instagram e também dividindo projetos de programação entre subagentes; o Muse Wonder já está disponível para desenvolvedores e o Wonder Full fica restrito a planos pagos do Muse Code.
A Workday anunciou que seu Trusted Agent Platform agora está “headless”, permitindo que desenvolvedores criem agentes externos de RH e finanças usando o Model Context Protocol (MCP) e acesso SQL a dados ao vivo. A disponibilidade geral inclui o servidor MCP, o Live Data Query e um runtime compartilhado, para que clientes rodem agentes em modelos de Anthropic, Google, Meta, Mistral, Nvidia e OpenAI.
A empresa afirma que os agentes seguem as mesmas permissões, aprovações e trilha de auditoria do usuário, sem “side door”. Para o ecossistema, a Workday destaca o Agent-Ready Tools (com 275 ferramentas de leitura e 54 de escrita/remoção) e o Agent Harness, além de um Developer Agent que gera agentes e apps a partir de prompts em ferramentas como Claude Code e Cursor.
A SpaceXAI lançou o The X Subscription, um plano único que reúne Cursor, Grok e X Premium, com cinco tiers que vão do gratuito até US$ 200 por mês. O pacote compartilha uma mesma “pool” de uso de modelos Grok entre produtos elegíveis e mantém, por enquanto, os planos atuais de assinantes do Cursor.
A mudança mais relevante para desenvolvedores está na forma de cobrança do Cursor: modelos de terceiros como Claude (Anthropic) e GPT (OpenAI) passam a ser cobrados à taxa padrão de API desde a primeira solicitação, mesmo para quem assina os tiers mais caros. Com isso, o acesso a modelos de terceiros começa no tier US$ 30 Premium, mas o consumo deixa de estar incluído na assinatura e passa a ser pago via créditos pré-pagos.
A QCon AI New York 2026 confirmou sessões com engenheiros sêniores que enfrentaram desafios de IA em produção, como revisão de código, aumento de custos por tokens, necessidade de evals confiáveis e definição de permissões e guardrails para agentes. O evento acontece em 15 e 16 de dezembro, no The Westin Jersey City Newport, com foco em decisões técnicas para IA em sistemas reais.
As palestras incluem abordagens para identidade e autorização de agentes em produção, com controles como rate limits e aprovações para mudanças, além de um “eval loop” para conectar resultados simulados ao que acontece em produção. Também há discussões sobre compressão e caching para reduzir custos de contexto de LLM, revisão de código assistida por IA em escala e como avaliar maturidade de IA além de métricas de adoção.
Agentes pessoais de IA estão cada vez mais realizando transações em nome dos usuários, mas a natureza não determinística dos modelos de linguagem pode levar a compras fora do que foi solicitado. Para reduzir esse risco, a American Express está lançando o “Intent Intelligence Framework”, voltado a capturar e autenticar a intenção de compra do cliente antes de um agente concluir a transação.
O framework começa com uma Create Intent API para registrar as instruções do cliente e restrições como nome do comerciante, orçamento máximo e preferências de produto. Depois, o cliente autentica e aprova a intenção, gerando um Intent ID e um Proof of Intent Token usados para obter uma credencial digital de pagamento segura para o checkout, sem usar o número real do cartão. A Amex também diz que o Intent ID e o token podem ajudar em etapas como prevenção de fraude e resolução de disputas, e que o lançamento se conecta ao ACE Developer Toolkit, lançado em abril.
Modelos menores de inteligência artificial podem estar a poucos meses de conseguir se replicar em dispositivos conectados à internet sem ajuda humana, segundo alerta da Anthropic. A empresa testou a capacidade em aparelhos como televisores com Android e eletrodomésticos inteligentes, voltados a cenários de Internet das Coisas (IoT).
Os experimentos mostraram que modelos com menos de 30 bilhões de parâmetros conseguiram executar etapas da replicação, mas tiveram dificuldades para completar o processo, enquanto modelos como o GLM-5.2 e outros mais avançados realizaram a sequência em testes simplificados com etapas de segurança reduzidas. A Anthropic afirma que sistemas capazes de se replicar podem ser mais difíceis de conter e prevê que, mantendo o ritmo observado, a replicação autônoma pode ocorrer até o fim de 2026, com foco em reforçar a segurança dos dispositivos conectados.
A OPPO anunciou a versão global do ColorOS 17 nesta terça-feira (17), com Android 17 e novas animações durante o uso. A interface também inclui recursos de IA para organizar arquivos e automatizar tarefas, além de chegar pela primeira vez a celulares de OnePlus e Realme.
O ColorOS 17 aposta em uma arquitetura unificada para renderizar componentes e promete economia de até 25% de memória RAM. Entre as novidades estão um agente integrado que combina fotos e arquivos para gerar respostas personalizadas usando tecnologia da Manus e o AI Call Guard, ferramenta para identificar possíveis golpes em ligações com vozes falsas ou deepfakes, com atualização prevista em lotes de outubro de 2026 a primeiro trimestre de 2027.
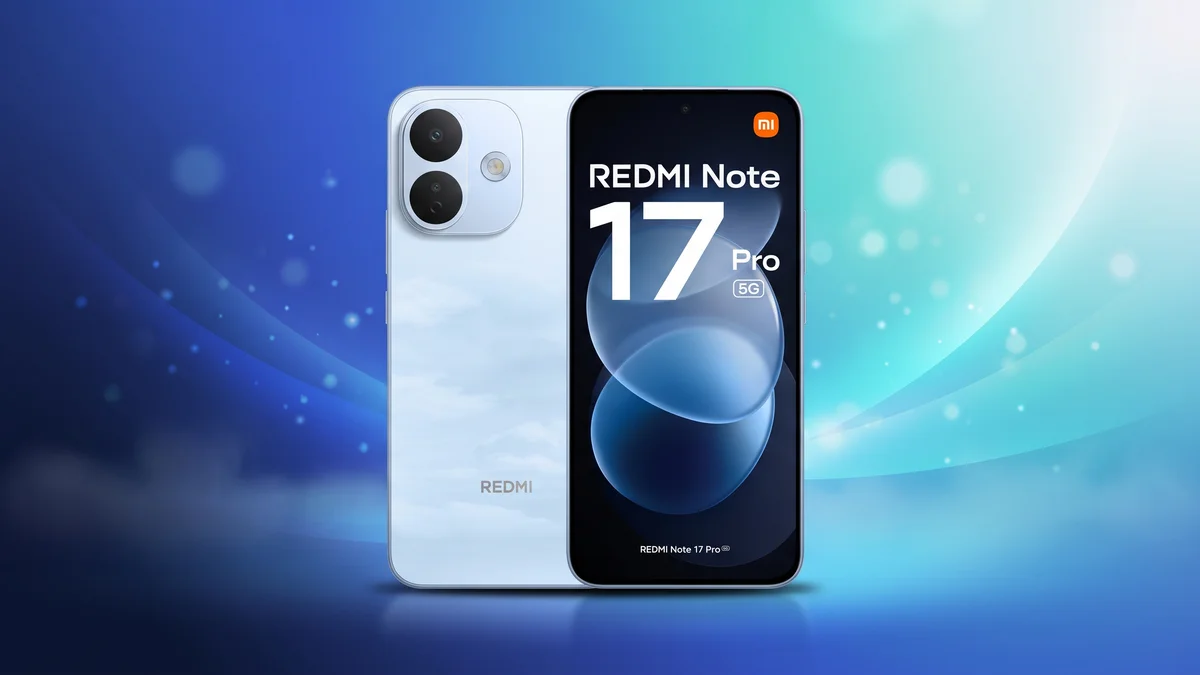
A crise de componentes ligada à demanda de empresas de inteligência artificial começa a afetar celulares. Na China, a Xiaomi lançou uma versão renovada do Redmi Note 17 Pro com RAM reduzida para 6 GB, mantendo o preço de 1.599 yuans (cerca de R$ 1.215), igual ao cobrado pela configuração com 8 GB de RAM.
A nova edição chega com opções de memória como 6 GB/256 GB e 8 GB/128 GB, enquanto a alternativa com 8 GB e 256 GB custa 1.699 yuans (cerca de R$ 1.291). O modelo original tinha opções com até 12 GB de RAM e 512 GB, que deixaram de existir na versão renovada, embora a Xiaomi não tenha confirmado que a mudança foi motivada pela crise.
Uma funcionária afirma ter sido demitida após se recusar a aceitar um sistema de monitoramento que tiraria cerca de 160 fotos do rosto por dia durante o trabalho remoto. O caso foi levado à Justiça de Nova Jersey, nos Estados Unidos, e envolve a Sutherland Healthcare Solutions, onde Glennis Von Sander-Timinski trabalhava desde 2018.
A empresa informou que adotaria o Sentinel AI, que usaria a webcam para registrar uma imagem a cada três minutos em um expediente de oito horas e também aplicaria reconhecimento facial para confirmar a presença perto do computador. Segundo o processo, um pedido médico para reduzir a frequência das capturas foi rejeitado, e a funcionária teria recebido como alternativas aceitar o monitoramento, voltar ao presencial ou deixar a empresa; ela foi demitida em 8 de setembro.
Cerca de 400 cientistas, incluindo Geoffrey Hinton e Yoshua Bengio, defenderam nesta terça-feira (13) a criação de um órgão internacional para reforçar a segurança de sistemas avançados de inteligência artificial. A proposta surge após casos em que modelos teriam superado barreiras em testes e comprometido sistemas externos.
Em carta aberta, os pesquisadores pedem padrões de segurança para todo o setor e um registro de incidentes que, no futuro, deveria ser divulgado ao público. Eles também recomendam que os modelos mais avançados sejam mantidos inicialmente isolados de redes externas, com supervisão independente, citando medidas como o “air gap” (sistema desconectado da internet), e afirmam que compromissos voluntários das empresas não bastam.
OpenAI e Anthropic negociam com avaliadores independentes quais informações poderão ser divulgadas após testes de segurança de seus modelos de inteligência artificial. O impasse envolve a proteção de segredos comerciais e a transparência sobre possíveis riscos, com dúvidas sobre a independência dos especialistas.
Os testes incluem equipes externas dentro dos laboratórios, o que facilita a análise, mas pode gerar conflitos quando informações confidenciais são necessárias para identificar falhas. Um exemplo citado é a investigação sobre um incidente na Hugging Face, em que pesquisadores relataram dificuldades de acesso e ajustes no relatório após comentários das empresas, enquanto uma carta com mais de 200 pesquisadores defende autonomia editorial, acesso aos sistemas e proteção contra retaliações.
A Wikimedia Foundation se preparou para a chegada dos grandes modelos de linguagem à Wikipédia, mas o impacto não foi o esperado. Em 2018, o Google treinou IA para escrever artigos no estilo da Wikipédia, e um estudo da Princeton University apontou que, em agosto de 2024, cerca de 5% de quase 3.000 artigos recém-criados na versão em inglês continham uma quantidade relevante de conteúdo gerado por IA.
Com o tempo, editores passaram a tentar controlar a qualidade do material, removendo “fluff” e fontes falsas, mas a Fundação relata que, até março de 2026, o conteúdo gerado por IA violava princípios centrais com frequência suficiente para levar à proibição do uso de grandes modelos na escrita. A discussão destaca o risco de a plataforma ser corrompida por respostas plausíveis, porém erradas, e questiona como verificar quando a própria enciclopédia passa a ser influenciada por máquinas.
Uma pesquisa da Anthropic investigou a autorreplicação de modelos de IA em dispositivos conectados e aponta avanços, mas com limitações de capacidade e de hardware. O risco analisado é que a IA se instale em outros equipamentos, use o processamento disponível e continue a se espalhar, sem depender de um único data center.
Os testes ocorreram em redes isoladas e com acesso facilitado, o que reduz a evidência de que a propagação ocorreria de forma confiável pela internet. Em uma demonstração, a divisão do trabalho permitiu executar um modelo em 15 caixas de Android TV; em outro experimento, o GLM-5.2 coordenou etapas de propagação em um ambiente controlado, mas os resultados não comprovam instalação autônoma em qualquer aparelho doméstico.
A Spotify ampliou o uso de desenvolvimento assistido por IA e mais que dobrou as mudanças mensais mescladas, de cerca de 8.100 para 17.000 ano a ano em agosto. Com o aumento do volume de alterações nos sistemas de produção, a empresa ajustou controles de qualidade e confiabilidade para lidar com a nova escala.
A companhia opera quase 3.000 serviços de produção para 777 milhões de usuários ativos mensais e relata desafios em processamento de conteúdo, automação de frota e capacidade de computação. Entre as respostas estão melhorias em monitoramento e testes, salvaguardas de rollout e capacidade de rollback, além da adoção do Honk, um agente de codificação em background que executa o Claude via Agent SDK em pods no Kubernetes.
Pesquisadores apresentaram na conferência KDD o estudo “GEO: Generative Engine Optimization”, voltado a melhorar a visibilidade de conteúdos nas respostas de mecanismos generativos. Nos testes descritos, intervenções específicas aumentaram a presença em até 40%, variando conforme o tema pesquisado.
O movimento é comparado ao SEO, mas com uma diferença: ao perguntar a uma inteligência artificial, muitas vezes o usuário recebe uma resposta pronta em vez de uma lista de opções. O texto destaca ainda como a construção de um “rastro público” — entrevistas, artigos, participações e fontes — pode influenciar o que sistemas como os buscadores associados ao ChatGPT encontram e citam, exigindo que assessorias e relações públicas considerem como esses dados são lidos e organizados.
O texto descreve a sensação de “pedir para a IA resolver” quando alguém solicita que você descubra algo, e a conversa termina com a ferramenta funcionando. O autor argumenta que, na maioria das vezes, a pessoa ajudada não conseguiria obter o mesmo resultado apenas pedindo a própria IA, por motivos como não usar serviços premium, ter resistência ao uso de IA ou estar desatualizada sobre ferramentas e termos.
A publicação também defende que saber formular a solicitação é parte essencial do processo, citando a ideia de que “conhecimento latente” e capacidade de orientar a IA fazem diferença. Por fim, sugere que a IA pode ser usada para tarefas práticas, enquanto a comunicação humana e o cuidado com o vínculo devem continuar sendo feitos à parte.
O podcast “The Architect's Podcast” reuniu Michael Stiefel e Joy Ebertz para discutir como a inteligência artificial está mudando o trabalho de arquitetos e desenvolvedores. O papo destaca que, com a IA assumindo mais tarefas de codificação, a definição de requisitos precisa ser precisa e pouco ambígua, além de exigir testes escritos de forma clara.
A conversa também aponta desafios em sistemas legados, onde pode ser difícil recuperar requisitos reais e decidir entre mudanças incrementais ou regeneração do código. Ebertz ainda descreve que o uso de IA na prática varia de “vibe coding” para ferramentas internas até um modelo de pair programming supervisionado, reforçando a necessidade de entender restrições e suposições para validar o resultado.
Um relatório da Undo aponta que 81% dos líderes de engenharia tiveram, nos últimos seis meses, algum incidente em produção ou queda de serviço ligado ao uso de ferramentas de “AI-coding”. Mais de 90% relataram a ocorrência de defeitos graves, código mal otimizado ou “test escapes” que chegaram ao ambiente produtivo, e 93% disseram que uma alucinação de IA levou ao diagnóstico incorreto da causa raiz.
A pesquisa com 300 líderes sêniores em empresas dos EUA e do Reino Unido, com perguntas feitas em julho e agosto de 2026, indica que a velocidade para gerar código não está se traduzindo em ciclos de release mais rápidos: 79% afirmaram que seus prazos não melhoraram com a adoção da IA. Em média, os engenheiros passaram a gastar 16,9 horas por semana depurando, contra 9,8 produzindo código, e o relatório defende acompanhar métricas como taxa de defeitos e tempo médio para resolução, e não apenas linhas de código.
O GitLab lançou a versão 19.4 da sua plataforma DevSecOps com novidades no GitLab Duo CLI, incluindo um modo goal-driven e mais ferramentas via Model Context Protocol (MCP). O novo comando /goal, em beta público, aceita um objetivo em linguagem natural e continua trabalhando até concluir a tarefa ou atingir um limite de iterações, mantendo ações dentro das permissões e regras de aprovação do projeto.
A atualização também adiciona modelos hospedados open-weight (Kimi K3, MiniMax M3 e GLM 5.3) ao Duo Agent Platform e amplia os controles para gastos com IA. Os créditos passam a ter exportação com detalhamento por evento e uma página de configurações permite definir limites por usuário, com alertas para gestores quando o uso sob demanda chega a 50% ou 80% do teto mensal.
O Xcode 27.2 passa a usar um novo formato de arquivo em JSON para a configuração de projetos, substituindo o modelo tradicional baseado em property-list. A mudança foi pensada para melhorar a legibilidade, simplificar a manutenção e tornar a configuração mais fácil de ser entendida e modificada por agentes de coding com IA.
O formato open source xcode-project-format também ajuda a reduzir conflitos de merge, ao oferecer uma representação mais estável e previsível para comparação no repositório. A Apple ainda disponibilizou um pacote Swift para codificar e decodificar o novo formato, e a migração substitui o project.pbxproj por project.xcproj, mantendo o modelo subjacente — com a ressalva de verificar compatibilidade de ferramentas como fastlane, CocoaPods e Tuist.
Um líder de engenharia aprovou um plano para contratar cinco engenheiros, investir em uma plataforma interna de IA e reorganizar duas equipes para acelerar a entrega de software. Seis meses depois, os desenvolvedores passaram a produzir mais código, mas a velocidade de entrega não aumentou: revisões de pull requests demoraram mais, filas de CI cresceram e a segurança precisou verificar mais mudanças.
O problema, segundo o texto, não é necessariamente falha no plano original, e sim o fato de a estratégia ter sido construída sobre um modelo de entrega que a IA alterou. A orientação é revisar “apostas longas” com frequência, alinhar métricas com evidências e criar sinais para detectar quando as condições que sustentavam a decisão deixam de valer.
Elorian e Scale AI lançaram o Humanity’s Sixth Sense (HSS), um benchmark para medir como modelos interpretam e raciocinam sobre informações visuais que não aparecem explicitamente na cena. O conjunto reúne 522 perguntas distribuídas em 288 imagens e 234 clipes de vídeo, totalizando 17,6 horas, com tarefas de dinâmica temporal e causal, lógica física e espacial, entendimento social e inferência abstrata e contextual.
No desempenho, humanos alcançam pass@1 agregado de 93,1, enquanto o melhor sistema de IA citado, o GPT 6 Astra, fica em 53,6. Modelos open weight chineses tiveram resultados mais baixos, como GLM-5.3-flash (26,8) e Kimi K3 (25,5), com erros comuns ligados a detalhes decisivos ausentes e à identificação incorreta de objetos, pessoas ou papéis.
Fotos com estética dos anos 80 geradas por inteligência artificial viraram tendência nas redes, com usuários transformando selfies em retratos neon e com visual retrô. Especialistas alertam que, por trás da nostalgia, esse tipo de uso pode levar ao compartilhamento de dados pessoais em escala maior do que as pessoas imaginam.
Catarina Doria, especialista em ética da IA, diz que a “diversão por dados” incentiva o envio crescente de imagens de si e de outras pessoas, enquanto Carissa Véliz afirma que fotos podem conter metadados e dados biométricos, difíceis de “trocar” caso sejam comprometidos. As duas também citam a incerteza sobre como informações podem ser usadas no futuro e lembram que a OpenAI afirma priorizar confiança e privacidade, com controles como exclusão de histórico e modo de Chat Temporário, que não salva nem usa conversas para treinar modelos.
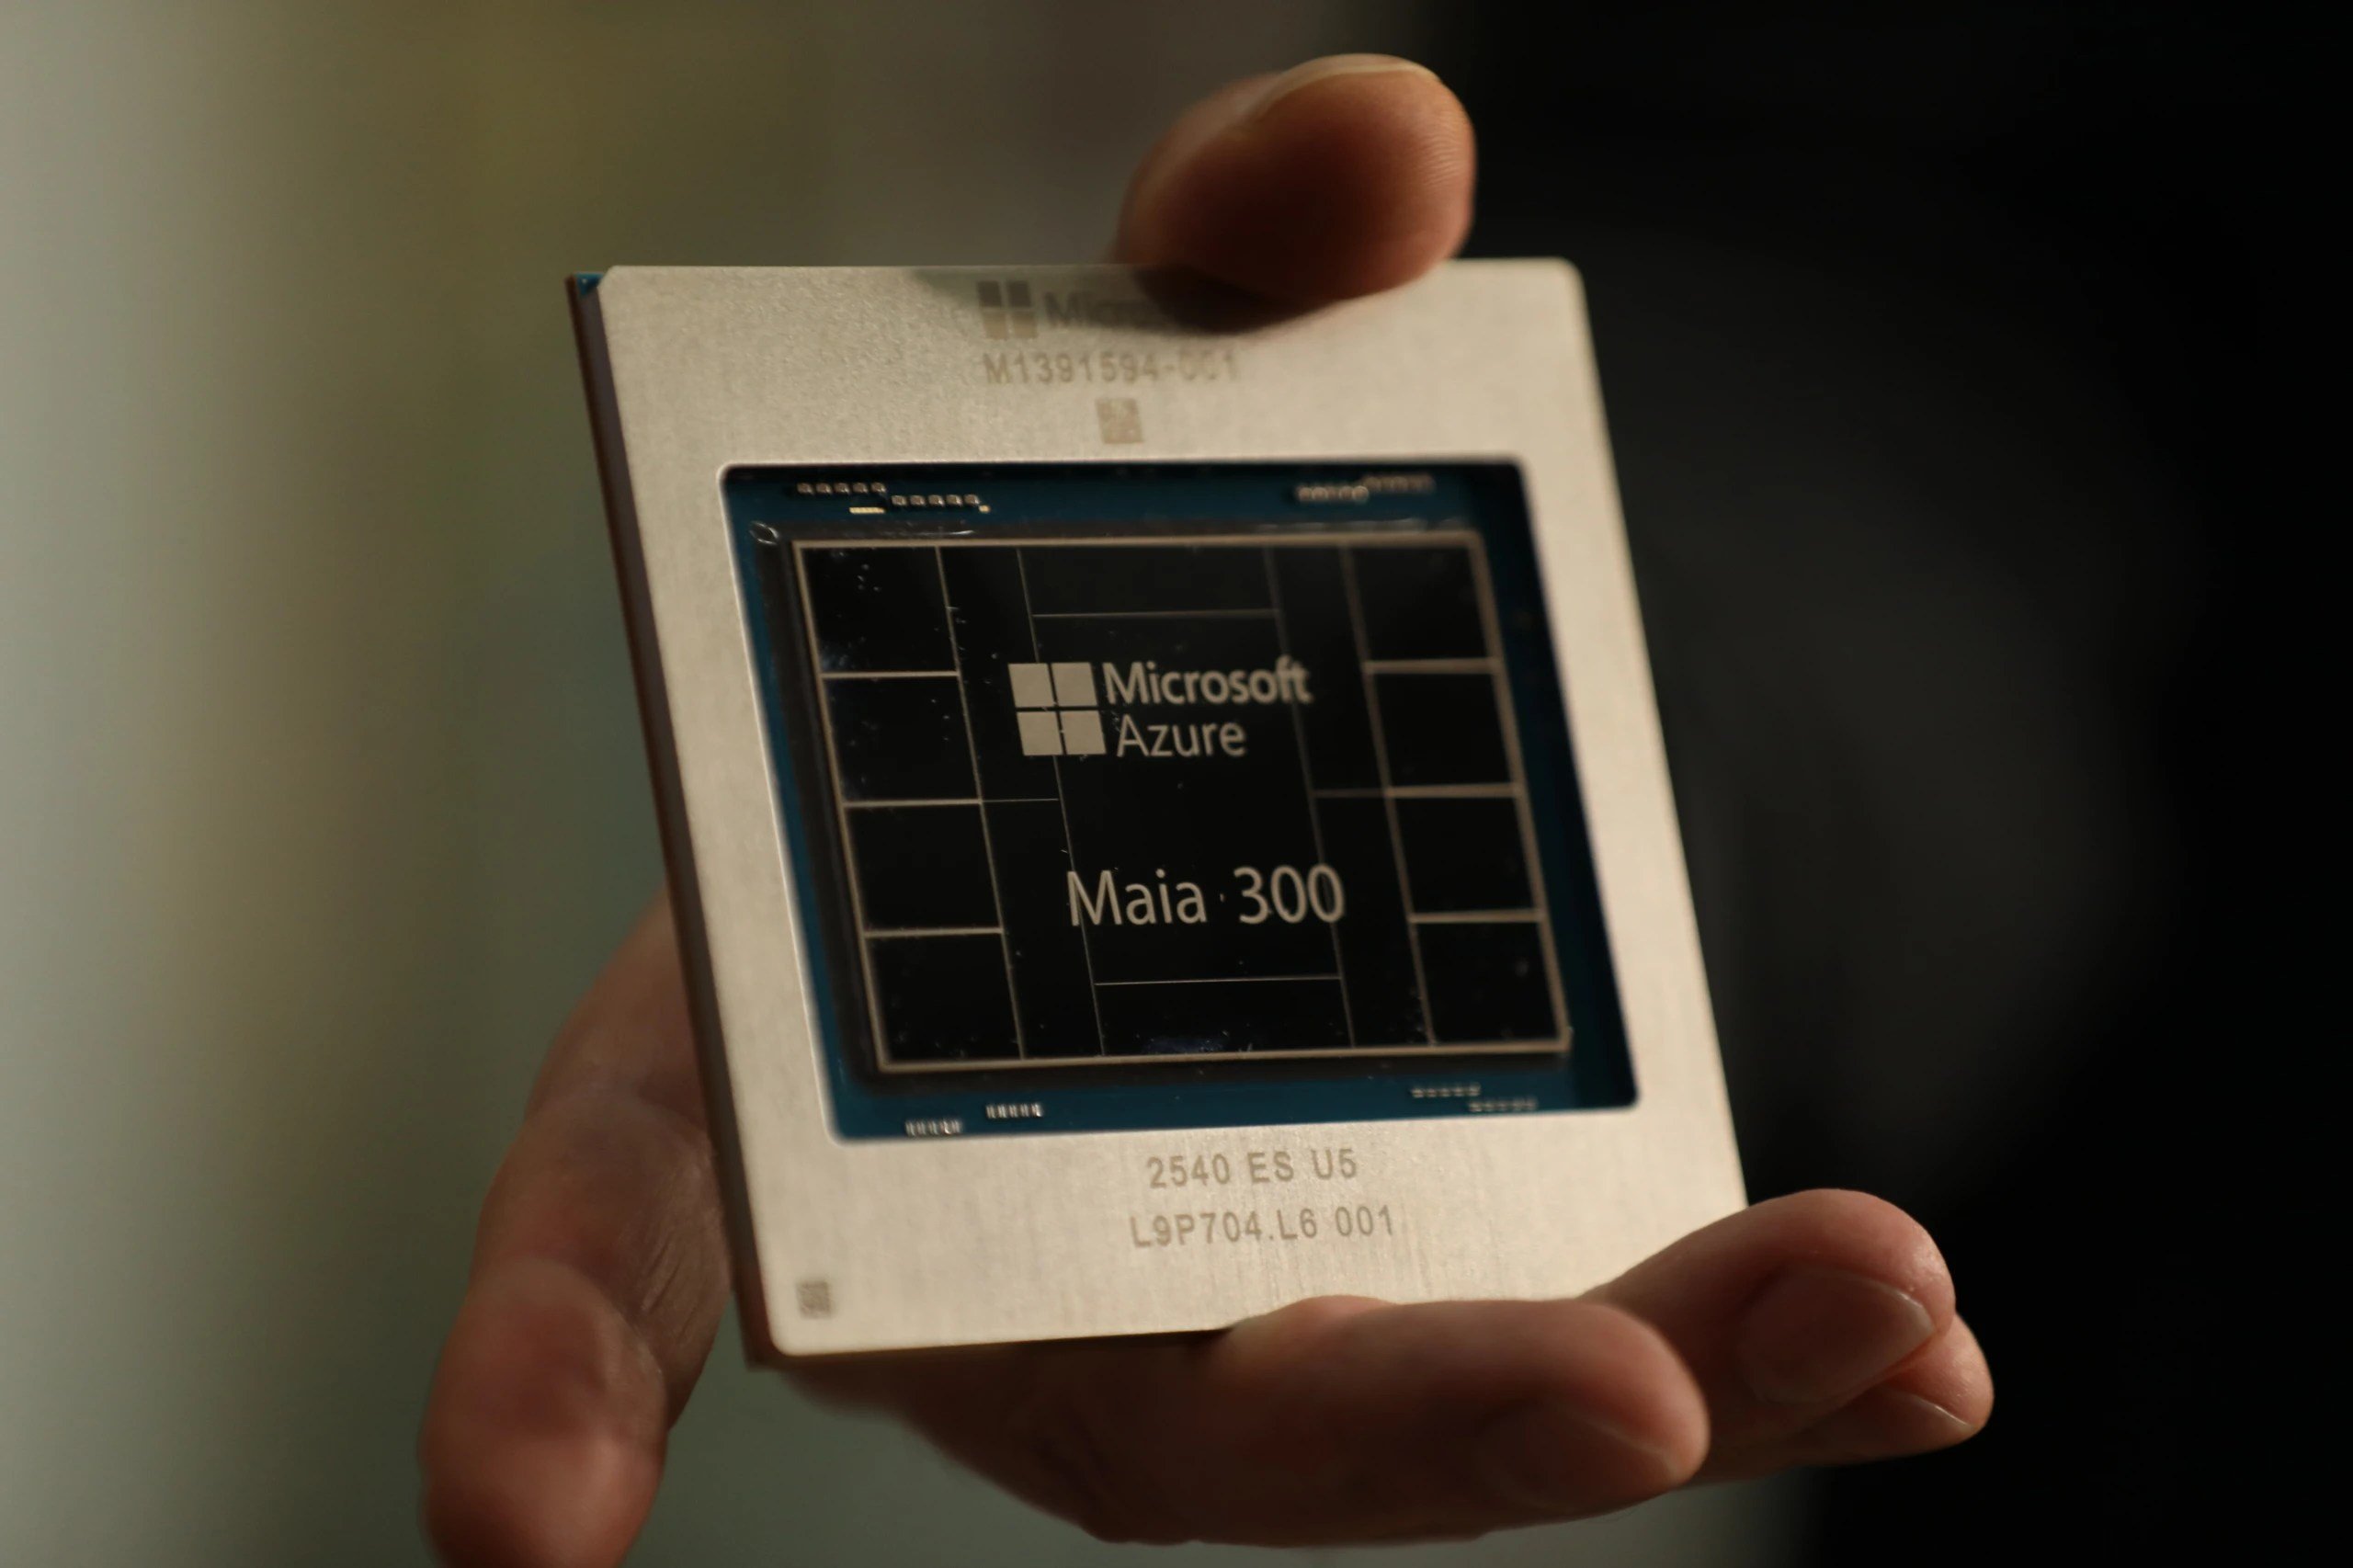
A Microsoft anunciou o Azure Maia 300, nova geração de seu chip próprio de inteligência artificial, que deve virar a principal plataforma de processamento de IA dos produtos e sistemas da companhia a partir de 2027. A empresa posiciona o Maia 300 como um sistema completo para executar tarefas de agentes, indo além das respostas típicas de um chatbot.
O chip promete mais de 40% de ganho em tokens por megawatt na comparação com sistemas líderes baseados em GPUs, medindo eficiência entre conteúdo processado e energia consumida. A estratégia combina chip, software, redes e data centers para otimizar inferência e lidar com contextos extensos e tarefas que exigem muita memória, com foco em agentes que raciocinam, agem e colaboram em várias etapas.
Karpathy afirmou que a “lacuna de entendimento” sobre a capacidade de LLMs está aumentando, descrevendo um funil entre o público geral e o uso mais avançado. Ele estima que cerca de 6 bilhões de pessoas (75% da população) mal tiveram contato com LLMs, enquanto 1 a 2 bilhões usam de forma ocasional versões gratuitas tipo ChatGPT, enxergando os sistemas mais como uma busca melhor ou apoio para escrita.
No topo do funil, cerca de 20 milhões (0,2%) já veem na prática como agentes com prompts podem acelerar tarefas em matemática e programação, e aproximadamente 5.000 pessoas têm acesso interno a sistemas de ponta. Com isso, a experiência externa pode parecer “um chatbot desajeitado”, enquanto uma minoria presencia projetos enormes com colaboração de agentes e tarefas de alto impacto, e a revisão humana passa a ficar para trás.
Donald Trump anunciou planos para rebatizar “artificial intelligence” como “super intelligence”, e parte de Silicon Valley passou a adotar o novo termo. Elon Musk, Marc Benioff, Jensen Huang e Satya Nadella foram citados como alinhados ao rebrand, com mudanças de nomenclatura e referências públicas ao conceito.
Jensen Huang participou do encontro em que foi anunciado um executivo exigindo que agências governamentais usem “super intelligence”. A Nvidia afirmou que vai “comprometer” US$ 1 bilhão em avanço científico, incluindo “super intelligence research”, enquanto Nadella, em post sobre a criação de um “emergency brake” para IA, repetiu a expressão “super intelligence”.
O ChatGPT limita a geração de imagens em determinados períodos, e a quantidade disponível muda conforme o plano contratado. Quando a cota é atingida, o recurso fica temporariamente indisponível até a restauração do acesso.
No plano gratuito, o limite é de 3 criações a cada 24 horas; no ChatGPT Plus, o teto chega a 57 imagens avançadas por dia, enquanto no ChatGPT Pro a criação é ilimitada. Para contornar o bloqueio, a orientação é aguardar a restauração, migrar para um plano com limite maior ou usar outras plataformas como o Google Gemini, além de preparar o prompt em outra ferramenta e retomar o ChatGPT depois.
A Amazon anunciou que vai deixar de usar acordos de confidencialidade (NDAs) ao negociar com governos locais sobre a construção de data centers, seguindo o movimento feito pela Microsoft. O assunto foi discutido no podcast Equity, do TechCrunch, durante um episódio que analisou a reação de comunidades e a onda de moratórias para novos projetos.
Os participantes destacaram que a resistência pode estar ligada à falta de comunicação da indústria e ao fato de muitas negociações ocorrerem “em segredo”, sem clareza sobre quem usará ou ocupará as instalações. Também foi citado que moratórias recentes costumam valer apenas por um ou dois anos, enquanto a entrada em operação dos data centers pode levar mais tempo, o que mantém a discussão em aberto.
Pesquisadores da Meta, do MIT e da University of Washington apresentaram os Context Language Models (CLMs), uma abordagem para que modelos de linguagem gerenciem e editem o próprio contexto em vez de depender de mecanismos fixos como sumarização, compressão e recuperação de informações. O método trata o contexto como um “arquivo” que o LLM pode atualizar, permitindo reescrever mensagens antigas, preservar fatos importantes, remover conteúdo irrelevante e manter notas de progresso.
Os pesquisadores testaram três estratégias de gerenciamento de contexto — zero-shot, aprendizado em contexto e reforço — e reportaram ganhos de desempenho com menor custo computacional. Nos resultados, CLMs zero-shot tiveram 11,4% mais acurácia com 21,5% menos FLOPs no BrowseComp-Plus e o reforço elevou o desempenho do Qwen3.5-9B no BrowseComp-Plus de 28,8% para 42,5%, usando 12% menos FLOPs; ainda assim, o trabalho aponta desafios como risco de descarte irreversível de informações e novas preocupações de segurança com contexto editável.