A Spotify ampliou o uso de desenvolvimento assistido por IA e mais que dobrou as mudanças mensais mescladas, de cerca de 8.100 para 17.000 ano a ano em agosto. Com o aumento do volume de alterações nos sistemas de produção, a empresa ajustou controles de qualidade e confiabilidade para lidar com a nova escala.
A companhia opera quase 3.000 serviços de produção para 777 milhões de usuários ativos mensais e relata desafios em processamento de conteúdo, automação de frota e capacidade de computação. Entre as respostas estão melhorias em monitoramento e testes, salvaguardas de rollout e capacidade de rollback, além da adoção do Honk, um agente de codificação em background que executa o Claude via Agent SDK em pods no Kubernetes.
Pesquisadores apresentaram na conferência KDD o estudo “GEO: Generative Engine Optimization”, voltado a melhorar a visibilidade de conteúdos nas respostas de mecanismos generativos. Nos testes descritos, intervenções específicas aumentaram a presença em até 40%, variando conforme o tema pesquisado.
O movimento é comparado ao SEO, mas com uma diferença: ao perguntar a uma inteligência artificial, muitas vezes o usuário recebe uma resposta pronta em vez de uma lista de opções. O texto destaca ainda como a construção de um “rastro público” — entrevistas, artigos, participações e fontes — pode influenciar o que sistemas como os buscadores associados ao ChatGPT encontram e citam, exigindo que assessorias e relações públicas considerem como esses dados são lidos e organizados.
A Starlink já permite que celulares se conectem diretamente aos satélites por meio da tecnologia Direct to Cell, sem a antena usada no serviço residencial. A proposta evoluiu de mensagens de texto para acesso a dados e chamadas via aplicativos, com operação feita em parceria com operadoras de telefonia que disponibilizam parte das frequências.
No Brasil, Vivo e Starlink participam de um ambiente experimental autorizado pela Anatel, com permissão válida até abril de 2029, mas ainda sem oferta comercial ampla. Enquanto isso, a SpaceX recebeu autorização da FCC para implantar até 15 mil satélites de nova geração, com novas frequências para ampliar cobertura e capacidade, inclusive em ambientes internos, aproximando a tecnologia de serviços móveis mais avançados.
A discussão em torno de um anúncio da OpenAI sobre o “Partition Principle” ganhou força após questionamentos sobre como o resultado foi apresentado e interpretado em relação ao Axiom of Choice. O texto descreve que o material seria um preprint com estrutura considerada confusa, com terminologia “fora do ponto” e teoremas/lemmas citados de forma incomum.
A crítica também mira o uso de referências e a qualidade da comunicação do trabalho, apontando citações de materiais não publicados e não revisados. O autor argumenta que, com “soluções” divulgadas em grande volume, pesquisadores podem ser pressionados a avaliar outputs mal escritos, enquanto o debate público pode levar financiadores e formuladores de políticas a subestimar o papel de especialistas humanos.
A OpenAI vai começar a aplicar automaticamente watermark em textos gerados pelo ChatGPT na União Europeia. A empresa também vai disponibilizar o recurso em outras regiões, mas ele ficará desativado por padrão fora da UE.
A mudança na Europa busca atender às exigências do EU AI Act, que passou a valer em agosto e determina a marcação de conteúdos produzidos por modelos de IA de forma detectável por outra ferramenta. A OpenAI afirma usar um método proprietário chamado textGrain e diz que deve liberar o detector para um número limitado de pesquisadores e organizações, com um processo de solicitação para ampliar o acesso ao longo do tempo.
Um acelerador de IA open-source chamado openTPU foi apresentado como um projeto que usa “auto-arch-tournament” para testar até onde agentes de IA conseguem ir no design de hardware e se podem construir o chip que executa a própria inferência. O projeto reúne, em um monorepo, desde o hardware em SystemVerilog até a linguagem de kernel, o compilador e o software host que controla uma placa real via PCIe.
O openTPU roda dez modelos com pesos reais em uma placa Inspur YPCB-00338 (Xilinx Kintex-7 xc7k480t, com dois canais DDR3) e afirma produzir os mesmos tokens do simulador, bit a bit. Medidas em diferentes datas de 2026-09-29 a 2026-10-01 indicam ganhos de desempenho em “decode” e “prefill”, além de rotas para lidar com modelos maiores via streaming de especialistas pela memória do host.
O Google prepara para 1º de outubro o lançamento do satélite experimental MVP, parte do Project Suncatcher, para processar consultas simples do Gemini em órbita. A iniciativa busca testar a viabilidade de data centers formados por frotas de satélites alimentados por energia solar, conectados para dividir cargas de processamento de IA.
O MVP levará quatro TPUs, com capacidade equivalente à de um servidor convencional, e painéis solares de cerca de 1 kW para executar consultas curtas e avaliar o comportamento do hardware no ambiente espacial. O projeto também enfrenta desafios como resfriamento no vácuo e efeitos da radiação, além de custos e dificuldades de manutenção e comunicação entre satélites.
O Google DeepMind está perto de lançar o aguardado modelo Gemini 4, segundo o novo chefe da divisão, Koray Kavukcuoglu. Ele afirmou que o modelo está na fase de refinamento e que a empresa pretende disponibilizar um “early post-training output” o quanto antes, com iterações rápidas em seguida.
A previsão é que o Gemini 4 chegue bem antes do fim de 2026. Kavukcuoglu também citou mudanças internas na liderança do DeepMind e o fato de a Google não lançar um novo modelo “flagship” desde a série Gemini 3, em novembro de 2025, enquanto concorrentes como OpenAI e Anthropic avançaram com novas gerações.
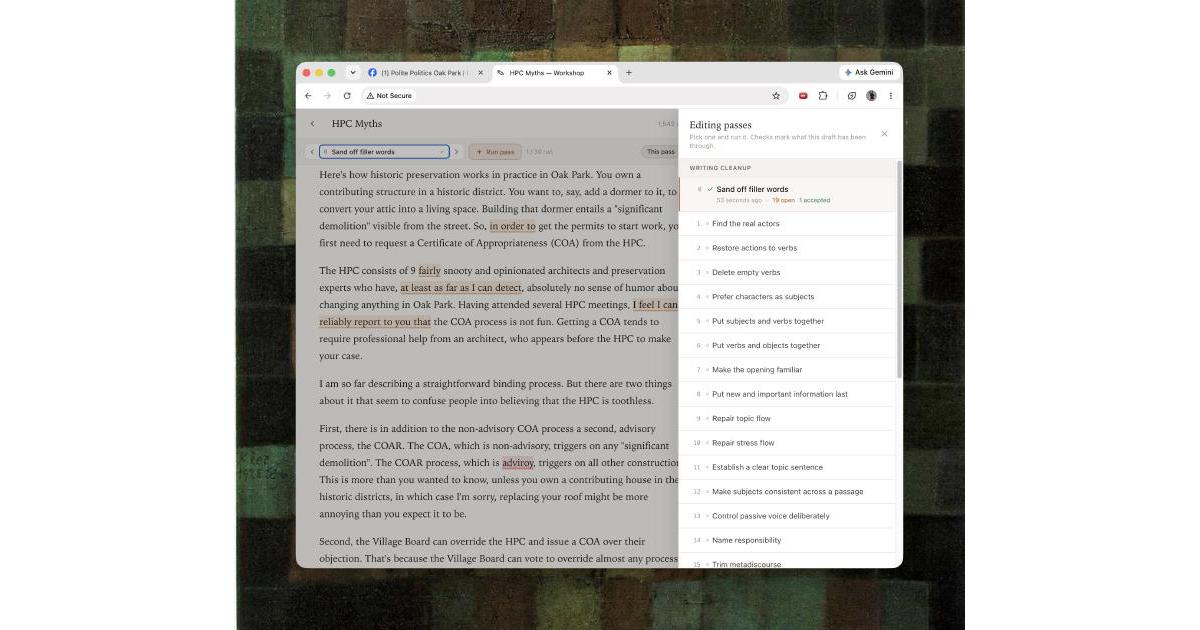
Um guia propõe duas regras para usar modelos de linguagem (LLMs) como revisores de texto, sem “pasteurizar” a escrita. A recomendação é escrever primeiro por conta própria e, depois, pedir a um modelo para identificar falhas. O texto alerta que leitores tendem a perceber quando o resultado parece “output” de IA, mesmo após tentativas de humanização.
As regras centrais dizem para não usar nenhuma palavra ou expressão que o LLM sugira e para evitar qualquer tipo de incentivo do modelo. Em vez de aceitar elogios sobre estrutura e escolhas, o guia orienta a tratar o modelo como ferramenta para apontar problemas — como excesso de voz passiva, repetições e palavras de reforço — e aplicar correções em passes, com reescritas e comparação cuidadosa.
A Cohere anunciou o North Small Translate, um modelo de tradução automática de código aberto com arquitetura mixture-of-experts (MOE) que opera em 50 idiomas. Os desenvolvedores podem baixar os pesos para uso não comercial sob a licença CC BY-NC 4.0 e, para implantação comercial, a empresa oferece o Model Vault, um ambiente de inferência gerenciado pela Cohere.
A companhia afirma que o modelo é “non-reasoning”, usando padrões aprendidos sem lógica passo a passo, o que reduz o uso de tokens. Em testes com o WMT26, a Cohere cita pontuação 83,60 no benchmark All Languages e destaca recursos para fluxos corporativos, como traduções estruturadas (Markdown ou JSON), instruções de tom e formato e guias de terminologia, além de um workflow multi-pass com revisão e correção do próprio output.
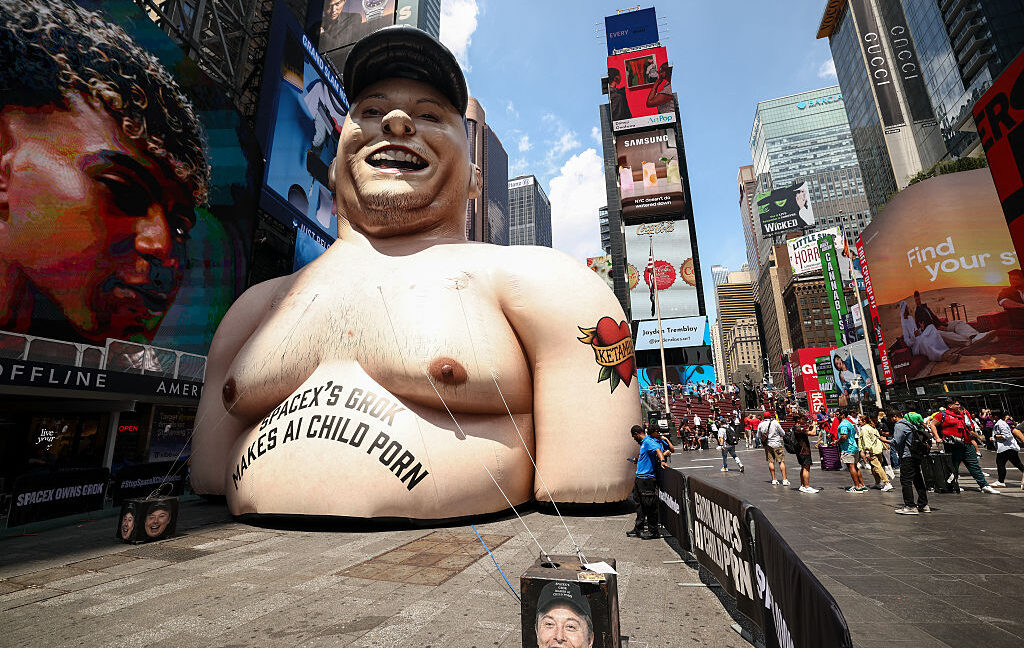
Uma ação judicial acusa a xAI de treinar o modelo Grok com materiais de abuso sexual infantil (CSAM). A denúncia afirma que a autora, identificada como Jane Doe, foi vítima de abuso no início dos anos 2000 e que suas imagens foram posteriormente “hashadas” por organizações como o NCMEC e o CCCP.
Doe relata que recebeu alertas do sistema de notificação do Departamento de Justiça dos EUA e que, em um desses avisos, o CCCP teria identificado CSAM gerado por IA no xAI que a retratava. A queixa também sustenta que a empresa teria armazenado as imagens produzidas pelo Grok e usado esses outputs para treinar ainda mais o modelo, além de mencionar mensagens em fóruns de discussão entre criminosos sobre a criação de CSAM gerado por IA.
A conversa sobre infraestrutura de IA tem focado GPUs e TPUs, mas a The New Stack destaca o papel crescente das CPUs com a mudança de chatbots para agentes. Mo Farhat, da Google Compute Engine, compara a função do processador a um “controlador de tráfego aéreo” para orquestrar fluxos de trabalho de agentes, incluindo preparação de dados, busca semântica e execução de lógica de controle. Ele também cita que modelos de 6 a 8 bilhões de parâmetros podem alcançar cerca de 25 tokens por segundo em cargas especializadas, o que pode ser suficiente para alguns cenários de agentes.
Para rodar código com segurança, os agentes precisam de sandboxes e isolamento, e a Google aponta o gVisor como camada de isolamento entre aplicação e sistema operacional. No GKE Agent Sandbox, a empresa afirma que é possível criar 300 sandboxes por segundo por cluster, usando pod snapshots e warm pools para escalar sem manter todos os ambientes totalmente provisionados. A discussão inclui ainda as máquinas Axion, com promessa de até 2x de preço-desempenho e mais de 60% de eficiência energética, além de opções C4A e N4A para diferentes perfis de execução e custo.
A DeepMind anunciou que o modelo WeatherNext, baseado em Functional Generative Networks (FGNs), conseguiu um avanço na previsão de ciclones ao gerar previsões com até 15 dias de antecedência em menos de um minuto em uma TPU. O sistema foi escalado de 50 previsões por rodada para um ensemble com 1.000 membros, melhorando a captura de cenários raros, como intensificação rápida observada no furacão Melissa (2025). Além disso, o modelo trabalha com dados bem menos detalhados (28x28 km), enquanto uma versão menor (WeatherNext 2-mini) usa 111x111 km.
A novidade importa porque reduz a dependência de alta resolução para estimar intensidade e riscos extremos, acelerando a avaliação de probabilidades por meteorologistas. Ao abrir código e pesos e disponibilizar versões como o 2-mini em notebook público, a DeepMind pretende impulsionar pesquisas e operações em agências e projetos que precisam de previsões mais rápidas para proteger vidas e infraestrutura.