A Spotify ampliou o uso de desenvolvimento assistido por IA e mais que dobrou as mudanças mensais mescladas, de cerca de 8.100 para 17.000 ano a ano em agosto. Com o aumento do volume de alterações nos sistemas de produção, a empresa ajustou controles de qualidade e confiabilidade para lidar com a nova escala.
A companhia opera quase 3.000 serviços de produção para 777 milhões de usuários ativos mensais e relata desafios em processamento de conteúdo, automação de frota e capacidade de computação. Entre as respostas estão melhorias em monitoramento e testes, salvaguardas de rollout e capacidade de rollback, além da adoção do Honk, um agente de codificação em background que executa o Claude via Agent SDK em pods no Kubernetes.
Pesquisadores apresentaram na conferência KDD o estudo “GEO: Generative Engine Optimization”, voltado a melhorar a visibilidade de conteúdos nas respostas de mecanismos generativos. Nos testes descritos, intervenções específicas aumentaram a presença em até 40%, variando conforme o tema pesquisado.
O movimento é comparado ao SEO, mas com uma diferença: ao perguntar a uma inteligência artificial, muitas vezes o usuário recebe uma resposta pronta em vez de uma lista de opções. O texto destaca ainda como a construção de um “rastro público” — entrevistas, artigos, participações e fontes — pode influenciar o que sistemas como os buscadores associados ao ChatGPT encontram e citam, exigindo que assessorias e relações públicas considerem como esses dados são lidos e organizados.
A Starlink já permite que celulares se conectem diretamente aos satélites por meio da tecnologia Direct to Cell, sem a antena usada no serviço residencial. A proposta evoluiu de mensagens de texto para acesso a dados e chamadas via aplicativos, com operação feita em parceria com operadoras de telefonia que disponibilizam parte das frequências.
No Brasil, Vivo e Starlink participam de um ambiente experimental autorizado pela Anatel, com permissão válida até abril de 2029, mas ainda sem oferta comercial ampla. Enquanto isso, a SpaceX recebeu autorização da FCC para implantar até 15 mil satélites de nova geração, com novas frequências para ampliar cobertura e capacidade, inclusive em ambientes internos, aproximando a tecnologia de serviços móveis mais avançados.
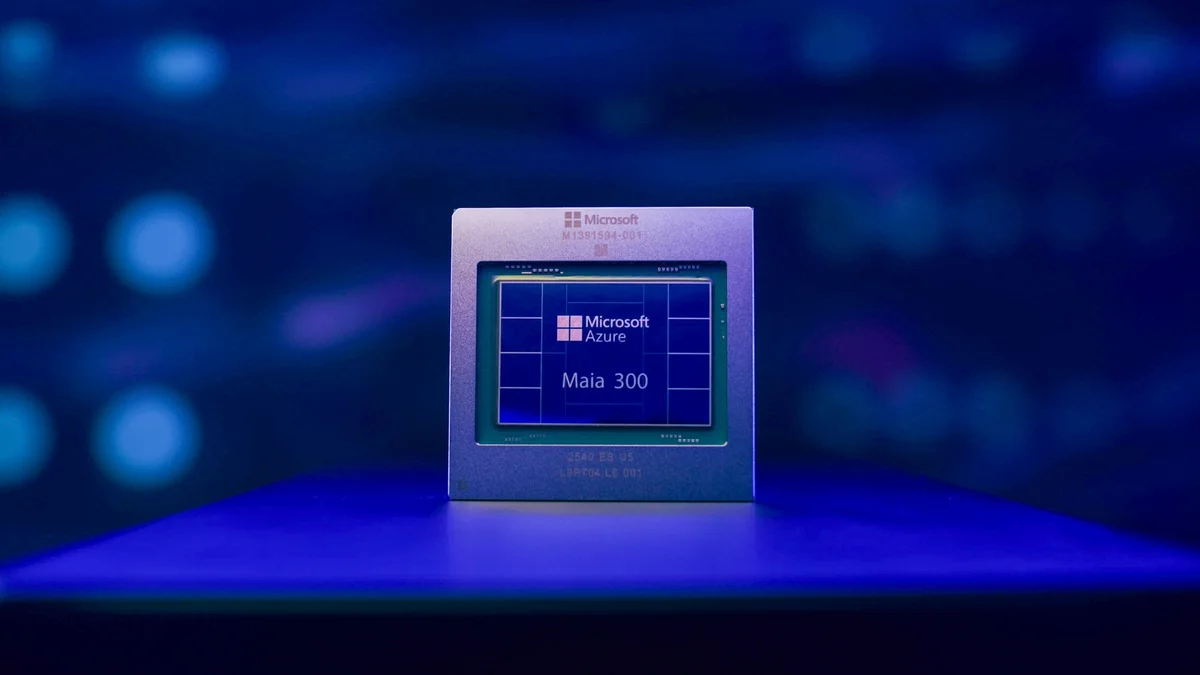
A Microsoft anunciou a terceira geração do chip de IA Maia, o Maia 300, com foco em atuar como “principal sistema de inferência” para produtos e serviços da empresa. O chip foi projetado para melhorar custo e eficiência na nuvem e para lidar melhor com modelos de raciocínio e tarefas agentic (orientadas por objetivos).
O Maia 300 começa a ser distribuído para cargas de trabalho de produção em 2027. A Microsoft espera entregar 40% mais tokens por megawatt do que sistemas líderes baseados em GPUs e, em uma configuração com 96 aceleradores, até 7x mais throughput em nível de rack do que o Maia 200, que já roda em produção em serviços como Microsoft Copilot e GitHub Copilot.
A Microsoft revelou o Maia 300, novo chip de IA para servidores, com foco em aumentar a eficiência energética no processamento de inferência. O componente promete processar 40% mais tokens por megawatt do que infraestruturas baseadas em GPUs, permitindo atender mais demandas de IA com a mesma capacidade elétrica.
O Maia 300 dá sequência ao Maia 200 e é voltado para conversas extensas, tarefas que exigem raciocínio e agentes capazes de executar várias ações em sequência. A arquitetura usa chiplets fabricados no processo N2P da TSMC, organiza componentes para manter dados próximos do uso e traz 288 GB de memória HBM4 por acelerador, além de uma configuração completa com 96 aceleradores e promessa de até sete vezes mais tokens que um rack Maia 200; a implantação está prevista para começar em 2027.
O Lincoln AI Computing Survey (LAICS), conduzido pelo Lincoln Laboratory Supercomputing Center (LLSC), continua a mapear aceleradores de IA do mercado e a comparar desempenho e consumo de energia. Desde 2018, a equipe publicou seis artigos e, no levantamento mais recente, analisou mais de 120 aceleradores, usando dados públicos e métricas como pico de performance e pico de potência.
Além de GPUs, a pesquisa inclui diferentes formatos de aceleradores, como CPUs, ASICs e FPGAs, destacando que cada tipo tem capacidades e níveis de eficiência distintos. O LAICS também investiga fatores que elevam desempenho, como transistores menores e uso de menor precisão numérica, e avalia escolhas arquiteturais que podem alterar o comportamento do sistema, com a intenção de seguir atualizando o panorama com novos lançamentos.
O Alibaba apresentou oficialmente o Zhenwu V900, um novo acelerador voltado para treinamento e inferência de modelos de inteligência artificial. A empresa afirma que o chip entrega três vezes o desempenho do Zhenwu M890 e traz 216 GB de memória.
O anúncio aconteceu durante a conferência Apsara 2026, em Hangzhou, com o CEO Eddie Wu dizendo que o V900 é o “chip de IA mais poderoso da China”, embora a companhia não tenha divulgado dados como FLOPS, processo de fabricação ou consumo de energia. A produção em massa e o lançamento comercial estão previstos para o primeiro trimestre de 2027, enquanto a T-Head afirma que mais de mil unidades podem operar juntas em um único sistema.
A Arm oficializou o lançamento da CSS for Mobile 2, uma nova arquitetura para smartphones voltada a tarefas complexas de inteligência artificial executadas localmente. A plataforma foi desenhada para lidar com cenários que envolvem agentes e gráficos mais detalhados, com foco em manter o mesmo desempenho consumindo menos energia.
O destaque fica na GPU Mali G2-Ultra NX, que integra aceleradores neurais dedicados e promete 14% mais desempenho em renderização tradicional, além de ray tracing de última geração. No processamento, a CPU combina núcleos C2-Ultra e C2-Pro e afirma entregar até 70% mais rapidez no processamento de LLMs, com suporte nativo a pacotes como Arm KleidiAI e Neural Graphics Development Kit.
A Arm apresentou a GPU Mali G2-Ultra NX, descrita como a primeira “AI-native” da linha Mali, voltada a levar gráficos de nível desktop para jogos em dispositivos móveis. O chip integra aceleradores neurais ao pipeline de gráficos e inclui uma nova execução, além de uma unidade de ray tracing de terceira geração.
A proposta é usar “neural graphics” para reconstruir detalhes, gerar frames intermediários e refinar imagens com menor demanda de GPU. Entre as técnicas citadas estão Neural Super Sampling (NSS), Neural Frame Rate Upscaling (NFRU) e Neural Super Sampling and Denoising (NSSD), com demonstrações que indicam ganhos como até 4x mais eficiência e até 70% menos tráfego de memória externa em relação ao rendering nativo.