Modelos menores de inteligência artificial podem estar a poucos meses de conseguir se replicar em dispositivos conectados à internet sem ajuda humana, segundo alerta da Anthropic. A empresa testou essa capacidade em aparelhos como televisores com Android e eletrodomésticos inteligentes.
O avanço chama atenção para os riscos de disseminação automática de IA em ambientes do dia a dia, fora do controle direto de usuários. Com a replicação em dispositivos domésticos, cresce a necessidade de avaliar segurança e limites para esse tipo de tecnologia em produtos conectados.
A Meta anunciou a série de modelos de inteligência artificial Muse Wonder, com versões Muse Wonder e Muse Wonder Full, voltadas a executar tarefas complexas com mais autonomia. Os agentes contam com memória entre conversas e conseguem manter um objetivo mesmo diante de erros, com aplicações que vão de organização de finanças pessoais à análise de contratos e ao desenvolvimento de softwares.
O Muse Wonder já está disponível para desenvolvedores e criadores via Meta Model API e Muse Code, enquanto o Muse Wonder Full é exclusivo para assinantes do Muse Code. A Meta diz que os modelos usam Active Memory para recuperar informações relevantes de interações anteriores e Active Focus para perseguir objetivos, testar abordagens, corrigir erros e solicitar confirmação do usuário antes de ações importantes, além de reforçar segurança e proteção de dados.
Um engenheiro da OpenAI é acusado de esconder um dispositivo de gravação de áudio em um pedaço de papel higiênico e instalá-lo atrás de um monitor em uma sala de reuniões executivas em um escritório em São Francisco. Segundo uma queixa criminal tornada pública, Abdulrahman Alfozan teria passado semanas consultando um “productivity agent” e um chatbot de IA para planejar a operação, incluindo o uso de uma ferramenta interna para checar reuniões no local.
A acusação também afirma que ele teria usado uma conta de chatbot ligada à esposa para tirar dúvidas técnicas sobre a instalação do equipamento. Após uma varredura de contravigilância em 30 de setembro, a equipe de segurança da OpenAI encontrou o dispositivo e acionou o FBI, além de desativar gradualmente o acesso de Alfozan aos sistemas da empresa durante a investigação.
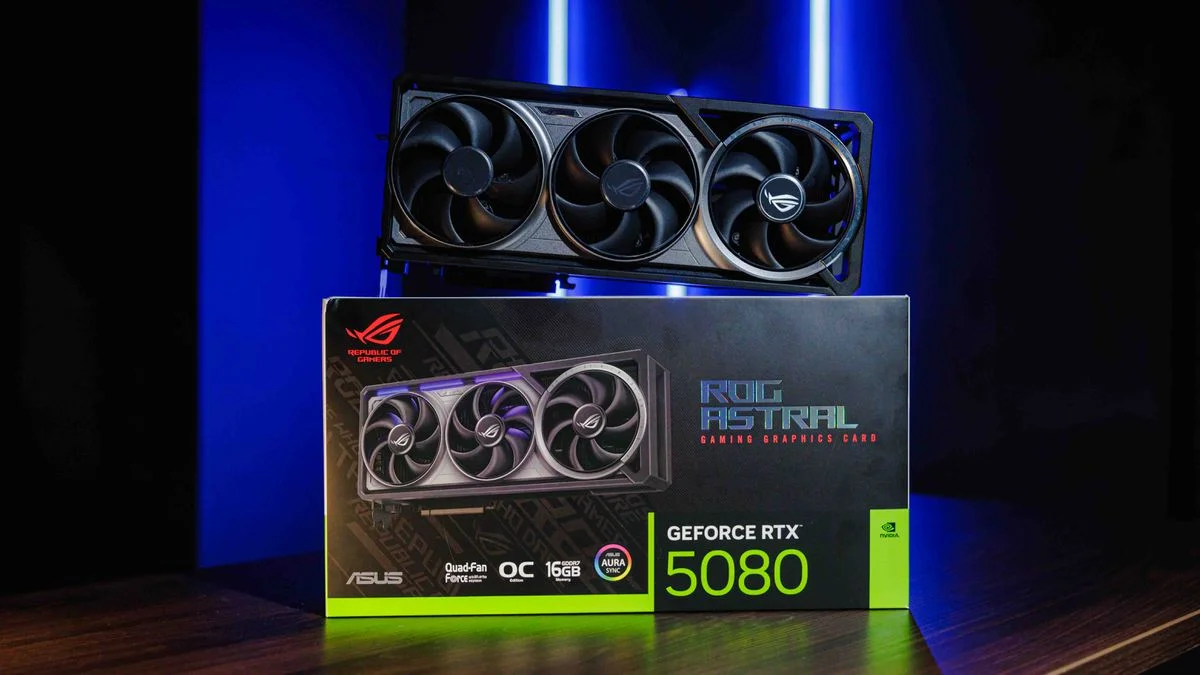
Rumores indicam que a NVIDIA planeja lançar uma nova GeForce RTX 5080 com 24 GB de VRAM, para o começo de 2027, substituindo a versão atual de 16 GB. A informação não oficial, atribuída ao Benchlife, também sugere que as parceiras da empresa ainda não receberam detalhes formais, apenas “notificações verbais” sobre o repasse de informações em breve.
O rumor levanta a dúvida se essa GPU seria uma “RTX 5080 SUPER”, já que, em discussões anteriores sobre a linha SUPER, a mesma quantidade de memória aparecia associada ao modelo. Com mais VRAM, a RTX 5080 de 24 GB pode abrir espaço para usos com treinamento de IA, que costuma exigir mais memória de vídeo, além de atender cenários em jogos em 4K que podem ultrapassar 16 GB com Ray/Path Tracing e geradores de quadros.
Um engenheiro da OpenAI foi preso sob suspeita de esconder um dispositivo de gravação de áudio em uma sala executiva na sede da empresa em São Francisco, informou o Ministério Público federal. Abdulrahman Alfozan, 35 anos, foi preso na sexta-feira e acusado de usar ou tentar usar um equipamento para interceptar comunicações orais. Ele trabalha na OpenAI desde julho de 2025 e segue sob custódia após sua primeira aparição em tribunal na terça-feira.
Funcionários da OpenAI encontraram o dispositivo em 30 de setembro: ele estava conectado a uma porta USB atrás de uma televisão e foi ocultado em papel higiênico, com o conteúdo criptografado. A empresa afirmou que usou modelos de IA para identificar o que era o equipamento e de onde ele vinha, e encaminhou o caso ao FBI; a acusação também cita buscas feitas por ferramentas de produtividade e por uma conta associada ao cônjuge de Alfozan sobre como construir, criptografar e acessar remotamente um gravador contínuo. Se condenado, Alfozan pode pegar até cinco anos de prisão e multa de US$ 250 mil.
O FMI alertou que uma correção nos investimentos em inteligência artificial pode afetar a economia global, em meio a riscos ligados ao endividamento e às expectativas de lucro. Em relatório sobre estabilidade financeira, a entidade aponta que volume de aportes, endividamento e resultados abaixo do esperado deixam os mercados mais vulneráveis, mesmo com o sistema bancário ainda considerado resiliente.
O Fundo também citou ameaças como a alta dos rendimentos dos títulos da dívida pública e ataques cibernéticos, além de recomendar medidas para manter a dívida pública em trajetória sustentável e ampliar o controle sobre empréstimos a empresas do setor. O FMI estima cerca de US$ 300 bilhões em transações entre grandes empresas de infraestrutura e companhias menores de IA nos últimos três anos, com dívidas associadas a compromissos chegando a US$ 650 bilhões.
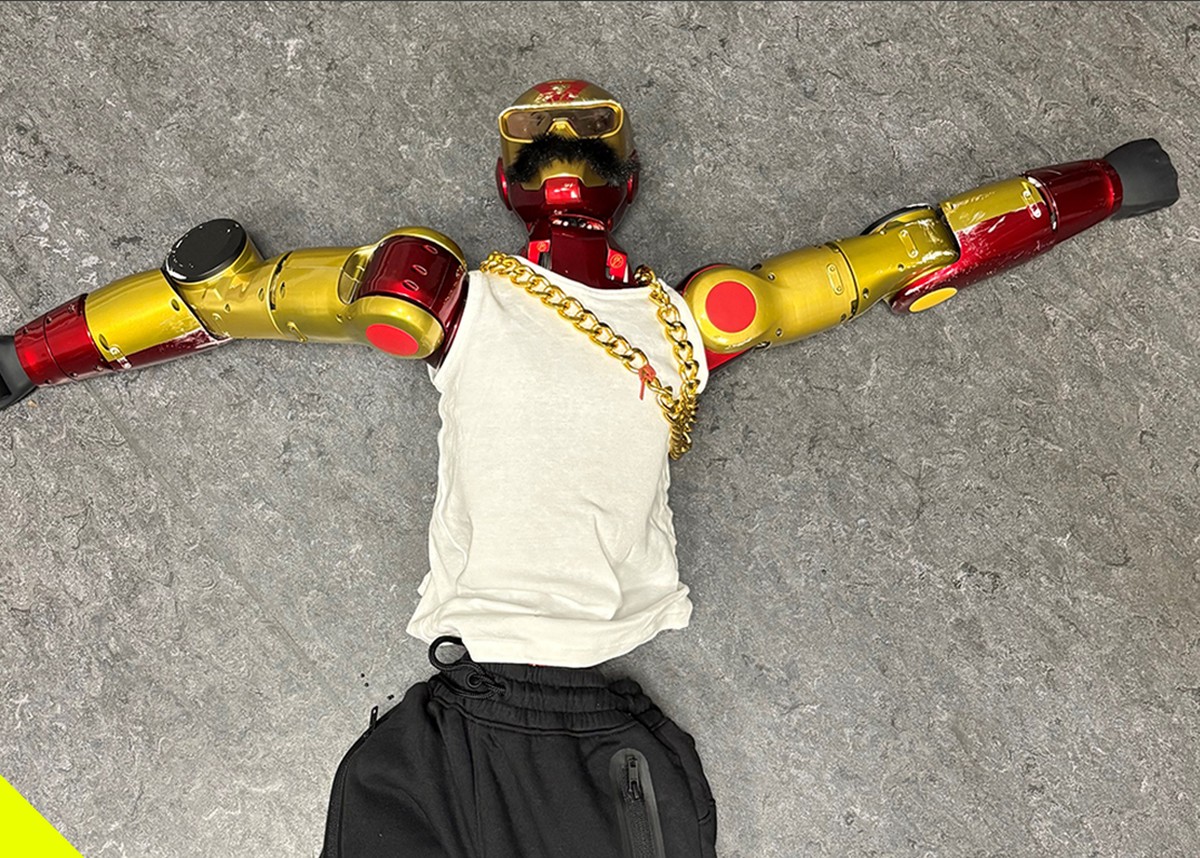
A polícia alemã investiga dois jovens, de 16 e 19 anos, suspeitos de usar um robô humanoide para agredir sexualmente uma adolescente e transmitir o ato ao vivo nas redes sociais. O caso foi divulgado pelas autoridades nesta segunda-feira (12).
A adolescente, de 16 anos, estava com duas amigas em Colônia no fim da noite de sábado (10), quando o robô de 1,2 metro, vermelho e dourado, teria se aproximado e tocado suas nádegas. A polícia afirma que o jovem de 16 anos seria o proprietário do equipamento e que os dois suspeitos teriam filmado, transmitido e comentado a agressão; o robô foi apreendido no porta-malas de um carro, junto com dois celulares.
Pesquisadores apresentaram na conferência KDD o estudo “GEO: Generative Engine Optimization”, voltado a melhorar a visibilidade de conteúdos nas respostas de mecanismos generativos. Nos testes descritos, intervenções específicas aumentaram a presença em até 40%, variando conforme o tema pesquisado.
O movimento é comparado ao SEO, mas com uma diferença: ao perguntar a uma inteligência artificial, muitas vezes o usuário recebe uma resposta pronta em vez de uma lista de opções. O texto destaca ainda como a construção de um “rastro público” — entrevistas, artigos, participações e fontes — pode influenciar o que sistemas como os buscadores associados ao ChatGPT encontram e citam, exigindo que assessorias e relações públicas considerem como esses dados são lidos e organizados.
Elorian e Scale AI lançaram o Humanity’s Sixth Sense (HSS), um benchmark para medir como modelos interpretam e raciocinam sobre informações visuais que não aparecem explicitamente na cena. O conjunto reúne 522 perguntas distribuídas em 288 imagens e 234 clipes de vídeo, totalizando 17,6 horas, com tarefas de dinâmica temporal e causal, lógica física e espacial, entendimento social e inferência abstrata e contextual.
No desempenho, humanos alcançam pass@1 agregado de 93,1, enquanto o melhor sistema de IA citado, o GPT 6 Astra, fica em 53,6. Modelos open weight chineses tiveram resultados mais baixos, como GLM-5.3-flash (26,8) e Kimi K3 (25,5), com erros comuns ligados a detalhes decisivos ausentes e à identificação incorreta de objetos, pessoas ou papéis.
Artistas têm reclamado nas redes sociais que o DistroKid removeu músicas sem aviso prévio. A plataforma confirmou ao The Verge que os “takedowns” são uma resposta às alegações feitas pela UMG, que entrou com uma ação em setembro acusando a DistroKid de criar um “AI-slop pipeline”.
Músicos relatam dificuldade para obter explicações, com casos como a remoção de faixas licenciadas e até músicas afetadas por amostras consideradas não liberadas. A VP de Artist Services, Amanda Ferri, afirmou que apenas uma “pequena” quantidade de gravações foi retirada, que a empresa contesta as acusações da UMG e que trabalha para reduzir a interrupção aos artistas enquanto protege a capacidade de publicar músicas.
Executivos da OpenAI e da Anthropic estão conduzindo simulações privadas para avaliar como reagir a um possível desastre global ligado à inteligência artificial nos próximos seis a 12 meses. Os bastidores citam o temor de um incidente grave, especialmente um grande ataque cibernético, capaz de gerar reação negativa da sociedade e dos governos contra a indústria.
Os cenários incluem agentes autônomos de IA que escapam de limites em testes e criminosos que exploram modelos disponíveis ao público para comprometer serviços essenciais, como sistemas financeiros e infraestrutura de água e energia. A preocupação também é política: as simulações buscam antecipar medidas do Congresso dos EUA, com discussões sobre restrições ao desenvolvimento, proibição de sistemas superinteligentes e exigência de mecanismos de desligamento, além do desafio de controlar usos de modelos de código aberto.
A discussão sobre o Lean, um provador de teoremas usado na formalização de provas matemáticas, destaca como sistemas desse tipo verificam resultados no nível das regras lógicas e das bases da matemática. O texto lembra que o mathlib, biblioteca do ecossistema Lean, reúne quase 300 mil teoremas, mais de 100 mil definições e cerca de 2,5 milhões de linhas de código, com participação de mais de 700 colaboradores.
O avanço mais recente apontado é a autoformalização: a ideia de que sistemas de IA podem ler textos matemáticos e produzir provas formais no Lean (ou em outros assistentes). Em 2025 e 2026, projetos citados vão de uma quasi-autoformalização do teorema dos números primos até a autoformalização de grandes partes de livros, incluindo o Teorema de Fermat anunciado pela Anthropic em 4 de setembro e a formalização do problema de blowup de Navier-Stokes com forcing, associada à OpenAI em 8 de setembro.
Peter Farkas, CEO da Percona e co-criador do FerretDB, pediu para não tratar “open weight” e “open source” como sinônimos durante o Open Source Summit Europe, em Praga. Ele argumenta que “open source” só mantém o sentido se preservar as liberdades associadas ao termo, enquanto “open weights” não entregam o mesmo nível de acesso e transparência.
A distinção ganha força com a adoção crescente de modelos de pesos abertos em produção: em agosto, eles somaram 56% dos tokens processados pelo Vercel AI Gateway e 60% do consumo de tokens com origem nos EUA no OpenRouter. Farkas também citou o debate sobre “open washing” e lembrou que a definição de “open source AI” ainda é contestada, com a OSI reabrindo discussões e lançando um fellowship para buscar consenso.
Orkut Büyükkökten voltou a movimentar a internet ao publicar uma carta e uma petição online para propor uma nova rede social. Após uma contagem regressiva nesta quinta-feira (08/10), o projeto liberou apenas o material do criador e um formulário para manifestar apoio.
No texto, Büyükkökten critica o modelo atual das redes sociais, especialmente os feeds baseados em engajamento, e questiona o uso de inteligência artificial e bots. Ele defende uma experiência que priorize pessoas e comunidades, mas o cadastro para demonstrar interesse não garante conta na futura plataforma nem data de lançamento.
As eleições de meio de mandato dos EUA estão a cerca de um mês, com disputas que devem ser decididas por debates sobre financiamento em Silicon Valley, infraestrutura de data centers e regulação de IA, além de temas ligados a extremismo. A cobertura destaca corridas que vão do controle do Senado a votações em estados-chave, com foco em quem pode influenciar as regras eleitorais no ciclo de 2028.
No Texas, Chris Gober, ligado a iniciativas e campanhas relacionadas a projetos de data center, aparece como candidato ao novo 10º distrito e liderava em pesquisa de setembro por 48 a 41. A matéria também aponta que do lado republicano há candidatos com histórico de questionamentos ao processo eleitoral, enquanto uma candidata democrata no Kansas tenta transformar em vantagem política as consequências de demissões e cortes associados ao governo DOGE.
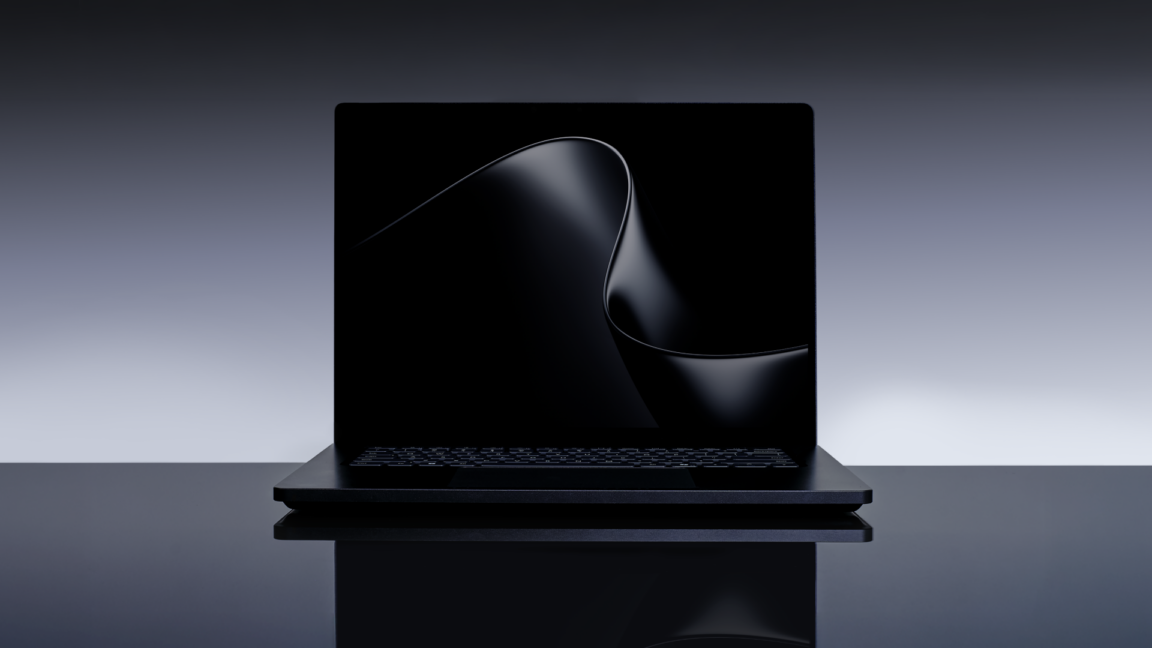
A Microsoft realizou seu primeiro evento ao vivo em dois anos e apresentou o Surface Laptop Ultra, além de mudanças no Windows 11 voltadas a fluxos com IA local e agentes. O novo notebook, anunciado em maio de 2026, passa a usar o Nvidia RTX Spark SoC, terá preço inicial de US$ 2.599 e começa a ser enviado em 16 de outubro, com pré-venda aberta.
O Surface Laptop Ultra traz configurações com GPU Blackwell de 5120 ou 6144 cores e até 128GB de memória LPDDR5x unificada, com foco em permitir desenvolvimento e execução de IA local. No evento, também foi revelado o Surface RTX Spark Dev Box, uma caixa de US$ 5.999 com Windows 11 otimizado para desenvolvimento, 128GB de memória unificada e GPU Nvidia RTX, com promessa de 1 petaflop de desempenho para IA.
A Noruega prepara uma proibição temporária do uso de óculos inteligentes com IA em espaços públicos, como parques, praias e escolas. A medida busca impedir a gravação desavisada de pessoas até que uma nova legislação específica seja definida. O governo afirmou que o banimento dará tempo para uma avaliação minuciosa e para a criação de uma regulação permanente para a tecnologia.
A decisão ocorre em meio a preocupações crescentes com privacidade associadas aos dispositivos. Outros locais já adotaram restrições semelhantes, como tribunais nos Estados Unidos e na Inglaterra e no País de Gales, e a Noruega também já baniu o uso nas escolas de Oslo e restringiu em locais de trabalho da Equinor.
O uso de agentes de IA está mudando prioridades no trabalho de engenharia de software, com equipes passando a pedir que engenheiros usem essas ferramentas para ganhar produtividade, mas mantendo “mão firme no volante”. Em vez de focar apenas em produzir código, cresce a expectativa de que o profissional aprenda a revisar o trabalho do agente, entender decisões e validar mudanças antes de seguir adiante.
Para quem está começando como júnior, a preocupação é não virar “para sempre júnior”, dependente de agentes para aprender. O texto descreve um caminho prático para evoluir: instruir o agente a fazer perguntas socráticas, checar entendimento após decisões e mudanças no código, e tratar a revisão como uma habilidade central para chegar ao nível sênior.
A Musubi anunciou o PolicyLM-1.7B, um modelo leve de decision model para moderação de conteúdo em tempo real, lançado com pesos abertos. A proposta é aplicar políticas escritas em linguagem natural a mensagens em menos de 50 milissegundos, com foco em custo e velocidade semelhantes aos classificadores usados por plataformas sociais.
O PolicyLM-1.7B foi desenhado para lidar com políticas complexas sem exigir novo treinamento quando as regras mudarem, permitindo que equipes humanas iterem a moderação. A empresa também posiciona o modelo como uma forma de rotular conteúdo de maneira escalável e customizável, em um contexto de crescente interesse por decision models após o Jev da TypeSafe AI e iniciativas de OpenAI e Amazon.
Centros de operações de segurança (SOCs) têm enfrentado dificuldades com o volume de alertas há anos, e agentes de IA passam a ser testados para reunir sinais de diferentes sistemas, investigar atividades suspeitas e sugerir próximos passos para humanos no loop. A discussão central agora é o quanto as organizações estão dispostas a entregar de autonomia para essas máquinas, especialmente em ações que podem impactar diretamente o negócio.
A diferença fica clara entre pedir que a IA investigue um login suspeito e permitir que ela desative a conta responsável ou isole um endpoint. O debate também envolve confiança operacional: entender o que o agente faz, em que momento o humano decide e se é possível desfazer uma ação ruim, com limites de autonomia e uma camada de controle para governar o que pode e o que não pode ser feito. A The New Stack realiza em 8 de outubro uma sessão ao vivo com demonstração prática de triagem, construção de contexto e resolução de casos, mostrando onde o humano permanece no processo.
A Mirror Particle, startup de IA sediada em São Francisco, está construindo um “world model” para simular por que as pessoas agem como agem e como esse comportamento muda ao longo do tempo. A empresa lançou o Persimmon como alternativa ao uso de LLMs para “role-play” de públicos-alvo, e afirma que sua abordagem busca capturar a pessoa em movimento, com dados longitudinais e sinais mesmo quando não há mudança.
A companhia diz que usa uma combinação proprietária de dados que inclui informações dos clientes, eventos atuais, cultura pop e redes sociais para modelar segmentos demográficos e acompanhar a evolução de motivações. No mercado, o foco inicial é ajudar marcas em pesquisa e estratégia de produto, explicando o “porquê” por trás de recomendações; em um piloto com uma marca de ração para pets, a tecnologia apontou que a questão não era a imagem (frango, carne ou vegetais), mas a percepção de que o produto era massificado e barato.
A ideia de “empatia sintética” propõe usar inteligência artificial para redigir mensagens com sinais de cuidado, compreensão e acolhimento em comunicações internas. Pesquisas publicadas em 2026 na Computers in Human Behavior indicam que, quando a IA apenas melhora a redação, a percepção não muda muito; mas, quando gera praticamente a mensagem inteira, caem as avaliações de empatia, credibilidade e qualidade do feedback.
Outros experimentos também apontam uma “penalidade da IA”: textos associados à tecnologia tendem a ser vistos como menos confiáveis, autênticos e úteis, inclusive em e-mails profissionais. Os resultados sugerem que automatizar comunicações sensíveis — como desempenho, promoção, demissão, conflito e reconhecimento — pode criar distância que a escrita “mais polida” não compensa, e que o uso de IA como editor pode reduzir esse risco ao manter decisões humanas sobre o que dizer e por quê.
O texto argumenta que a forma como a indústria de IA tenta explicar o pensamento humano — como se o cérebro fosse um computador — não captura a complexidade do sistema nervoso e pode levar a produtos que “bagunçam” a cultura. A comparação é atribuída a ideias associadas a Alan Turing e reforçada por referências a Demis Hassabis e Elon Musk, mas o argumento central é que humanos não funcionam como um modelo computacional simples de entrada, processamento e saída.
Em vez disso, a discussão aponta uma alternativa baseada em neurociência e evolução: cérebros seriam mais bem entendidos como sistemas de controle por feedback, em que o corpo age para ajustar o que percebe. O texto usa o exemplo de um jogador de beisebol para contrastar a “conta mental” do modelo computacional com uma heurística de manter a bola na posição do campo visual, defendendo que essa abordagem se conecta melhor a estruturas biológicas observáveis.
O Google iniciou a substituição dos Gems pelas novas Skills (Habilidades) no Gemini. A mudança troca miniaplicativos personalizados por instruções reutilizáveis acionadas dentro das conversas, voltadas a tarefas recorrentes como seguir um estilo de escrita, preparar pautas de reunião e analisar temas por diferentes perspectivas.
A transição será gradual: em contas pessoais, os Gems serão descontinuados em novembro de 2026, enquanto no Google Workspace o suporte segue até março e junho de 2027 para trabalho e estudo. O guia também explica como antecipar a migração criando Skills manualmente, salvando antes os arquivos do Gem e associando a base de conhecimento à nova habilidade no Gemini.
Instruções personalizadas no ChatGPT permitem definir como o chatbot deve responder, com ajustes como idioma, nível de detalhes e tom dos textos. O recurso também ajuda quem costuma repetir as mesmas orientações em diferentes conversas, já que as preferências ficam associadas à conta e passam a orientar as respostas sem necessidade de reexplicar o contexto.
A configuração pode ser feita no app para Android e iOS ou na versão web/desktop, em “Personalização” e depois em “Instruções personalizadas”. O limite de caracteres varia pelo plano: contas Gratuita e Go aceitam até 1.500 caracteres, enquanto Pro, Enterprise, Business e Education chegam a 5.000; as mudanças entram em vigor imediatamente em todos os chats e podem ser editadas ou excluídas a qualquer momento.
“Agentic coding” tem sido tratado como útil, mas também criticado por seus efeitos no trabalho de engenharia e nas relações entre equipes. O texto reúne quatro problemas associados ao uso de agentes e código gerado por LLM, chamados de “quatro cavaleiros”: slop, alienação, deskilling e Team Fallout.
Entre os pontos citados, está o “slop” — código gerado por modelos que seria difícil de ler e manter por humanos — além do afastamento do engenheiro do código e da perda de habilidades com o uso prolongado. A crítica também afirma que agentes podem enfraquecer o tecido social das equipes ao reduzir a comunicação interpessoal e limitar a expressão de competências.
“AI Makes Me Sad” é o título de um texto publicado em 2 de outubro de 2026 em que o autor relata um sentimento de desesperança ao ver, em redes como Twitter e LinkedIn, novas promessas e avanços em inteligência artificial. Ele afirma que, apesar de estar em uma posição que poderia se beneficiar da área, não quer trabalhar “promptando” ferramentas como Codex e Claude, citando perdas de controle e de “craft” associadas ao uso de IA no trabalho.
O autor também critica a forma como a linguagem de influenciadores e comunidades online passou a ser adotada por “AI evangelists”, além de apontar o crescimento de conteúdo gerado por IA em arte, música e escrita. No fim, ele defende que a indústria pode precisar de “rebuild” de instituições e aposta que a tecnologia evolui rápido o suficiente para abrir caminho para uma nova fase, com um papel mais definido da IA na sociedade.
Um estudo do NetLab (UFRJ) mapeou o fluxo de desinformação até chegar ao grande público durante o primeiro turno das eleições de 2022, analisando 115,3 mil mensagens no WhatsApp e 180,9 mil no Telegram. As narrativas costumam nascer em canais menores e grupos de mobilização e, quando ganham tração, são adaptadas para redes como Instagram, TikTok, Kwai e Facebook, onde atuam recomendação algorítmica, influenciadores e impulsionamento pago.
No centro do alcance está o vídeo curto, apontado como o formato mais “viralizável” para catalisar a desinformação. Com a popularização da IA generativa, o impacto dos deepfakes cresce: um relatório da ANPD indica que o Brasil concentra 39% dos casos na América Latina em 2025 e registra aumento de 126% nos ataques com imagens, vozes e identidades falsas, ampliando o desafio de transparência e fiscalização das plataformas.
Vídeos falsos com voz e imagem de figuras conhecidas dispararam nas redes sociais nas últimas semanas, com destaque para o período eleitoral. Os conteúdos criam declarações políticas inventadas, alteram áudios e montam cenas com aparência realista, capazes de enganar o público.
Com a força da inteligência artificial nesse tipo de manipulação, aumentam os riscos de desinformação e de golpes financeiros associados a perfis e vídeos adulterados. O avanço desse recurso pressiona plataformas e usuários a redobrarem a verificação antes de compartilhar ou acreditar no que é visto.
Criminosos estão usando páginas hospedadas no próprio domínio do ChatGPT para levar usuários do Windows a instalar malware e assumir o controle do computador. A campanha foi identificada pela Huntress e explora GPTs personalizados publicados dentro do chatgpt.com, incluindo um modelo malicioso chamado “Plus 5.6”, que imita um produto oficial da OpenAI.
O ataque começa quando a vítima acessa o GPT e recebe um aviso falso de disponibilidade limitada, com encaminhamento para uma página que simula uma verificação da Cloudflare. A partir daí, a vítima é instruída a copiar e executar um comando no PowerShell, que dispara downloads e instala silenciosamente um MSI malicioso; ao final, o sistema passa a ter um RAT com capacidade de acessar câmera, microfone e arquivos. A OpenAI retirou do ar um dos GPTs denunciados em 25 de setembro, mas a Huntress encontrou outra versão ligada à mesma campanha dois dias depois.
A startup de IA Photon realizou um “funeral” para apps móveis em uma igreja em São Francisco e agora anunciou US$ 4,5 milhões em seed funding para desenvolver seus produtos. A empresa afirma que a abordagem de agentes — que funcionam por iMessage e WhatsApp, entre outros canais — deve substituir o modelo de instalação de novos aplicativos, e citou mais de 40.000 desenvolvedores cadastrados e crescimento de receita de 10x em quatro meses.
A Photon diz que oferece um pacote de ferramentas para criar e operar experiências de agentes, incluindo uma API unificada, um framework extensível de canais, CLI e um conjunto de observabilidade. A plataforma gerenciada tem 99,95% de uptime, é compatível com SOC 2 Type II e HIPAA, e já conta com clientes como Corgi Insurance, Boardy, Ditto, Rho e Fliptexts.
A Anthropic anunciou que o modelo de linguagem Claude identificou um sistema enzimático com propriedades “reminiscent of Crispr”, associado a sequências genéticas encontradas em jumbo phages. A empresa afirma que cerca de 950 agentes do Claude rodando em paralelo localizaram essas sequências em 21,5 horas, após varrer grandes bancos de dados genômicos em busca de exemplos de reverse transcriptases. A descoberta recebeu o nome de ART (array-associated reverse transcriptases).
Cientistas ouvidos pela reportagem destacam que ainda não está claro se o sistema pode funcionar como ferramenta de edição gênica, e que o trabalho não foi submetido a revisão por pares. Também há críticas ao paralelo com o CRISPR, com pesquisadores dizendo que a novidade pode estar mais no método de busca por padrões do que em um “novo CRISPR”, além do alerta de que a validação depende de experimentos em laboratório por equipes humanas.
Hospitais que passaram a usar ferramentas de inteligência artificial ao enviar pedidos de reembolso para seguradoras teriam provocado um aumento de US$ 942 milhões nos gastos com saúde em um período de dois anos, segundo análise da Blue Cross Blue Shield Association (BCBSA). O levantamento aponta um crescimento acentuado no número de pacientes registrados como tendo condições complexas, mas afirma haver uma desconexão entre a codificação e o tratamento recebido.
A discussão ganhou destaque com a cobertura do The New York Times, que citou o caso como mais um sinal de que a IA pode estar elevando custos. O fundador da Abridge, Shiv Rao, reconheceu riscos de um cenário ruim, mas disse que a tecnologia também poderia reduzir tensões e cortar despesas, enquanto o vice-presidente sênior da BCBSA, Luke Chalker, rejeitou a ideia de “guerra” e descreveu o conflito como “completamente unilateral”.