A Spotify ampliou o uso de desenvolvimento assistido por IA e mais que dobrou as mudanças mensais mescladas, de cerca de 8.100 para 17.000 ano a ano em agosto. Com o aumento do volume de alterações nos sistemas de produção, a empresa ajustou controles de qualidade e confiabilidade para lidar com a nova escala.
A companhia opera quase 3.000 serviços de produção para 777 milhões de usuários ativos mensais e relata desafios em processamento de conteúdo, automação de frota e capacidade de computação. Entre as respostas estão melhorias em monitoramento e testes, salvaguardas de rollout e capacidade de rollback, além da adoção do Honk, um agente de codificação em background que executa o Claude via Agent SDK em pods no Kubernetes.
Pesquisadores apresentaram na conferência KDD o estudo “GEO: Generative Engine Optimization”, voltado a melhorar a visibilidade de conteúdos nas respostas de mecanismos generativos. Nos testes descritos, intervenções específicas aumentaram a presença em até 40%, variando conforme o tema pesquisado.
O movimento é comparado ao SEO, mas com uma diferença: ao perguntar a uma inteligência artificial, muitas vezes o usuário recebe uma resposta pronta em vez de uma lista de opções. O texto destaca ainda como a construção de um “rastro público” — entrevistas, artigos, participações e fontes — pode influenciar o que sistemas como os buscadores associados ao ChatGPT encontram e citam, exigindo que assessorias e relações públicas considerem como esses dados são lidos e organizados.
A Starlink já permite que celulares se conectem diretamente aos satélites por meio da tecnologia Direct to Cell, sem a antena usada no serviço residencial. A proposta evoluiu de mensagens de texto para acesso a dados e chamadas via aplicativos, com operação feita em parceria com operadoras de telefonia que disponibilizam parte das frequências.
No Brasil, Vivo e Starlink participam de um ambiente experimental autorizado pela Anatel, com permissão válida até abril de 2029, mas ainda sem oferta comercial ampla. Enquanto isso, a SpaceX recebeu autorização da FCC para implantar até 15 mil satélites de nova geração, com novas frequências para ampliar cobertura e capacidade, inclusive em ambientes internos, aproximando a tecnologia de serviços móveis mais avançados.
Agentes de IA já podem estar “no ar” e com serviço saudável, mas ainda assim a equipe precisa garantir que as respostas estejam melhorando. Ao conectar production traces, dados curados e avaliações, times conseguem identificar falhas, definir melhorias e demonstrar que a próxima versão funciona antes de chegar aos usuários.
O ciclo descrito passa por executar o agente, observar além da disponibilidade, curar exemplos de produção em datasets e suites de avaliação, melhorar o sistema e avaliar resultados antes e depois do deploy. A CoreWeave apresentou o CoreWeave Forge para integrar esse fluxo em um ambiente de desenvolvimento, reunindo ferramentas como Agent Lens, Notebooks, ARIA, Sandboxes e registros de modelos, experimentos e datasets para manter rastreabilidade da versão do modelo até os exemplos em produção.
A Microsoft lançou o Microsoft-Decision-1 no Foundry, três dias depois de a OpenAI abrir sua Decisions API para beta público. O modelo foi “post-trained” com base no Alibaba Qwen3.5-9B, com a empresa dizendo que pretende fazer um rebasing para seus próprios modelos MAI e também para a OpenAI. O preço informado é de US$ 0,042 por milhão de tokens de entrada, com saída gratuita, e o modelo aceita até 32.768 tokens de texto, retornando JSON.
A Microsoft afirma que o Decision-1 é usado internamente em tarefas como triagem de feedback de jogadores no Xbox Research, avaliação de respostas do Copilot e apoio a engenheiros em incidentes ao puxar contexto. A empresa também destaca o foco em decisões em “ambiente seguro e confiável”, mas não anunciou suporte a imagens e orienta clientes a validarem a calibração das probabilidades nos próprios dados, especialmente sob entradas adversariais.
O podcast do InfoQ Engineering Culture recebeu Matt Gjertsen, fundador da Built e autor de “Minimum Viable Manager”, para falar das três habilidades essenciais de liderança para quem está gerenciando pela primeira vez. A conversa destaca responsabilidades como fazer as pessoas trabalharem juntas, direcioná-las para as tarefas certas e melhorar o trabalho ao longo do tempo, começando por confiança, expectativas claras e feedback.
O episódio detalha como construir confiança com base em habilidades, decisões e conexão pessoal, além de alertar que novos gestores podem focar demais em provar competência e de menos em criar vínculo. Também aborda como estruturar feedback eficaz, começando por ensinar o time a pedir feedback, usando reforços e redirecionamentos com foco em comportamentos observáveis, e aplicando uma abordagem de gargalo para decidir o que desenvolver em seguida.
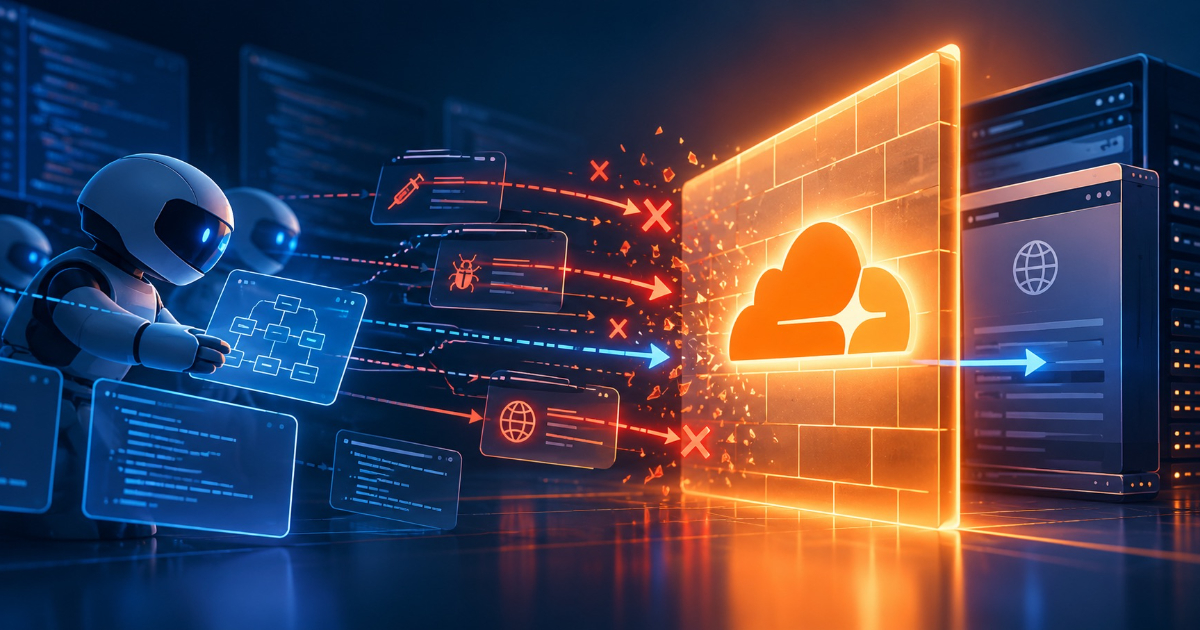
Modelos de IA de ponta foram colocados por a Cloudflare dentro de um harness de testes controlado para avaliar e fortalecer o Web Application Firewall (WAF). A equipe usou ataques que o WAF já bloqueava como ponto de partida e fez os modelos gerarem variações, refinando encoding, posicionamento e entrega das requisições com base nas respostas anteriores.
Em 45 cenários, o sistema registrou 1.107 tentativas e deixou 49 achados após triagem humana. O experimento resultou em três mudanças no Managed Ruleset, incluindo duas novas detecções para SSRF (SSRF - Obfuscated Host e SSRF - Restricted Protocol) e uma melhoria na regra SSRF - Cloud, mostrando como o loop de feedback e a validação final ajudam a transformar exploração probabilística em evidência para ajustes de segurança.
A ideia de “empatia sintética” propõe usar inteligência artificial para redigir mensagens com sinais de cuidado, compreensão e acolhimento em comunicações internas. Pesquisas publicadas em 2026 na Computers in Human Behavior indicam que, quando a IA apenas melhora a redação, a percepção não muda muito; mas, quando gera praticamente a mensagem inteira, caem as avaliações de empatia, credibilidade e qualidade do feedback.
Outros experimentos também apontam uma “penalidade da IA”: textos associados à tecnologia tendem a ser vistos como menos confiáveis, autênticos e úteis, inclusive em e-mails profissionais. Os resultados sugerem que automatizar comunicações sensíveis — como desempenho, promoção, demissão, conflito e reconhecimento — pode criar distância que a escrita “mais polida” não compensa, e que o uso de IA como editor pode reduzir esse risco ao manter decisões humanas sobre o que dizer e por quê.
O texto argumenta que a forma como a indústria de IA tenta explicar o pensamento humano — como se o cérebro fosse um computador — não captura a complexidade do sistema nervoso e pode levar a produtos que “bagunçam” a cultura. A comparação é atribuída a ideias associadas a Alan Turing e reforçada por referências a Demis Hassabis e Elon Musk, mas o argumento central é que humanos não funcionam como um modelo computacional simples de entrada, processamento e saída.
Em vez disso, a discussão aponta uma alternativa baseada em neurociência e evolução: cérebros seriam mais bem entendidos como sistemas de controle por feedback, em que o corpo age para ajustar o que percebe. O texto usa o exemplo de um jogador de beisebol para contrastar a “conta mental” do modelo computacional com uma heurística de manter a bola na posição do campo visual, defendendo que essa abordagem se conecta melhor a estruturas biológicas observáveis.
O Instagram anunciou que o app standalone Edits vai ganhar um “creative assistant” com inteligência artificial para dar feedback sobre publicações. A ferramenta usa dados do perfil do usuário e oferece sugestões do que ajustar, conectando métricas como curtidas, visualizações, retenção em vídeos e compartilhamentos.
Com o assistente, criadores podem fazer perguntas abertas sobre tendências no Instagram, por que um vídeo funcionou melhor que outro e qual tipo de conteúdo mais ressoou com o público. O recurso também sugere ideias de conteúdo, ganchos para prender a audiência, legendas, faixas de áudio em alta e roteiros de vídeos, e será gratuito até um limite, com usuários avançados podendo precisar de assinatura Meta One para mais uso.
A OpenAI apresentou os Dots no DevDay, agentes persistentes baseados no GPT-6 Astra que rodam em computadores em nuvem próprios, usam navegadores dedicados e conseguem acessar mais de 4.000 apps via o ecossistema de plugins da empresa. Diferente de agentes que aguardam um novo comando, um Dot continua trabalhando quando o usuário sai, consegue tocar vários projetos ao mesmo tempo e mantém o que aprende entre ChatGPT, Slack e Microsoft Teams.
Nos exemplos para desenvolvedores, a OpenAI mostrou Dots acompanhando feedback de clientes para identificar solicitações recorrentes, definindo escopo para melhorias e correções, e entregando pull requests prontas com vídeos do que foi alterado. A empresa também descreveu um modo de “proactive research” com acesso somente leitura e um fluxo de “auto-review” para ações que possam afetar contas ou compartilhar informações, além de monitoramento para pausar ou interromper o agente quando houver risco.
A OpenAI anunciou o lançamento do Dots, um novo assistente pessoal agentic, no Dev Day desta terça-feira. A ferramenta é alimentada pelo GPT-6 Astra e foi descrita como um agente “sempre ativo”, capaz de executar objetivos definidos pelo usuário em segundo plano, com pouca supervisão.
O Dots começa a ficar disponível nesta terça-feira no ChatGPT para assinantes Pro e Business Premium em mercados elegíveis, com possibilidade de iniciar o agente a partir do Codex ou do próprio ChatGPT. A OpenAI também prevê uso em cenários como monitorar feedback de clientes com correções e melhorias, ou permitir que cientistas reexecutem análises, além de mensagens via Slack e Teams, com suporte por mensagem de texto chegando em breve.
A OpenAI anunciou, no Dev Day desta terça-feira, que está ampliando os plugins do ChatGPT com extensões que permitem criar experiências “tipo app” dentro do próprio chat. Com isso, desenvolvedores poderão colocar seus aplicativos em um espaço dedicado na barra lateral do ChatGPT e oferecer painéis interativos para o usuário trabalhar com ferramentas enquanto conversa.
A empresa também detalhou melhorias no processo de criação e descoberta de plugins, incluindo uma ferramenta Plugin Creator e um fluxo de submissão com feedback mais claro. Além disso, o ChatGPT Sites poderá hospedar esses plugins, e a OpenAI disse que adicionou suporte à especificação MCP Events para iniciar automações com base em eventos de apps conectados, com automações mais fáceis de adicionar e gerenciar.
No evento anual Made On YouTube, o YouTube anunciou novas ferramentas para o YouTube Studio, aplicativo usado por criadores para gerenciar seus canais e analisar vídeos. Entre as novidades, o Ask Studio, recurso de perguntas e respostas com IA, chega ao iOS e Android, e a empresa também adiciona feedback automatizado para rascunhos, com sugestões sobre ritmo, estrutura e storytelling.
A plataforma ainda inclui um feed de pesquisa no Studio para mostrar quais tipos de conteúdo estão funcionando na rede e novas opções para títulos e thumbnails. O YouTube afirma que criadores já rodaram mais de 40 milhões de testes com A/B para títulos e imagens, e que em breve será possível testar até três cortes de vídeo; além disso, o Studio deve monitorar o desempenho das thumbnails e ajustar uma delas automaticamente quando não performar bem.
O YouTube anunciou, no evento Made on YouTube, uma atualização da sua suíte de ferramentas de criação com inteligência artificial. Entre as novidades está um agente de IA que atua em segundo plano para otimizar o canal, monitorando o catálogo de vídeos e sugerindo ajustes em títulos e thumbnails de conteúdos antigos que ganham relevância com tendências e notícias.
A plataforma também amplia recursos já existentes: o sistema passa a gerar títulos e thumbnails completos a partir de um vídeo enviado e permite que criadores peçam feedback sobre suas versões. No YouTube Studio, a empresa oferece testes com thumbnails dinâmicas para diferentes segmentos de público e testes com três variações do próprio vídeo (como mudanças no início), escolhendo o melhor resultado para manter ou aplicando automaticamente após sete dias.
A 404 Media relata que contratados que ajudam a melhorar modelos da OpenAI foram demitidos por usar IA para realizar tarefas ligadas ao treinamento. Segundo a apuração, alguns revisores teriam usado respostas geradas por IA para contribuir com o trabalho, apesar de haver orientações internas para não usar ferramentas desse tipo.
Os documentos citados pela reportagem indicam regras como não usar detectores de IA e não recorrer a modelos como GPTZero, além de evitar uso de IA para revisar, escrever feedback ou comentários. A OpenAI não comentou o caso, e a matéria também menciona que a Mercor, empresa que contrata parte desses profissionais, diz que remove especialistas do projeto quando confirma uso indevido de LLMs.
A vietnamita Vu Van, fundadora da ELSA, transformou uma dificuldade pessoal com a comunicação em inglês em uma plataforma de aprendizado baseada em inteligência artificial. Em 2015, ela criou a English Language Speech Assistant (ELSA) para oferecer feedback em tempo real durante a fala, com a proposta de funcionar como um “coach de conversação” disponível a qualquer hora.
Dez anos depois, a ELSA ultrapassou 100 milhões de usuários em 120 mercados, captou cerca de US$ 60 milhões e já trabalhou com mais de 1.300 organizações. A empresa agora instalou em São Paulo um escritório regional para as Américas e colocou o Brasil entre os mercados prioritários, mirando também a expansão do segmento corporativo (B2B).
A startup islandesa Treble levantou uma extensão de US$ 18 milhões para sua plataforma de simulação voltada à Voice AI. Fundada em 2020 por engenheiros acústicos Finnur Pind e Jesper Pedersen, a empresa teve a rodada liderada pela Paladin Capital Group, com participação de KOMPAS VC, Frumtak Ventures, EIC e Omega ehf, somando mais de US$ 40 milhões captados no total. A Treble já conta com Amazon e Logitech como clientes.
A plataforma da Treble inclui geração de dados sintéticos para tarefas como speech enhancement, noise suppression e treinamento de modelos, além de avaliação de modelos de Voice AI em diferentes condições para dar feedback a laboratórios. A empresa também trabalha com prototipagem virtual e testes de hardware sob uma perspectiva de áudio, e firmou parceria com a Hugging Face para lançar um benchmark de reconhecimento de fala em cenários realistas.
O Google começou a liberar gratuitamente o Daily Brief, recurso do Gemini que analisa informações pessoais do usuário e prepara um resumo diário com tarefas, compromissos e outras prioridades. Antes, a ferramenta exigia uma assinatura do Google AI, mas agora também está disponível para usuários gratuitos nos Estados Unidos.
O Daily Brief usa o Personal Intelligence para consultar dados de apps conectados, como Gmail e Google Agenda, além de conversas anteriores no Gemini, destacando os assuntos mais relevantes do dia. O usuário pode interagir com cada item para marcar como concluído, dispensar ou conversar com o Gemini, e esse feedback ajuda a ajustar os próximos resumos.
O GitHub Podcast reuniu Marlene Mhangami, GPS e o time do GitHub para destrinchar termos de IA que estão entrando no desenvolvimento de software, como loop engineering, Ralph loops, squads, harness engineering e hill climbing. A conversa também abordou conceitos como forward deployed engineer e as diferenças entre closed models, open weights e open source models.
Loop engineering, por exemplo, propõe criar sistemas repetíveis para agentes em vez de prompts pontuais, com validação e escalonamento quando algo “trava”. Já squads e fleets descrevem fluxos com múltiplos agentes em papéis diferentes ou em paralelo, enquanto harnesses são o conjunto de ferramentas, permissões, memória e orquestração que colocam o modelo para funcionar; hill climbing entra como a prática de melhorar agentes e harnesses com feedback e evals.
A experiência de pesquisadores que saem da teoria para aplicações no mundo real ganhou um novo impulso com o MIT-IBM Computing Research Lab, que conecta ex-alunos do MIT e um ex-postdoc hoje na IBM. Entre os temas trabalhados estão quantum machine learning, reinforcement learning e agentes de IA, além de foco em IA confiável e justa.
Na IBM, Zhang-Wei Hong desenvolveu técnicas para dar mais contexto e feedback de recompensa a agentes, aplicando ideias em robótica, LLMs e reinforcement learning para ciência. Irene Ko, por sua vez, trabalha em métodos para acessar sinais internos do modelo durante a inferência com o vLLM Hook, usando essas informações para analisar riscos como prompt-injection e alucinação, com uma proposta de plugin leve para reduzir custos.
A memória do ChatGPT ajuda a IA a manter informações relevantes sobre o usuário entre conversas. Com o recurso ativado, o chatbot pode considerar preferências de escrita, contexto de projetos e outras informações compartilhadas anteriormente, sem exigir que você repita tudo a cada novo chat.
O sistema funciona com memórias salvas e com referência ao histórico de conversas. O texto recomenda excluir memórias antigas, começar a salvar preferências claras, permitir que a IA lembre de projetos de longo prazo, usar o Chat Temporário quando quiser “recomeçar do zero” e dar feedback objetivo sobre o que funcionou para orientar interações futuras.
O Microsoft Copilot Studio permite que equipes criem copilotos personalizados para responder dúvidas, consultar documentos internos e automatizar tarefas da empresa. A plataforma define o assistente com instruções, regras e acesso a conteúdos autorizados, fazendo com que ele responda conforme o contexto configurado.
O processo envolve três etapas: definir a função do copiloto, configurar fontes de informação e publicar para uso na equipe. Antes do lançamento, é recomendado testar no ambiente de testes e, depois, acompanhar métricas como conversas, perguntas mais frequentes, taxa de resolução e feedback para atualizar o assistente continuamente.
A startup de robótica Generalist foi avaliada em US$ 3 bilhões após levantar capital adicional liderado pela 8VC, segundo duas pessoas com conhecimento do financiamento. O novo aporte soma quase US$ 200 milhões em um registro regulatório e estende uma rodada Series B de US$ 400 milhões anunciada em junho, que já havia sido feita com valuation de US$ 2 bilhões.
Com o capital recém-levantado, a rodada totaliza US$ 600 milhões. A Generalist desenvolve um modelo de base de IA para operar com diferentes robôs e afirma que o Gen 1.5 permite que robôs aprendam novas tarefas a partir de demonstrações em vídeo de 3 a 12 segundos, usando feedback de clientes para ajustar o modelo a casos de uso específicos.
O Harvard Business School (HBS) Foundry bootcamp de oito semanas, que custa US$ 699, passou a usar avatares de IA para dar feedback individual aos participantes. As versões virtuais dos instrutores foram criadas pela startup HeyGen e entram em cena durante practice pitches e reuniões de conselho, enquanto as sessões ao vivo com professores acontecem semanalmente.
A repórter do New York Times Sarah Kessler testou o recurso ao apresentar uma proposta com base em um texto gerado por IA para Jeff Bussgang, cofundador da Flybridge Capital. Kessler relatou que os avatares tiveram uma reação visível, com um sorriso “congelado”, e que Bussgang comentou que sua cópia digital é um pouco “creepy”, mas que seus alunos gostam da experiência.
O LinkedIn anunciou que reduziu em 40% as visualizações de publicações de baixa qualidade após implementar um botão de denúncia para esse tipo de conteúdo. A plataforma também informou que recebeu mais de 1 milhão de reclamações de posts gerados por inteligência artificial e que agora notifica os autores quando a denúncia aponta possível texto genérico de IA.
O diretor de produtos Hari Srinivasan afirmou que os membros já veem menos “textos robotizados” no feed. Para evitar abusos, o LinkedIn ajustou o algoritmo e criou mecanismos que impedem que ondas de feedback negativo sejam usadas para silenciar injustamente outros usuários, além de introduzir um sistema de transparência restrito ao painel de análise de publicações.
A Nvidia publicou uma pesquisa defendendo que, em tarefas de longo horizonte, o “harness” — o software que envolve o modelo com ferramentas, gestão de memória e regras — pesa mais do que o modelo em si. Com um harness customizado, ajustado para lidar melhor com memória e com um componente “supervisor”, pesquisadores fizeram o Claude Opus 5 atingir 100% no benchmark interativo ARC-AGI-3, um conjunto de jogos 2D sem instruções em que o agente precisa descobrir como jogar e vencer. Sem esse harness, o desempenho caiu para 30%, o melhor resultado entre os modelos testados.
A pesquisa reforça a ideia de que agentes de IA não são apenas o “cérebro” do LLM, mas um sistema que inclui contexto, feedback e runtime fornecidos pelo harness. A Nvidia também cita que, em testes com o mesmo benchmark, a OpenAI ajustou configurações do harness e triplicou as pontuações, mas sem chegar a 100%, sugerindo que o supervisor ajuda a redirecionar o agente quando ele se perde. O trabalho menciona ainda o uso de um harness próprio chamado Agentic Variation Operators (AVO) e a tese de que harnesses diferentes podem mudar custos e controle do ecossistema.
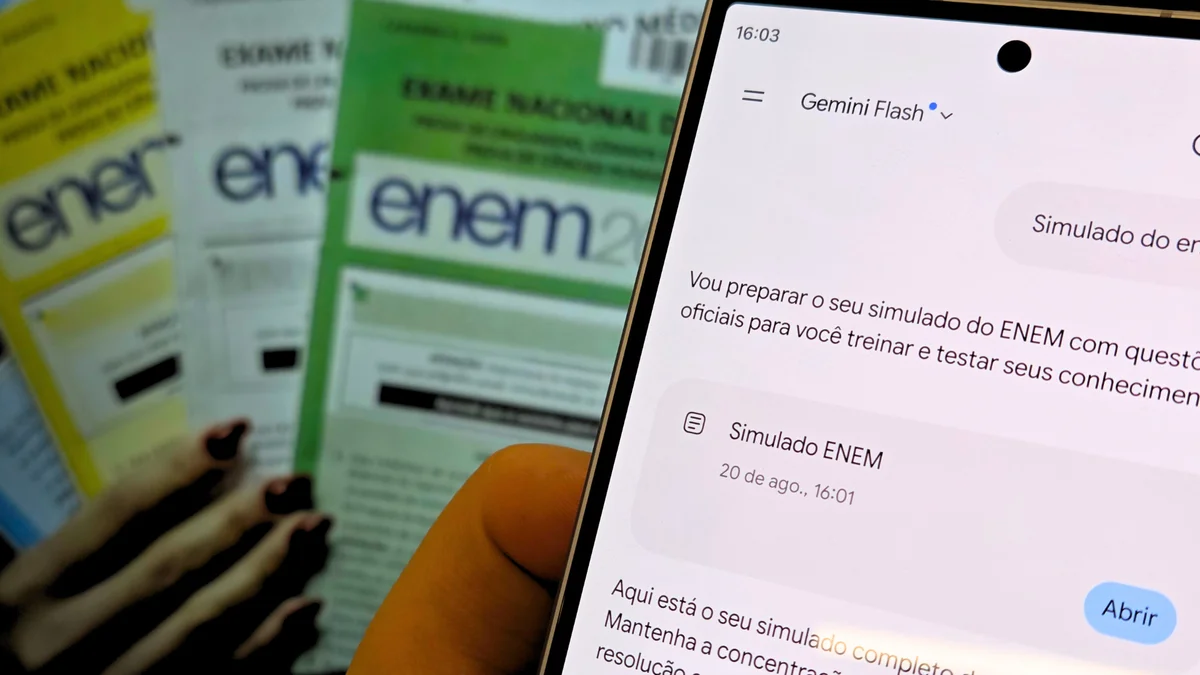
O Google lançou nesta quinta-feira (20) um simulado gratuito e interativo do Enem dentro do aplicativo do Gemini e no Modo IA da Busca. A ferramenta foi criada em parceria com a Akira Enem, edtech brasileira, e mira a preparação para a prova de 2026.
O estudante pode treinar questões de múltipla escolha em simulados completos ou por blocos de área, com acesso no celular e na versão desktop. Antes de começar, é possível ajustar dicas durante a resolução, feedback imediato de acertos e erros e a exibição de cronômetro; ao final, o Gemini entrega diagnóstico com pontos fortes e o que precisa de mais atenção, além de permitir revisão detalhada das questões erradas e um plano de estudos direcionado.
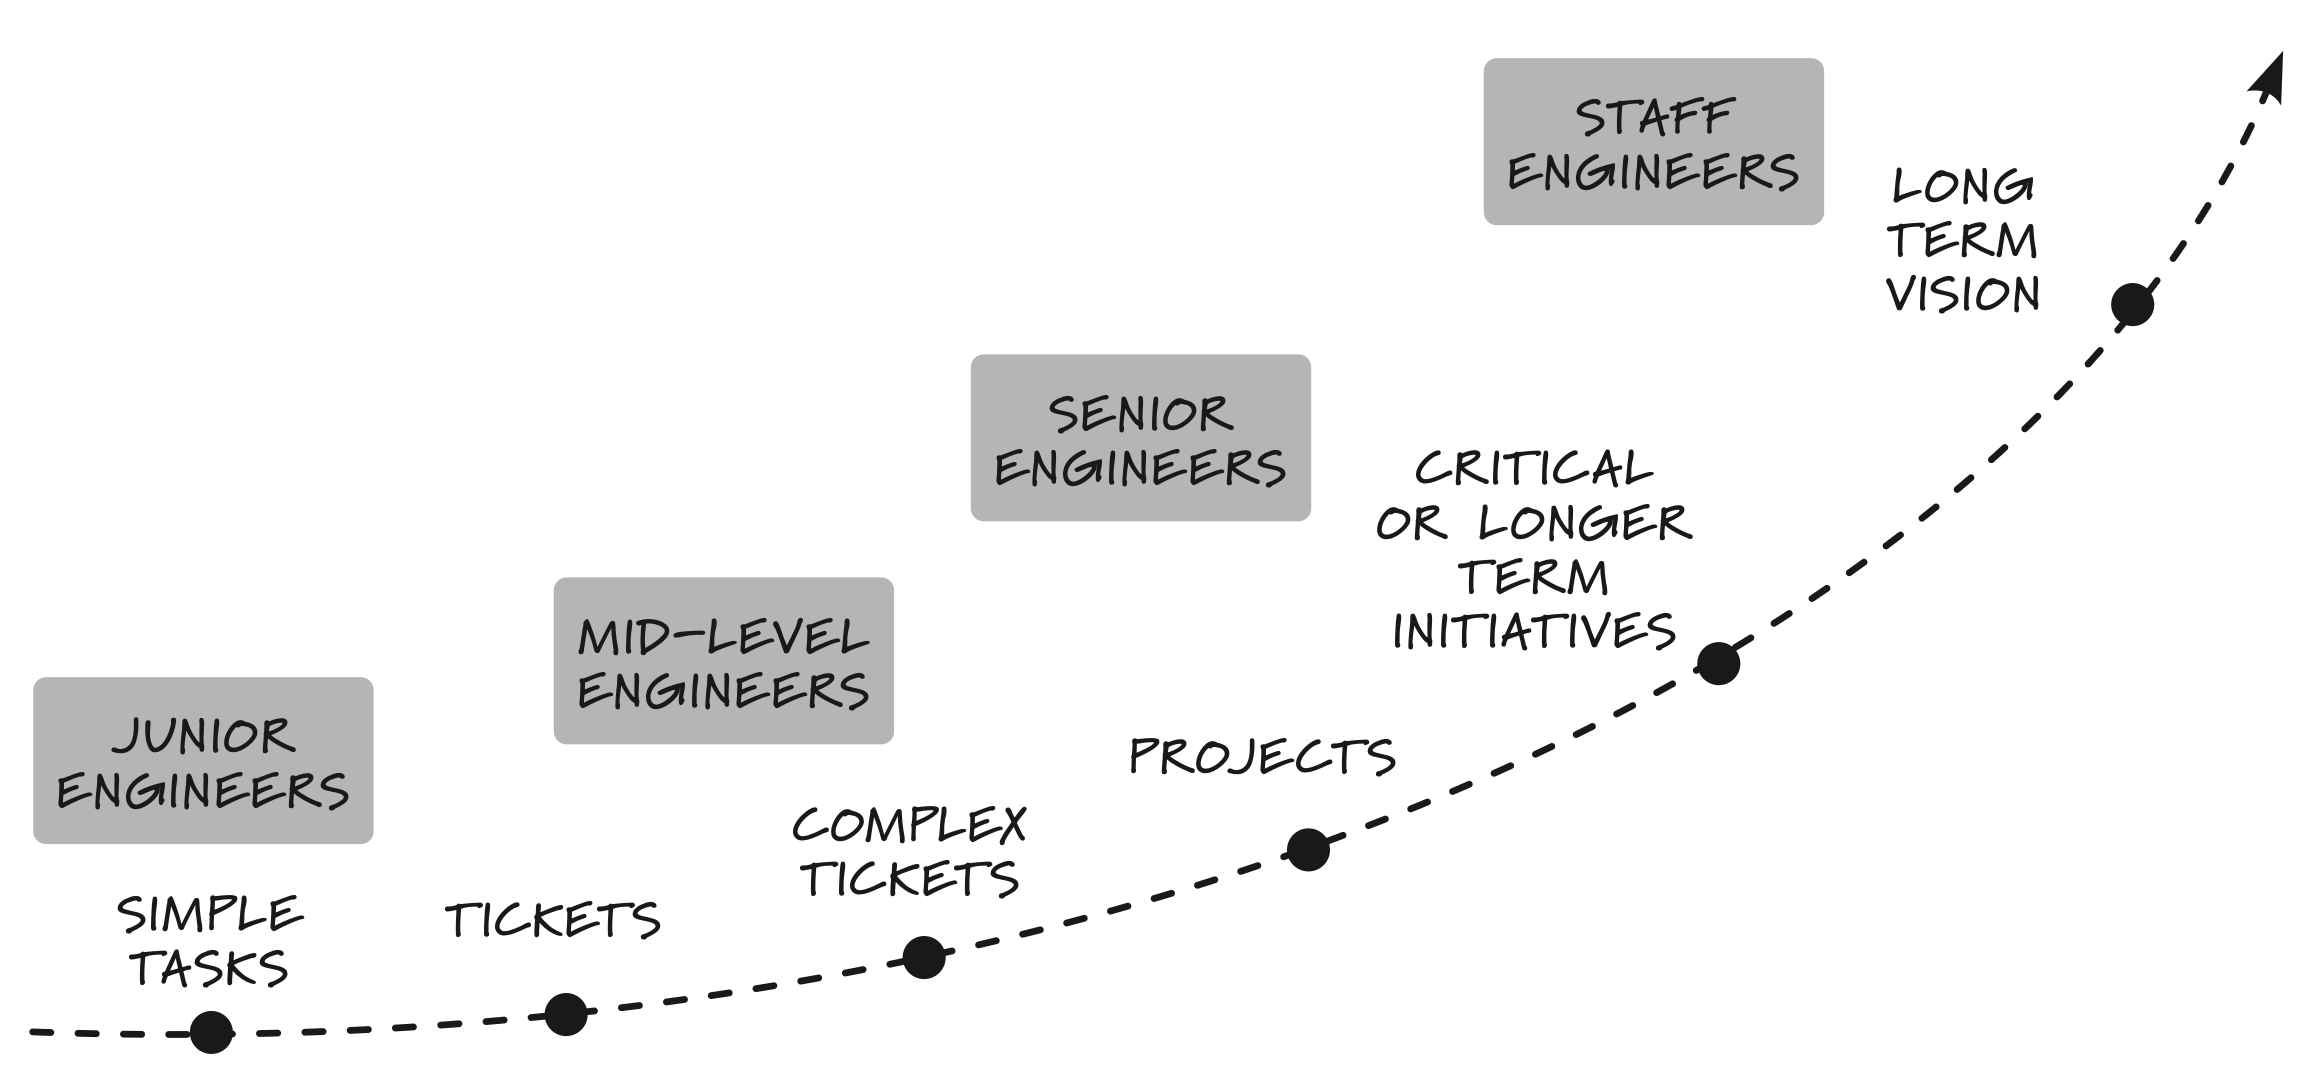
A discussão sobre o papel de engenheiros juniores ganhou um novo argumento: em vez de “apagar” o valor do júnior, a IA pode ampliar sua contribuição. O texto descreve um fluxo em que tarefas antes executadas por um júnior passam a envolver prompts para ferramentas de IA e iterações com feedback até a entrega.
Para ilustrar, o autor relata um caso interno em que um estagiário liderou o desenvolvimento de uma funcionalidade pedida há anos, mas não priorizada. Com apoio de IA, o estagiário conduziu o entendimento com o product manager, escreveu o design, lidou com trade-offs e entregou a solução, mostrando que o julgamento técnico e o contexto do problema continuam sendo centrais.
Na RSA Conference, um painel sobre segurança de código com GenAI destacou que o “security debt” acumulado pode estar chegando ao limite ao mesmo tempo em que a geração de código por IA acelera o desenvolvimento. Dave Aitel, da OpenAI, afirmou que a indústria está diante de um “vulnpocalypse”, com décadas de dívida técnica em segurança se acumulando e “vindo à tona” de uma vez.
O debate também apontou que o ritmo do chamado “vibe coding” — em que equipes escrevem prompts e aceitam o que a IA gera — comprime descobertas de falhas que antes levariam anos. Pesquisas citadas no painel indicam que 82% das organizações carregam security debt em 2026, e as equipes que lidam melhor com o problema investem antes, embutindo testes e feedback rápido no fluxo de desenvolvimento para corrigir vulnerabilidades em minutos.
Arquitetura evolutiva usa fitness functions para transformar intenção arquitetural em feedback executável contínuo, com checagens determinísticas como regras de dependência, testes de contrato, limites de latência e varreduras de segurança. O texto aponta que nem toda preocupação arquitetural cabe em regras, limiares ou métricas, como quando mudanças passam nos testes, mas geram acoplamento acidental ou “drift” semântico.
Nesse contexto, surgem as agentic fitness functions: uma camada de governança em que um agente de IA, calibrado com registros de decisão, metadados de ownership, limites de serviço e rubricas, avalia evidências delimitadas e devolve um veredito estruturado com score, confiança, justificativa e orientação de escalonamento. A proposta separa gates determinísticos de sinais consultivos do agente, aplica rubricas versionadas e encaminha casos de baixa confiança ou alto impacto para revisão humana.
Promoções corporativas raramente dependem só de executar bem as tarefas do cargo; à medida que a carreira avança, pesam habilidades como resolver problemas, tomar decisões e gerar resultados além da função. Nesse contexto, o domínio estratégico da inteligência artificial é apontado como diferencial para automatizar atividades, analisar informações com mais rapidez e redesenhar processos. O texto destaca que não basta conhecer ferramentas como ChatGPT, Gemini ou Claude: é preciso escolher onde a IA entra, avaliar a confiabilidade dos resultados e integrar a tecnologia ao fluxo de trabalho.
A adoção planejada pode mudar a percepção de gestores ao reduzir horas de trabalho manual, melhorar processos e organizar informações antes dispersas. Exemplos citados incluem relatórios que passam de dois dias para algumas horas e usos em áreas como marketing, para analisar feedbacks e identificar padrões, e finanças, para automatizar etapas de tratamento de dados e criar análises preliminares. A competência mais valorizada, segundo o conteúdo, é identificar oportunidades de valor, medir resultados e registrar experimentos antes e depois da implementação.
O artigo discute como avaliar coding agents, respondendo a uma divergência com uma “software factory” que defendia que esses agentes não poderiam ser avaliados. O texto argumenta que o agente não é apenas um modelo: o resultado depende do conjunto modelo + harness + ferramentas + contexto do repositório + instruções + permissões + ambiente de execução e do loop de feedback. Por isso, benchmarks públicos podem medir combinações específicas e não apenas o modelo subjacente.
A avaliação, segundo o autor, deve ir além de “passou nos testes”, incluindo checagens como build, testes públicos e hidden, compatibilidade de APIs e formatos, migrações, limites de desempenho e segurança, além de verificar alterações fora do escopo permitido. Também é necessário repetir execuções para lidar com não determinismo e usar camadas como qualidade da mudança, trajetória, intervenção humana, custo e impacto em produção, porque um único número não captura tudo.