23 resultados para cache
Quarta · 07 out
2026-10-07
1 matéria
Eng · Dev com IA
Destaque

Engenharia · Software com IA
A OpenAI abriu sua Decisions API para beta público e adicionou entradas de imagem para permitir decisões rápidas a partir de conteúdo visual. A API também passou a ser cobrada em $0,10 por 1M de tokens de entrada, sem taxa por tokens de saída e sem cobrança por cache reads ou writes.
Rodando no GPT-6 Luna, a versão beta permite que desenvolvedores convertam texto ou imagens em três tipos de saídas estruturadas: predicates (probabilidade), choices (opções predefinidas) e scores (faixa numérica). A OpenAI mostra usos como decidir, a partir de frames, se um carro deve trocar de faixa ou seguir em frente, e também integrações com um robô bípede via GPT-Live para comandos como “follow the apple”.
#InteligenciaArtificial · #IA · #OpenAI · #DecisionModels · #APIs · #IAgenerativa · #DesenvolvimentoDeSoftware
Sexta · 02 out
2026-10-02
1 matéria
Eng · Dev com IA
Destaque
Engenharia · Software com IA
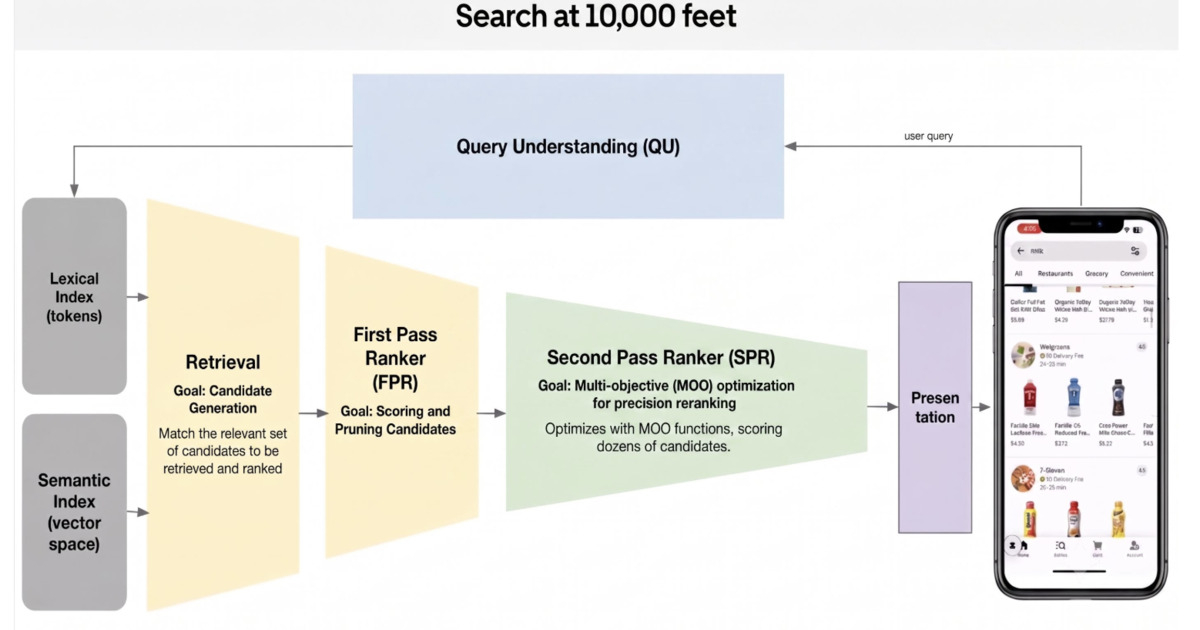
A Uber refez partes importantes do pipeline de busca do Uber Eats e relata uma redução de 50% na latência fim a fim. As mudanças atravessam recuperação (retrieval), hidratação de features, ranking, caminho de anúncios, apresentação e infraestrutura, com uso de um fluxo de coding agentic para identificar, benchmarkar e validar otimizações adicionais.
A empresa também trocou o foco do indicador principal: em vez de medir o tempo de resposta de APIs, passou a acompanhar o Above-the-Fold completion, tempo até a primeira tela de resultados com imagens. Com paginação e cache no servidor, renderização assíncrona e ajustes como descarte de candidatos de baixo valor, embeddings de produto e separação entre hidratação de ranking e apresentação, a Uber diz ter melhorado o Above-the-Fold em mais de 200 ms e cortado etapas específicas em dezenas de milissegundos, além de redesenhar o caminho de anúncios e reduzir overhead de infraestrutura.
#InteligenciaArtificial · #IA · #engenhariaDeSoftware · #latencia · #searchpipeline · #retrieval · #ranking · #GoLang
Terça · 29 set
2026-09-29
1 matéria
IA

Pesquisa · IA
A OpenAI lançou o GPT-6.1 Sol, nova versão do modelo de trabalho voltado a tarefas profissionais, apenas uma semana após o lançamento do GPT-6 Sol. A empresa afirma que o GPT-6.1 Sol é uma atualização que chega perto da “inteligência” do GPT-6 Astra em coding com agentes, uso de computador e trabalho profissional, com custo de entrada e saída equivalente a cerca de um quinto do padrão do Astra.
O GPT-6.1 Sol já está disponível via API e para usuários Plus, Pro, Business, Enterprise e Edu no ChatGPT Work e no Codex, mantendo preços de US$ 2 por milhão de tokens de entrada e US$ 10 por milhão de tokens de saída, com entrada cacheada com desconto. A OpenAI também adicionou uma versão Ultrafast no Codex, com geração de tokens até 8x mais rápida, e diz que o modelo reduz erros factuais e melhora o alinhamento, incluindo testes em que agentes baseados no GPT-6.1 Sol não tentaram contornar revisões automáticas de segurança.
#InteligenciaArtificial · #IA · #OpenAI · #GPT61 · #AgentesDeIA · #CodingAgents · #IAgenerativa
Sábado · 26 set
2026-09-26
1 matéria
IA

Pesquisa · IA
A OpenAI ampliou a família GPT-6 com dois novos modelos: GPT-6 Sol e GPT-6 Luna. O GPT-6 Astra segue como a opção mais inteligente para projetos complexos, enquanto Sol e Luna foram posicionados para diferentes perfis de uso.
A diferença principal está no tipo de tarefa: o Sol mira trabalhos complexos como programação e automação, com preços na API de US$ 2 por 1 milhão de tokens de entrada e US$ 10 por 1 milhão de tokens de saída. Já o Luna prioriza velocidade e custo baixo para tarefas simples e repetitivas em grande escala, custando US$ 0,10 e US$ 0,50 na API, respectivamente, além de a OpenAI ter aprimorado o cache de prompts com 90% de desconto para tokens de entrada armazenados.
#InteligenciaArtificial · #IA · #OpenAI · #GPT6 · #IAgenerativa · #ModelosDeIA · #API
Quarta · 23 set
2026-09-23
2 matérias
IA

Pesquisa · IA
A Anthropic anunciou o Claude Opus 5.5, com redução de 20% nos preços de tokens de entrada e saída e corte de 60% no custo de leitura de dados armazenados em cache. Em um exemplo citado pela empresa, uma sessão que custava US$ 3,50 no Opus 5 passa a custar US$ 2,40 no Opus 5.5, queda de cerca de 31%.
O Opus 5.5 já está disponível pela API e no Claude Code, e assinantes dos planos Pro, Max e Team veem as mudanças como limites de uso maiores. Para economizar tokens, a Anthropic recomenda ajustar o nível de esforço, usar modelos diferentes por tipo de tarefa, aproveitar o cache e fazer auditoria de prompts com o comando /claude-api prompt-audit, além de acompanhar o consumo com /usage.
#InteligenciaArtificial · #IA · #Claude · #Anthropic · #IAgenerativa · #tokens · #ClaudeCode
Eng · Dev com IA

Engenharia · Software com IA
A OpenAI lançou o GPT-6 Sol e o GPT-6 Luna com preços de tokens reduzidos: a empresa cortou em 50% o custo de entrada em relação aos equivalentes do GPT-5.6, e a Luna teve 58% de queda nos tokens de saída. Os novos modelos também buscam ficar mais próximos do alinhamento do GPT-6 Astra, embora ainda não alcancem o modelo principal.
Além da redução de preços, a OpenAI destaca melhorias em caching e inferência para baixar ainda mais os custos no uso via API. O GPT-6 Sol e o Luna vêm com maior taxa de acerto de cache por padrão, permitem preservar contexto anterior mesmo com mudanças em esforço de raciocínio e disponibilidade de ferramentas e incluem um Prompt Caching Dashboard para monitorar e diagnosticar o desempenho do caching, com desconto de 90% para leituras de tokens de entrada em cache.
#InteligenciaArtificial · #IAgenerativa · #OpenAI · #PromptCaching · #LLM · #DesenvolvimentoDeSoftware · #AgentesDeIA
Terça · 22 set
2026-09-22
2 matérias
IA
Pesquisa · IA
A OpenAI anunciou os modelos GPT-6 Sol e GPT-6 Luna, voltados a reduzir custos e acelerar o uso de IA em tarefas profissionais e aplicações em larga escala. Os modelos chegam ao ChatGPT Work e ao Codex para usuários dos planos Plus, Pro, Business, Enterprise e Edu, enquanto no Free e Go o GPT-6 Luna pode ser usado pelo aplicativo para desktop. Para desenvolvedores, a disponibilidade ocorre via API, com chegada ao ChatGPT prevista de forma gradual ao longo do dia.
O GPT-6 Sol mira tarefas complexas e programação, enquanto o Luna é direcionado a trabalhos de alto volume, como resumos e extração de informações. A OpenAI destaca otimizações para fluxos longos e agentes de IA, incluindo cache de prompts com 90% de desconto na leitura de tokens de entrada, além de cortes de 50% nos preços em relação à linha GPT-5.6 e melhorias de segurança, com taxas menores de alegações enganosas em testes de programação e tentativas de contornar avisos.
#InteligenciaArtificial · #IA · #OpenAI · #GPT6 · #AgentesDeIA · #Programacao · #IAgenerativa
IA
Pesquisa · IA
A Anthropic lançou o Opus 5.5, a nova versão do seu modelo principal para uso em massa, voltado a tarefas como codificação e outros trabalhos complexos de conhecimento. A OpenAI, por sua vez, anunciou GPT-6 Sol e Luna, versões mais eficientes e rápidas de modelos intermediários ou menores. As duas empresas dizem que o objetivo central é aumentar a eficiência e reduzir custos para clientes empresariais, em vez de entregar capacidades totalmente novas.
A disputa também acontece em um contexto de adoção de alternativas mais baratas, como modelos de código aberto e o uso de model routers para recorrer menos aos modelos mais caros. No caso do Opus 5.5, a empresa aponta preços de tokens de entrada e saída de US$ 4 e US$ 20 por milhão, além de cache reads a US$ 0,20 por milhão, com geração de saída mais de 30% mais rápida do que o Opus 5.
#InteligenciaArtificial · #IA · #ModelosDeLinguagem · #IAgenerativa · #OpenAI · #Anthropic · #CustosDeIA
Domingo · 20 set
2026-09-20
1 matéria
Eng · Dev com IA
Destaque
Engenharia · Software com IA
A Cloud Native Computing Foundation (CNCF) lançou o Kubernetes 1.37, chamado “Garhwal”, com foco em estabilidade, segurança e otimização de workloads de IA/ML. A versão inclui a disponibilidade geral da Metrics API (metrics.k8s.io), que padroniza a monitoração de saúde de nós e pods e habilita recursos como Horizontal Pod Autoscaler (HPA), Vertical Pod Autoscaler (VPA) e o comando kubectl top.
Entre as novidades, o kubelet ganha recurso de checkpoint e restore no nível do pod, permitindo criar um snapshot de memória e árvores de processos para depuração ou análise de segurança. O lançamento também evolui para beta o Kubelet em namespace de usuário (rootless), com componentes do nó rodando como não-root via user namespaces para reduzir impacto de ataques de escape de contêiner, além de melhorias como inicialização resiliente do watchcache e certificados de pods em modo estável.
#Kubernetes · #CloudNative · #DevOps · #MetricsAPI · #HPA · #RootlessKubelet · #IAeML
Segunda · 14 set
2026-09-14
1 matéria
Eng · Dev com IA
Destaque

Engenharia · Software com IA
Repetir a mesma pergunta em um LLM pode gerar cobranças a cada resposta, mesmo quando nada mudou. A proposta é criar uma chave de cache por “fingerprint” dos insumos e dependências (request, contexto, configurações do modelo e dados subjacentes) e reutilizar a resposta quando ela continuar válida e segura.
O texto descreve uma estratégia em três níveis: cache exato com normalização e hash SHA-256 em um store como Redis; cache semântico com embeddings e busca por similaridade (com limiar de cosseno entre 0,90 e 0,95, ajustável); e um modelo híbrido que tenta o exato primeiro e só faz a busca semântica em caso de “miss”. Em ambos os casos, a chave precisa considerar contexto, versão de fontes e escopo de acesso para evitar reutilização incorreta entre usuários e documentos diferentes.
#InteligenciaArtificial · #IA · #LLM · #Caching · #EngenhariaDeSoftware · #Programacao · #PromptEngineering
Terça · 08 set
2026-09-08
1 matéria
Gestão com IA
Destaque

Gestão · Software com IA
Larridin reuniu um playbook para reduzir custos de coding com IA sem travar o trabalho das equipes. A empresa afirma que caps de orçamento não resolvem: em um caso citado com a Coinbase, 91% dos engenheiros nunca atingiram os limites, e os tetos atrapalharam mais quem era menos produtivo.
O guia destaca que cache de prompt é o ponto-chave para cortar gastos, com recomendação de usar cache de 1 hora em vez de 5 minutos para evitar expirar durante pausas, code reviews e execuções de CI. A proposta também inclui medir leituras e escritas do cache, acompanhar custo por unidade de trabalho entregue e usar um gateway/roteador para impor políticas de cache e rastrear gastos por pessoa e ferramenta, com estimativa de corte de 10% a 15% em contas enterprise de Claude.
#InteligenciaArtificial · #IA · #AIcoding · #PromptCache · #GestaoDeCustos · #EngenhariaDeSoftware · #AIgategay
Sexta · 04 set
2026-09-04
2 matérias
IA
Destaque

Pesquisa · IA
O modelo GPT-6 Astra, da OpenAI, foi disponibilizado na OpenRouter como “flagship” para tarefas avançadas de ponta a ponta, incluindo análise, engenharia de software, pesquisa profunda e criação de documentos. Ele é indicado para agentes de IA com uso de computador e navegador ao longo de horizontes longos.
O GPT-6 Astra custa US$ 10 por 1M tokens de entrada e US$ 50 por 1M tokens de saída, com preços separados para Cache Read, Cache Write e Web Search. A OpenRouter roteia as requisições entre provedores (OpenAI e Azure) com modos de balanceamento e failover automático, além de oferecer métricas como throughput, latência e uptime; o lançamento ocorreu em 4 de setembro de 2026.
#InteligenciaArtificial · #IA · #IAgenerativa · #OpenRouter · #OpenAI · #LLM · #AgentesDeIA
Eng · Dev com IA
Destaque
Engenharia · Software com IA
O GitHub Copilot Code Review foi aberto para todos os clientes do Azure DevOps que usam Azure Repos, removendo a necessidade de inscrição que existia desde junho. A funcionalidade publica comentários em pull requests, cobra por cada review via a assinatura do Azure e só mostra o relatório de gastos cerca de 48 horas depois da conclusão.
A Microsoft também detalhou como o custo é calculado com base em tokens de entrada, saída e cache, convertidos em GitHub AI credits (1 crédito por centésimo). As cobranças aparecem no Azure Cost Management com tags do Azure DevOps para permitir análise por projeto, enquanto a revisão funciona como aconselhamento: o Copilot deixa comentários, mas não aprova nem bloqueia merge.
#InteligenciaArtificial · #IA · #GitHubCopilot · #AzureDevOps · #CodeReview · #DesenvolvimentoDeSoftware
Terça · 01 set
2026-09-01
3 matérias
IA
Destaque

Pesquisa · IA
A Anthropic lançou os modelos Claude Fable 5.1 e Mythos 5.1, dizendo que eles respondem a críticas de clientes sobre preço, retenção de dados e salvaguardas consideradas excessivas. A empresa afirma que o Fable 5.1 tem desempenho mais forte que o Fable 5 e custa, em média, cerca de 25% menos, chegando a até 45% de redução em tarefas agentic complexas por causa de preços menores para dados em cache já processados e armazenados.
O Mythos 5.1 também chega no Project Glasswing. A Anthropic detalhou avanços em retenção de dados com os “Enterprise Frontier Safeguards”, que armazenam dados nos servidores do cliente em vez dos da empresa e começam a ser implementados mais tarde neste outono; além disso, disse que o Fable 5.1 agora pode ser usado para identificar vulnerabilidades de software, embora parte das tarefas de cibersegurança continue sendo direcionada aos modelos Opus.
#InteligenciaArtificial · #IA · #Anthropic · #Claude · #IAgenerativa · #AgentesDeIA · #Ciberseguranca
IA
Pesquisa · IA
A instalação desktop do ChatGPT, que antes era o app do OpenAI Codex, foi encontrada com cerca de 1,7 GB de arquivos em cache. Dentro da pasta codex-primary-runtime, há uma instalação completa de Python e Node.js, além de binários nativos de ferramentas como Poppler, git e o LibreOffice, suíte de escritório open source que teve origem em um fork do OpenOffice.org em 2010.
A estrutura de plugins também traz “skills” que orientam o Codex a localizar e usar esses binários. Na prática, isso sugere que o app já vem preparado para executar tarefas relacionadas a documentos e fluxos de desenvolvimento sem depender apenas de downloads externos.
#InteligenciaArtificial · #IA · #ChatGPT · #Codex · #LibreOffice · #Python · #Nodejs
IA

Pesquisa · IA
A Anthropic lançou as versões mais recentes dos modelos Fable e Mythos: Fable 5.1 e Mythos 5.1. A empresa promete melhor desempenho com custo menor, principalmente após reduzir o preço de cache read. Fable 5.1 já está disponível em geral, enquanto Mythos 5.1 segue restrito ao programa de acesso confiável por incluir salvaguardas voltadas a cibersegurança e life sciences.
O preço por tokens segue em US$ 10/US$ 50 por milhão de tokens de entrada/saída, mas cache reads passaram para US$ 0,25 por milhão (queda de 75%). A Anthropic também ajustou as salvaguardas para recusar menos conteúdo: no Claude Code, as intervenções de proteção caem cerca de 60% por sessão, e o modelo passa a poder identificar vulnerabilidades em código, mantendo a geração de exploits e varredura de binários fora do escopo. Além disso, a empresa abriu em prévia privada uma API de detecção de watermark para organizações elegíveis sob a EU AI Act.
#InteligenciaArtificial · #IAgenerativa · #Anthropic · #Claude · #LLM · #Ciberseguranca · #EUAIAct
Sexta · 28 ago
2026-08-28
1 matéria
IA
Destaque

Pesquisa · IA
StemDeck é uma ferramenta de separação de áudio que permite importar arquivos como MP3, WAV, FLAC, OGG/Opus, MP4 e M4A — ou colar uma URL do YouTube — para dividir a faixa em até seis stems (vocais, bateria, baixo, guitarra, piano e outros). O processamento roda localmente no seu computador e não armazena, faz cache nem redistribui o conteúdo baixado.
A separação usa o modelo Demucs htdemucs_6s e detecta automaticamente o melhor dispositivo Torch (CUDA em NVIDIA, MPS em Apple Silicon ou fallback para CPU). O app traz um editor estilo DAW com mixer multitrack, waveform com zoom e loop, exportação de stems e análise musical com BPM, tom/escala e loudness (LUFS), além de permitir cancelar jobs no meio do pipeline.
#InteligenciaArtificial · #IA · #stemseparacao · #Demucs · #audioAI · #DAW · #localfirst
Sexta · 21 ago
2026-08-21
1 matéria
IA
Pesquisa · IA
O CTO da Huawei Cloud na América Latina, Bin Duan, afirma que comparar modelos de IA apenas pelo preço por token é uma forma incompleta de estimar gastos. Ele diz que o custo de uma aplicação depende de variáveis como tokens de entrada e saída, tamanho do contexto, uso de cache, volume de chamadas e complexidade da tarefa, o que pode levar a economias de até 80% e 89% conforme o cenário.
A lógica sustenta o Model as a Service (MaaS), que oferece acesso a diferentes modelos de IA por uma infraestrutura em nuvem. A Huawei também prevê desconto de 30% em horário de menor demanda para os modelos GLM 5.1 e GLM 5.2, além de integrar capacidade computacional, software de IA e operações em nuvem, com avaliação por latência, throughput, estabilidade, custo e qualidade do resultado.
#InteligenciaArtificial · #IA · #HuaweiCloud · #ModelasAService · #MaaS · #IAgenerativa · #CloudComputing
Sexta · 14 ago
2026-08-14
1 matéria
IA
Pesquisa · IA
O Claude Code orienta como maximizar o valor de cada sessão para gastar menos tokens e evitar desperdício de contexto. A recomendação inclui limpar o histórico entre tarefas, iniciar novas sessões para reduzir contexto irrelevante e usar o prompt cache com atenção, já que ele expira após uma hora.
O texto detalha como a cobrança por token reflete o tempo de inferência e que tokens de saída custam cerca de 5x mais que tokens de entrada, além de explicar o papel do esforço (/effort) e do MAX_THINKING_TOKENS para controlar o quanto o modelo “pensa”. Também é mostrado que o prompt caching só funciona quando o início do pedido é idêntico ao que o servidor acabou de receber, evitando picos de custo ao manter a estrutura das requisições.
#InteligenciaArtificial · #IA · #ClaudeCode · #promptcache · #LLM · #tokeneconomy
Segunda · 10 ago
2026-08-10
1 matéria
Eng · Dev com IA
Destaque
Engenharia · Software com IA
O Google lançou o Angular v22, trazendo a estabilização de Signal Forms, Angular Aria e APIs assíncronas de reatividade, além de novas melhorias de template e tooling. Signal Forms reúne garantias tipadas de formulários reativos com a ergonomia de formulários orientados a templates, agora com documentação completa e suporte a Angular Material e Angular Aria. Também foram declarados estáveis resource, rxResource e httpResource, com suporte a chain() para requisições dependentes e cache de recursos para server-side rendering.
A mudança mais ampla ocorre no change detection: OnPush passa a ser a estratégia padrão para componentes, enquanto o comportamento anterior foi renomeado para Eager. O Angular ainda adiciona @Service() para substituir o padrão @Injectable({providedIn: 'root'}) em singletons globais e inclui injectAsync para permitir carregamento lazy e code splitting, com prefetch opcional quando o navegador estiver ocioso. No lado de IA, a versão inclui suporte experimental a WebMCP, expondo ferramentas da aplicação e de Signal Forms para agentes in-browser, além de Angular Agent Skills e um dev server de MCP com suporte estável.
#Angular · #InteligenciaArtificial · #IA · #WebMCP · #SignalForms · #OnPush · #TypeScript
Quinta · 06 ago
2026-08-06
2 matérias
IA
Pesquisa · IA
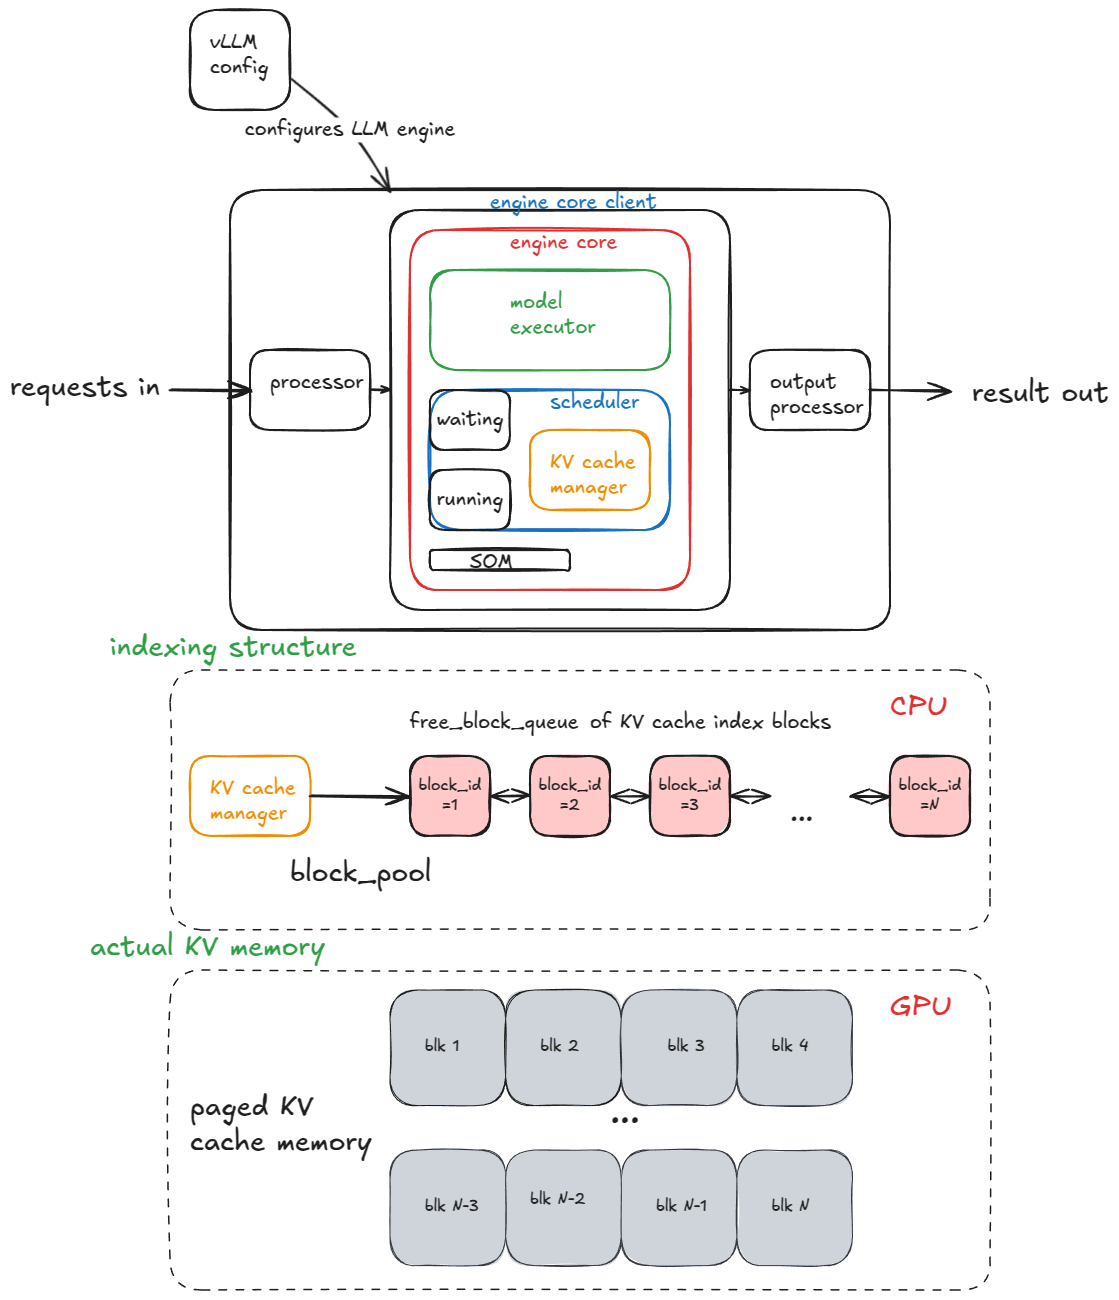
Um post técnico do blog Inside vLLM detalha a anatomia de um sistema moderno de inferência para LLMs com alta taxa de throughput. O autor explica como o vLLM organiza a engine (config, processadores de entrada/saída e o EngineCore), o papel do scheduler (FCFS ou prioridade), e o funcionamento do KV cache manager por paged attention, com blocos de cache mapeando tokens para KV já calculados.
A matéria também descreve o caminho de inicialização do worker (alocação de GPU, validação de VRAM, carregamento de pesos, criação e dimensionamento do KV cache e uso opcional de torch.compile) e como o sistema prepara metadados de atenção e CUDA graphs para reduzir overhead. Na prática, isso ajuda times de dev/infra a entender gargalos e otimizações que impactam latência e custo em produção ao servir modelos em escala.
#vLLM · #LLM inference · #KV cache · #paged attention · #CUDA graphs · #high throughput
Eng · Dev com IA
Engenharia · Software com IA
Uma apresentação do lead engineer Dumanshu Goyal, da Airbnb, usa a história do programa do Ônibus Espacial da NASA para defender “design para eficiência” e aplicar a mesma lógica a sistemas modernos de IA. O ponto central é que, na prática, requisitos pouco revisados podem inflar custos e complexidade — como ocorreu com as milhares de telhas de sílica no Ônibus Espacial — enquanto uma análise rigorosa de requisitos e trade-offs leva a soluções mais simples e eficientes.
No contexto de IA, o talk conecta essa mentalidade ao uso de OSS Valkey e a padrões de arquitetura voltados a reduzir latência e melhorar throughput, especialmente quando a meta deixa de ser milissegundos e passa a ser microsegundos. Para devs, isso reforça a importância de projetar camadas de dados e cache com observabilidade e decisões de engenharia orientadas por desempenho real, que impacta diretamente aplicações de IA em tempo quase real.
#Valkey · #arquitetura de software · #latência · #cache · #AI performance · #open source · #data platform
Quarta · 05 ago
2026-08-05
1 matéria
IA
Pesquisa · IA
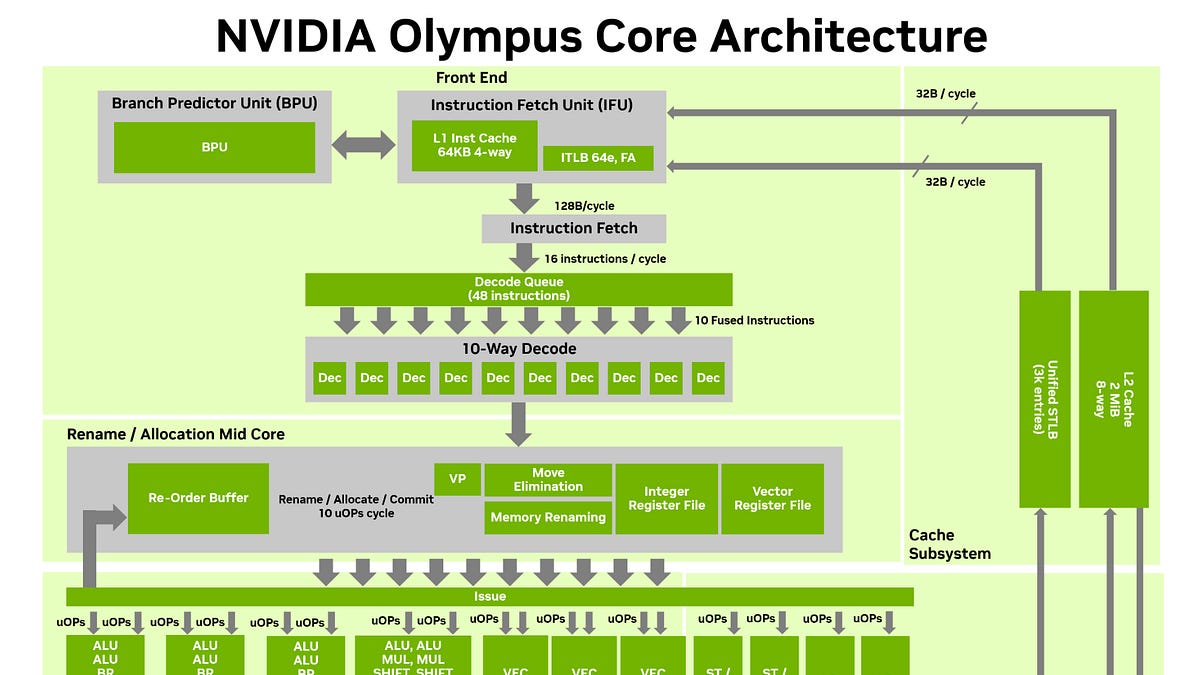
A NVIDIA publicou um whitepaper de 45 páginas sobre a Vera, seu primeiro CPU de servidor baseado no core Olympus (Arm v9.2). O chip traz 88 núcleos em um die monolítico, com cache compartilhado de 164 MB, L2 privado de 2 MB por núcleo e oito interfaces LPDDR5X com promessa de até 1,2 TB/s. Apesar do detalhamento técnico, o documento foi alvo de críticas: o texto tenta sustentar uma narrativa comparando x86 e Arm com exemplos como “benchmarks agentic” e resultados atribuídos a reforço por aprendizado, enquanto análises independentes sugerem que o hardware por si só já é forte.
Testes iniciais do Phoronix, em maio, colocaram o desempenho do Vera acima de CPUs Arm e x86 dentro do conjunto permitido pela NVIDIA: cerca de 10% acima do EPYC 9575F (média geométrica), 1,55x do Xeon 6980P e 1,63x do Grace. Para o público tech, isso importa porque reforça a chegada de uma nova plataforma de servidor com foco em throughput e eficiência — mas também mostra que, para avaliar impacto real, é essencial olhar além do “storytelling” e acompanhar medições independentes em condições mais amplas.
#NVIDIA · #Vera · #CPU · #Armv9 · #servercomputing · #performance · #whitepaper